AI INFRA DAILY 系统 · 工程 · 研究
GPU 直存、训练会话与年度地球表征
日报 ·
- GPU 直存
- 训练会话
- 地球表征
推理路径|存储、删层和运行时一起衡量
uGDS|把 NVMe 请求控制移到用户态
10 月 22 日的 uGDS 论文,将 NVMe 命令构造、队列和完成处理交给用户态 CPU,数据仍经 PCIe P2P 在 SSD 与 GPU 之间移动。它按同步和批量流量分配队列,并管理 DMA 期间的缓冲生命周期;一次性特权初始化仍需要小型内核模块,不能理解成完全绕开内核和权限设置。
应用评估使用 A100-SXM4-40GB、Samsung 990 PRO、Qwen3-0.6B、vLLM 0.20.1 与 LMCache 开发版,对照 NVIDIA GDS。实验关闭 vLLM 内存前缀缓存,强制 SSD-only 完整命中,结论针对缓存恢复路径。单 handle 当前面向单块本地 SSD,多盘与 NVMe-oF 仍属规划。
原仓已有 BSD-3-Clause 代码、驱动和测试,但接入 LMCache 的 PR 已于 8 月 18 日合入 dev;这次的新信号是论文及系统评估,不能写成刚刚完成开源或首次接入。用户态控制可以减少特定 I/O 开销,不能据此推广为任意模型、命中率和存储组合下的统一推理收益。
来源:2026-10-22(论文首提;LMCache 接入早于本次论文),A 级|论文与首提记录 · 控制路径与实验条件 · uGDS 原仓 · 既有 LMCache 接入记录。
深度剪枝|在修复后的候选模型上决定删层
10 月 22 日的层剪枝研究,将“删哪些层”和“如何线性修复”放在同一目标下。Rgs 先对每个候选施加相同的最小二乘修复,再比较质量;Rfs 从完整模型的一次前向与反向结果近似评分。实验表明,修复改变了相邻层之间的交互,未经修复的层重要性不能直接代表最终模型。
评估覆盖五个 1.7B–27B 模型,采用 BF16,通常单张 48GB GPU,27B 使用两张;原文未披露可确认的 GPU 型号。对照 ReplaceMe、SLEB 等时保持修复一致。“精确最优”只针对枚举预算和层分组,主要结果是相同剪枝预算下的质量差别;Gemma 3 每个被移除连续段还需额外保留一个 d × d 修复矩阵,不能统称零参数开销。
来源:2026-10-22,A 级|论文与首提记录 · 候选选择、线性修复与实验范围。
Apple Silicon 推理|优化技巧需要匹配具体负载
10 月 22 日的一项 Apple Silicon 研究,对比 KV 管理、投机解码、GPU kernel 移植和量化,重点检验本地统一内存、batch=1 的解码。投机主比较使用 M2 Pro、M3 Ultra 与 Qwen3-4B,每个实现相对自身自回归基线;不能把运行时差异直接归因于芯片差异。
该主配置没有得到投机解码端到端收益,但论文也给出 M3 Pro 等其他配置的正例。KV 剪枝实验没有同步评估任务质量,megakernel 只覆盖一个模型和一颗芯片,多请求服务尚未验证。可迁移的是对硬件机制和负载条件的分析,不能由单个负结果断言 Apple 上投机解码普遍无效,也不能只看 token 吞吐忽略输出质量。
来源:2026-10-22(UTC),A 级|论文与首提记录 · 完整实验与附加配置。
平台工程|显式维护训练和上下文状态
SageMaker training sessions|用远端操作编写后训练循环
AWS 在 10 月 22 日将 training session APIs 标为 GA。用户在自己的 Python 循环中调用 forward_backward()、optim_step() 和 sample(),模型跨调用保留在 GPU,服务处理分布式执行、恢复与检查点。原始 cookbook 已给出 SFT 和多种 RL 示例,支持的模型、区域及会话并发仍有边界。
会话状态需要调用方正确使用:每个 session 同时只允许一个 TrainingClient,SamplingClient 固定创建时的权重,更新策略后必须重新取得采样客户端。load_state 只恢复权重,要续上优化器则需 load_state_with_optimizer。托管执行减少了 GPU 运维工作,却没有消除 on-policy 采样与精确恢复的状态契约;结束后还需停止占用资源的会话。
来源:2026-10-22,A 级|AWS 原始 GA 发布 · 实际后训练 cookbook;B 级|会话与采样故障排查 · 恢复操作契约 · 模型、区域与配额范围。
Knowledge Catalog|把上下文缺口变成可审阅更新
Google 在 10 月 22 日介绍 Knowledge Catalog 的 self-learning context enrichment 与新版 Knowledge Studio。系统从用户、Agent 交互发现定义缺失或字段歧义,再从文档、代码和元数据提取候选上下文,附来源与置信度。配置阈值后,部分更新可以自动发布,低于阈值或删除等变更进入 Change Request,由 steward 审阅,并保留追溯和回滚。
这是一套上下文维护流程,并非模型自行训练。当前仍是组织需申请准入、未来几周分批推广的受限预览;任务管理以控制台为主,暂未提供对应 REST 或 gcloud 管理接口。该预览也不支持 DRZ 承诺、CMEK、VPC Service Controls 等能力,不能把受管理的 context sets 等同于继承全部既有数据治理保证。
来源:2026-10-22,A 级|Google 原始发布与推广安排;B 级|Knowledge Studio 准入、操作与预览限制。
科研计算|减少局部工作,也控制更新误差
GPU 三角计数|协调本地枚举和跨分区访问
10 月 21 日 UTC 的精确三角计数研究,将边过滤、任务扁平化与不同计数 kernel 配合:本地使用 masked-edge 路径,接收远端边后使用 split-edge 路径。节点间依赖异步 MPI,节点内结合 CUDA IPC、P2P 和多 stream,让本地计算和远端邻接访问共同参与负载划分。
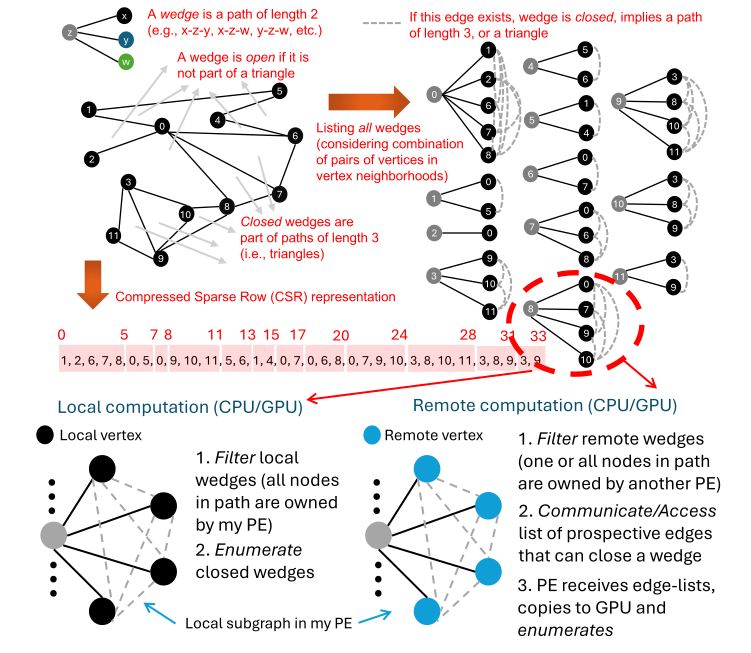
Sayan Ghosh,Enumeration-based Triangle Counting on GPUs 图 1 · CC BY 4.0,原始 SVG 未修改。点击图片查看大图。
实验覆盖 Perlmutter、Polaris 的 A100 节点及 8 卡 DGX A100/H100,对照 TriC、cuGraph、TRUST、GraphMiner。总时间计入计数和通信处理,但排除图加载、CSR 构造;TRUST 还使用较窄索引并少计部分分配和拷贝。GraphMiner 在部分 A100 图上更快,图结构和尾部任务的影响不能由摘要中的最高倍数概括,论文也未给出本实现的明确下载入口。
来源:2026-10-21(UTC;上海时间 10 月 22 日),A 级|论文与首提记录 · 算法、平台与比较口径。
神经材料识别|在训练中更新降阶基和采样元素
10 月 22 日的 hyperreduction 研究,将 POD、能量守恒采样加权 ECSW 与伴随梯度结合。先用全阶 bootstrap 收集快照,再周期性用全阶 canary 检查误差,必要时更新降阶基、采样元素或回到全阶求解,让数值近似随神经材料权重一起变化。
实验包含两组实测数据和一个三维合成问题,使用 JAX 内部实现 ASIMOV,在十核 Apple M4、24GB MacBook Pro 的 CPU 上以 FP64 运行。Case 1 有全阶训练基线,Case 2 没有完整全阶参考,三维案例的全阶训练加速是估计。全阶检查和重编译仍有成本,范围限于各向同性超弹性;匹配反力不代表唯一识别材料,数据公开也仍以正式出版为节点。
来源:2026-10-22,A 级|论文与首提记录 · 自适应降阶、实验基线与数据状态。
跨领域模型|语音修订与年度地球表征
Granite Speech|新增 2B 并修订既有语音模型
近期补充:IBM 在 10 月 21 日公布新增 Granite Speech 5.0 2B 及既有模型修订,其中 2B 实际发布于 10 月 20 日。它面向多语种语音识别和双向翻译,加入语言提示与至多 2,000 个词的关键词偏置;同批 4.1 2B Plus 则更新说话人归属、时间戳和长会话处理。不同模型承接不同任务,这些指标不能混成一项通用语音准确率。
模型按 Apache 2.0 提供,文档给出 Transformers、vLLM、llama.cpp 和 mlx-audio 接入。2B 模型卡在 llama.cpp/GGUF 路径下推荐 Q8_0,并提示更低比特配置会在超过约一分钟的音频上损失准确率;英语短音频的 WER 也不能代替长会话的说话人归属误差和时间戳偏移。部署仍需按语言、音频长度、噪声及量化格式分别核对,不能把同名模型族的历史能力都当作此次新增。
来源:2026-10-20(5.0 2B 模型发布;10 月 21 日集合更新公告),A 级|IBM Granite 团队原始发布 · 5.0 2B 模型卡与量化条件。
OlmoEarth 1.3|先计算年度嵌入,再复用到地图任务
Ai2 在 10 月 22 日发布 OlmoEarth v1.3、预计算年度嵌入与 Embeddings Explorer。模型汇总 Sentinel-1 雷达、Sentinel-2 和 Landsat 时序,输出 10 米位置的 128 维表征,前 64 维也可独立使用。Attention Pooler 先聚合空间、时间和模态 token,再投影到较小维度,使下游分类或回归可以复用已完成的遥感推理。
首发数据中,2023–2025 年覆盖全球产品范围,2017–2022 年仍只有部分国家;该范围不含南极。数据按 Zarr 组织,读取时要处理 nodata 并反量化,provenance 表可追溯输入场景。年度聚合适合跨任务复用,却不能直接充当实时变化告警;新地区、标签和时段仍需验证,模型及数据按 OlmoEarth Artifact License 提供。
来源:2026-10-22,A 级|Ai2 原始发布 · 模型卡与构成 · 技术报告 · 年度覆盖、读取与 provenance。