AI INFRA DAILY 系统 · 工程 · 研究
显存里的验证、可分割 GPU 与跨项目 Agent 目录
日报 ·
- 推理调度
- 平台治理
- 科研计算
推理运行时|把控制和补算放到合适的位置
Raincheck|视觉 token 从舍弃改为延后计算
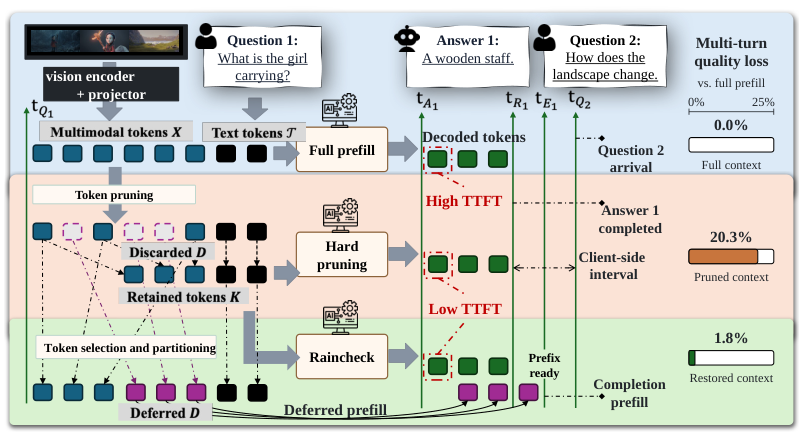
Raincheck 先处理选中的多模态 token,再利用解码及答复后的调度空隙补齐剩余输入,供后续追问复用。全注意力层限制新旧状态的可见范围,混合 GDN 层通过仿射映射修正状态;初始选择因此决定计算时机,而不再永久删掉信息。
单张 H20-3e、单驻留请求的 SGLang 测试,以 Qwen3-VL-8B 和 Qwen3.5-9B、30% 初始保留率回放 MultiVerse 的固定输出轨迹。相对完整预填充,首轮平均 TTFT 分别下降 24.1% 和 17.9%;但视频测试的平均逐 token 用时增加约 19.9% 和 14.9%,即时追问也可能等候补齐。图片负载的小开销不能外推到视频或高并发,生成轨迹也不等价于完整输入重算。
来源:2026-10-29(UTC 首提),A 级|论文与首提记录 · 补齐机制、固定轨迹与视频代价。
WebGPU 推测解码|草拟和接受判断留在 GPU
一项浏览器推理研究将草拟、验证、接受判断和 KV 整理放进 GPU 循环,CPU 按窗口提交工作,减少逐 token 同步回读。草稿来自页面、会话与历史片段的上下文匹配;树宽按设备实测成本调整,避免较弱 GPU 为宽验证树付出更多等待。
Chrome 155 下,GTX 1650 4GB、集成 Radeon Vega 和 RTX PRO 5000 48GB 覆盖七种 0.5B–8B 模型与十一类任务。对 WebLLM 0.2.86 成功完成的同一子集,作者报告解码加速 3.5–8.6 倍,收益同时包含内核、控制循环和推测策略。新内核使用 INT8 激活,基线使用 FP16/FP32;确定性一致仅对应自身量化运行时的 greedy 输出,不能解释为与原始 BF16 检查点完全相同。代码仍计划在发表后开放。
来源:2026-10-29(UTC 首提),A 级|论文与首提记录 · 设备、量化口径与开源计划。
PhOSv1|共享休眠模型的重复 GPU 上下文
PhOSv1 用中央 daemon 接管 CUDA API 调用,共享休眠模型重复的驱动上下文与内核二进制;难以去重的缓冲区留到唤醒时重建。它针对的是多模型待命消耗的显存,让更多模型能够保留快速恢复入口。
单张 A800 80GB、vLLM 0.19.1 的实验中,相对原版 vLLM sleep mode,23 个休眠模型的上下文由 25.67GiB 降至 0.49GiB,这一口径不含模型权重。十模型低流量回放的首 token 收益来自减少冷启动和排队,不能理解成每个算子都更快。实现每 GPU 只运行一个活跃引擎,要求引擎可信,尚不支持 CUDA graphs;公开代码也仍处于预览重构阶段。
来源:2026-10-29(UTC 首提),A 级|论文与首提记录 · 上下文口径与运行限制 · 作者公开仓库。
云平台|资源隔离与目录可见范围需要分别配置
SageMaker|GPU 分区成为端点创建时的容量选择
SageMaker AI 实时端点新增 NVIDIA MIG 分区配置,让不同 inference components 使用固定的 GPU 计算片与显存。发布支持 P4d、P5、G7、G7e,调用继续指定 inference component 名称;较小模型可以在同一 GPU 上获得明确的分区容量。
布局不能在线修改,换分区需要创建新端点;同机 CPU、主内存、存储和网络仍然共享。目前分区端点提供调用量与时延指标,不发布 GPU、CPU 或内存利用率指标。公告未给同负载成本实验,实际容量仍需结合实例、区域、配额和观测能力验证。
来源:2026-10-30,A 级|AWS 原始公告;B 级|分区配置、共享资源与指标限制。
Agent Registry|跨项目发现与调用授权分开配置
Google Cloud Agent Registry 的跨项目管理边界进入 Preview,将成员项目的 agent、MCP server 和 tool 目录集中到 management project。组织或文件夹边界可配合 tag 筛选成员,用统一目录搜索和治理多个项目的资产;本次预览针对管理边界,基础 Registry 服务已于 6 月正式可用。
Registry 角色管理的是目录资源与发现权限。经 Agent Gateway 访问目标时,仍须在目标资源向 agent principal 授予 IAP-secured Egressor。管理项目的 viewer 能搜索其所有已附加边界中的成员资产,无需逐个成员项目的 viewer;团队必须互相不可见时,需拆开 CapabilityConfig 与管理项目。统一目录同时改变元数据可见范围,不能据此推断调用已经获批。
来源:2026-10-30(跨项目边界预览),A 级|Google Cloud 发布记录;B 级|边界拓扑与可见性 · 发现和实际访问的权限。
科研计算|先确认互补条件,再解释拟合结果
GPU–WSE|异构收益依赖工作阶段和批量
近期补充:10 月 29 日 UTC 首提的异构系统研究,分别在 Cerebras WSE-3 与 DGX A100 集群测量,再以校准后的 SimAI 离散事件模拟组合执行。7B–70B 模型覆盖数据/流水并行训练与 prefill/decode 分离推理,研究证据尚不是整合异构集群的端到端实测。
统一 micro-batch 为 1、global batch 为 1024 的标准流水并行比较中,所测异构配置均未胜过单平台;允许两端不同微批量后,部分组合才出现收益。推理拆分更能利用两个平台在不同阶段的差别,但固定设备比例也会随请求形状变化而失配。采购和调度需要匹配工作阶段、批量及互连,峰值算力相加不足以预测收益。
来源:2026-10-29(02:42 UTC 首提,近期补充),A 级|论文与首提记录 · 实测校准、模拟与异构配置。
织物本构发现|用实验选择稀疏材料公式
一项材料建模研究从 TPU 涂层尼龙织物的双轴拉伸数据,同时选择本构公式和参数。受连续介质力学约束的 CANN 得到一项各向同性、两项各向异性贡献的稀疏超弹性模型,为有限元计算提供可解释的材料关系。
三个经纬拉伸比例为 1:1、1:2、1:3,实验曲线平均拟合 R² 约 0.97;这是已测曲线的拟合,不能当作独立留出或新织物泛化。多个候选项高度相关,重复初始化可得到接近的响应,但公式并不唯一。研究未覆盖离轴、弯曲与循环耗散,也未证明软机器人已经部署这些模型。
来源:2026-10-29(UTC 首提),A 级|论文与首提记录 · 双轴实验、拟合范围与模型局限。
端侧与轨道|接口可替换之后,运行证据仍要落到设备
AnySpeechRecognizer 与 AnyDecisionModel|保留类型,选择引擎
近期补充:Mattt 在 10 月 29 日联合发布两个 Swift 包。AnySpeechRecognizer 沿用现代 Speech API 的分析和资产管理方式,增加本地 Core ML 引擎及说话人分离;AnyDecisionModel 从模型概率返回类型化选择或评分,减少生成文本再解析的步骤。
接口一致不代表流式能力相同:Parakeet 支持中间结果和词级时间,Qwen3-ASR 则按最长 40 秒片段返回最终结果。包要求 Swift 6.2 及相应系统版本,部分本地引擎还要求 Apple Silicon;作者的 M4 Max 测量不能替代 iPhone 验收。决策概率也需要目标数据校准,分布集中度不能直接当作答对的概率。
来源:2026-10-29(联合发布,近期补充),B 级|作者发布与校准说明;A 级|语音包原仓库 · 决策包原仓库。
Suncatcher|轨道 TPU 首次回传生成结果
Google 报告原型卫星上的数据中心级 TPU 已运行 Gemma 4,并在地面站过境时回传对提示的生成结果。此前完成的上电和早期机器学习测试,进入了可观察的模型响应阶段。
后续仍要测试热应力与辐射环境,互联双星里程碑安排在 2027 年。首次输出证明原型负载可以执行任务,尚不足以证明长期可靠性、多星互联吞吐或轨道 AI 服务已可商用。
来源:2026-10-30,A 级|Google 原始进展与后续测试计划。