AI INFRA DAILY 系统 · 工程 · 研究
会话感知调度,把工具等待也算进工作集
日报 ·
- 会话调度
- Agent 平台
- 设备运行时
推理调度|状态如何组织,决定优化可以发生在哪一层
TokenRouter 将单个请求的 token 级模型切换逻辑与执行组织分开:开发者描述请求如何在模型间转移,运行时为每个模型组织异步子服务器,并保留切换时的服务状态。它通过短暂延迟 batching 聚合同模型请求,等待阈值由吞吐模型计算。
作者在 8 张 A100-80GB 的服务器上,以 Qwen3 小、大模型和 AIME、SWE-Smith 工作负载比较不同路由算法的执行。编辑判断是,多模型服务应把路由策略与批处理执行分别测量,避免把调度开销误归为模型能力。论文优化的是已选算法的执行效率,并不证明路由质量必然提高;阈值依赖并发、转移概率和模型步时,吞吐最优也不能替代尾延迟验收。
论文首提交:2026-10-08(UTC)。来源 A 级:TokenRouter 原论文。
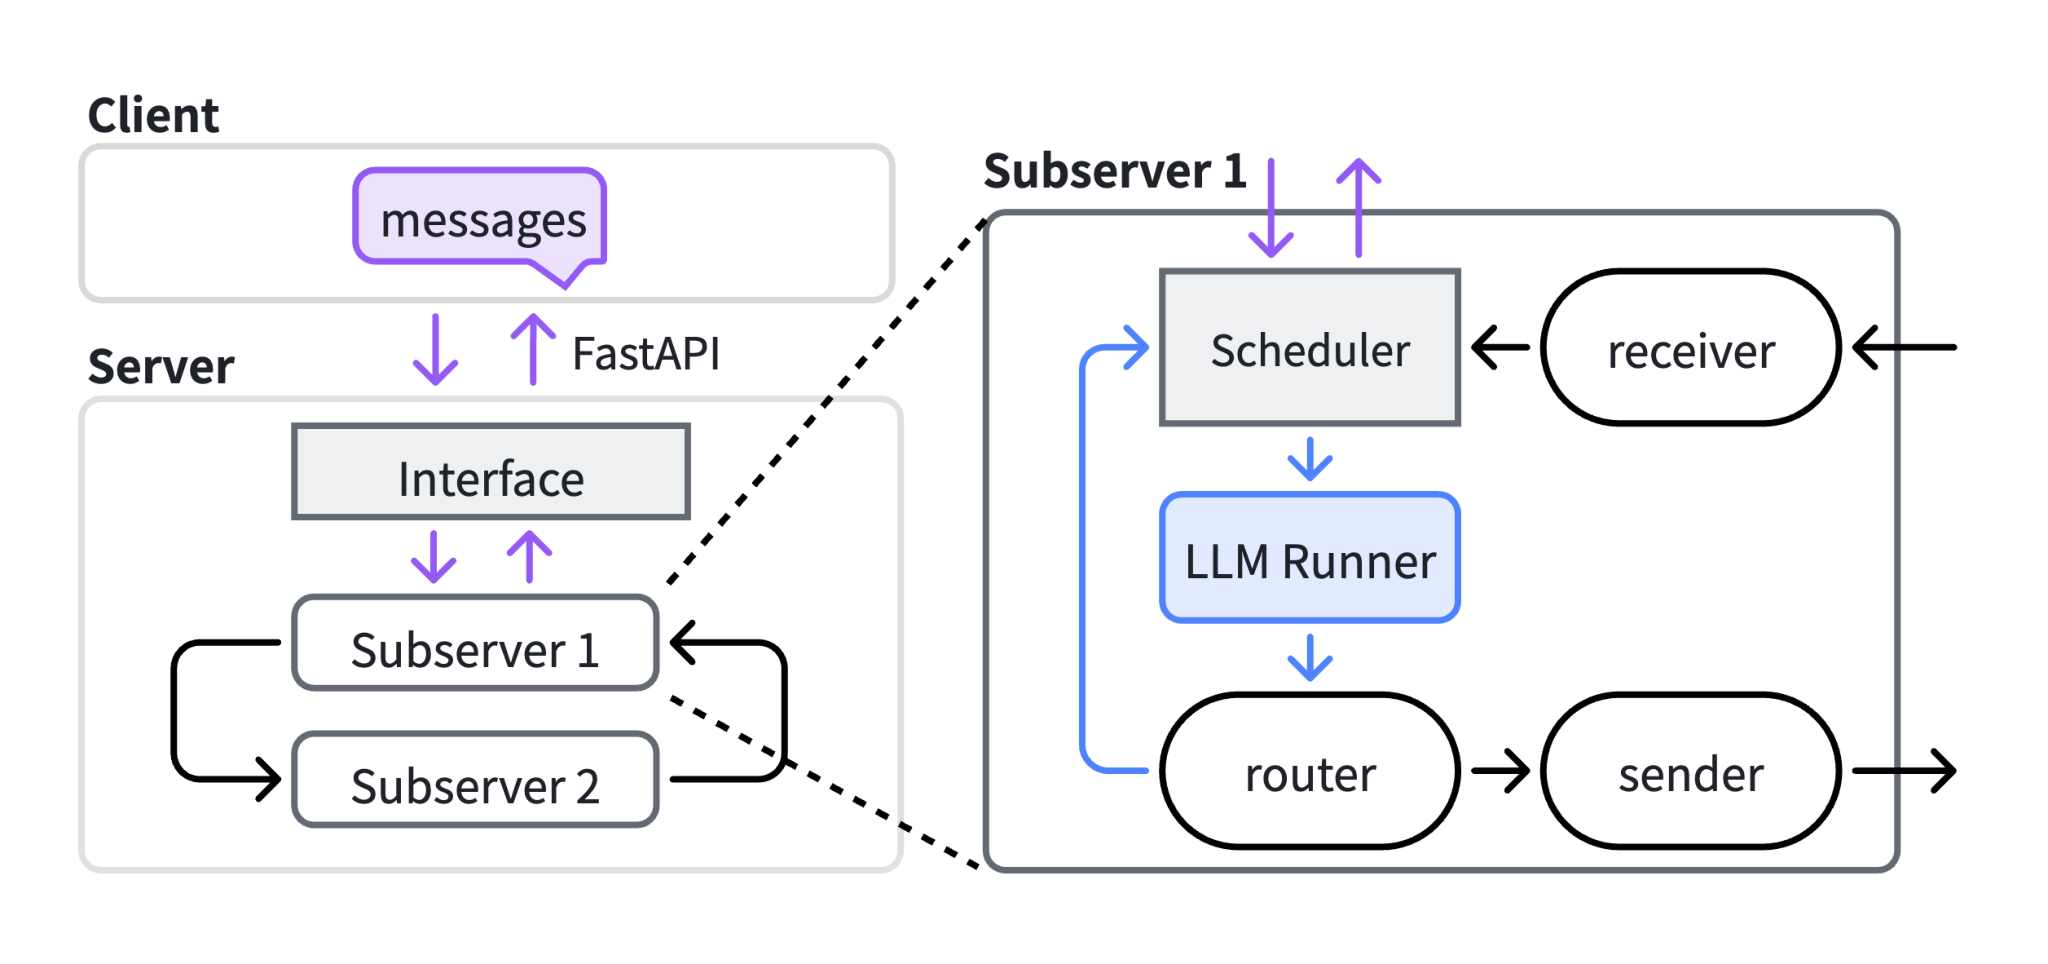
Tianyu Fu 等,论文图 2(b) · CC BY 4.0,原图未修改。点击图片查看大图。
Dynamo 的会话感知工程沿另一种状态边界组织服务:统一 session ID 连接 harness、路由、准入控制、KV cache 与重放轨迹。调度器在工具调用边界对会话施加 backpressure,内存紧张时逻辑暂停进入 ACTING 的会话,允许正在生成的回合完成;同一轨迹可以驱动离线模拟和真实 GPU 重放。
对推理平台的启示是,工具执行期间的缓存占用也属于工作集,单请求路由看不到完整任务的驻留成本。文章包含指定 H100、H20-3e 节点和模型负载验证,不能外推为所有 Agent 服务的收益;共享 KV pool indexer 仍属实验组件,KvHint 是提案与实验方向,Share 有工作实现,Prefetch、Demote 尚依赖后续落地,应逐项核对组件状态。
发布日期:2026-10-08。来源 B 级:NVIDIA 团队的 Dynamo 官方工程材料。
CoMoE 则把状态组织推进到通信拓扑。在论文所测的消费 GPU 场景中,跨卡数据经主机内存中转,作者让主机成为主动路由中心:发送卡将共享 token 写入主机一次,接收卡并行拉取;combine 使用逐 token staging,让已完成结果继续流动,减少全局 barrier 的等待。
其 RTX 5090、A800 与 ShareGPT、代表性 MoE 模型实验说明,主机内存路径需要与 EP 通信共同设计。编辑判断是,部署选型应先识别 P2P、PCIe 和主机带宽约束,再比较通信方案。结果只适用于所测拓扑与负载,不能泛称所有消费卡更划算;硬件投资比较也不是总拥有成本,本地执行更不能单独证明数据隐私边界。
论文首提交:2026-10-07(UTC)。来源 A 级:CoMoE 原论文。
平台工程|上下文预算和支出上限需要明确的执行点
Postman 与 AWS 的 Agent Mode 工程总结把工具目录视为上下文预算的一部分:按任务选择可见工具,将操作与 UI 标签页状态解耦,并用 schema-aware 的查询入口读取结构化服务数据,减少为每种问题单独定义工具。稳定提示前缀与变化较快的上下文采用不同缓存层,修改应用状态仍需用户批准。
对 FDE 的启示是,成熟产品接入 Agent 往往需要重做数据与工具接口,单纯增加模型能力不能消除界面耦合和上下文噪声。其生产实现未作为公开样例仓库提供,文章也不是独立性能基准;跨区域推理限制的是允许的处理区域,不能写成数据始终在客户自己的 AWS 环境内,缓存 TTL 与零保留配置还取决于所选模型。
发布日期:2026-10-09。来源 B 级:Postman 与 AWS 原始工程案例。
AgentCore payments 的 Incarna、BlockRun 案例进一步把可调用服务与可支出额度关联:端点返回 HTTP 402 与报价后,支付服务在模型之外核验会话上限并签署授权,再由服务方验证并交付推理。exact 面向已知价格,upto 允许在授权上限内按实际用量结算;会话还有到期时间。
编辑判断是,Agent 的资源预算应由外部系统执行,而不能只作为提示词中的自我约束,模型选择与付款授权也应分别留下审计记录。该案例依赖用户委托的钱包权限、支付协议及供应商履约;支出上限约束金额,却不证明买到的推理能完成任务。文中的接入时间与交易规模属于该团队报告,不能直接推导普遍研发节省、结算延迟或服务可靠性。
发布日期:2026-10-08。来源 B 级:AgentCore 按次推理支付工程案例。
运行时与云基础设施|同一接口还需要解释并发、采样和迁移
IBM 团队将 Spyre 实现为原生 PyTorch 设备,连接 PrivateUse1、allocator、tensor storage、stream、event 与 Inductor。编译图由 Inductor 管理,产物准备为带类型的操作步骤,调用时绑定 tensor 地址并提交;张量驻留随 storage 生命周期管理,传输可以与计算重叠。
编辑判断是,加速器接入不能只交付算子编译,还要交付内存、同步和资源生命周期的设备契约。这里多 stream 并不代表多个独立计算任务同时运行,运行时计算队列仍串行;跨 stream 的依赖需要能看到内存 footprint 的 runtime 执行,公开 PyTorch event hooks 的完整集成另属独立集成工作。它是设备实现说明,不能写成新芯片上市,或任意模型都无需修改即可运行。
发布日期:2026-10-08。来源 B 级:Spyre 原生 PyTorch 设备工程材料。
Cloudflare 新增 Workers 与 Durable Objects 的按需 CPU、内存 profiling,支持在生产请求继续执行时采样、显示 flamegraph 并导出 profile。CPU profiler 只在生命周期操作时持有 isolate lock,采样期间释放;具名 Durable Object 则可定位到具体 actor 的 isolate。
对持久 Agent 服务的启示是,调用日志和汇总指标之外,还需要看函数级 CPU、分配热点及状态对象差异。采样窗口必须主动启动,内存 profile 只能反映窗口内的分配,可能错过启动阶段和稀有异常;普通 Worker 的采样也不能自然代表所有实例。持续 profiling 仍是后续方向,不能把按需能力写成已经提供完整历史,也不能从 flamegraph 推断端到端任务成功率。
发布日期:2026-10-09。来源 A 级:Workers 与 Durable Objects profiling 原始发布。
Deno 团队加入 Cloudflare 的公告则改变了运行时维护与部署路线:双方计划将 celld 的代码和思路并入 workerd,补足自托管 Workers、Durable Objects 的分布式运行体验。Deno 公告同时给出过渡安排:运行时继续提供一年月度修复与安全更新,Deno Deploy 继续运营六个月,JSR 继续运行并迁移基础设施。
编辑判断是,Agent harness 采用持久状态、WebSocket 与 serverless 原语时,需要同时评估接口、维护期限和迁移路径。现有 workerd 的 Durable Objects 自托管实现仍有单实例扩展限制,后续整合属于计划;不能把团队加入写成完整分布式自托管方案已经交付,也不能据此保证现有应用无改动迁移。
发布日期:2026-10-09。来源 A 级:Deno 原始公告、Cloudflare 联合技术路线说明。
科研计算|让数据判断与模型产物接受可执行验收
SciExam for ENSO 将科研任务拆为观测预处理、诊断设计和模型构建,共享六小时有效工作时间。数据先通过一致性检查,建模前冻结 Agent 自己设计的诊断;隐藏评价器实际运行五变量随机 ENSO 模型,检查统计性质、未观测变量重构和留出年份预测,仓库公开 grader 与重评分工件。
编辑判断是,科研 Agent 的交付应包括可以运行、检查和重新评分的模型,而不能只依赖报告的说服力。有效工作时间排除了供应商配额与短时服务错误等待,并非固定墙钟服务承诺;模型简化筛选还复用了同一 grader,其分数改善不能视为独立验证。该评测也未判定 ENSO 不对称机制的两个解释谁成立,综合分数不能替代机制证据。
论文首提交:2026-10-07(UTC)。来源 A 级:SciExam for ENSO 原论文、作者公开代码与评价工件。
DataSense-Bench 把模型构建之前的数据选择单独验收:Agent 可以查看候选轨迹、运行分析代码和调用底座模型前向,但不能训练或访问真实评价任务;它提交五个互不重叠、等大的子集及预测排序,再由固定流程分别微调 Qwen3-4B。
终端与工具任务同时检查第一排序子集的训练后质量和整体排序能力,作者报告相对随机选择的收益有限,且跨任务排序不稳定。对训练平台的启示是,筛选理由与训练价值需要用后续模型结果连接,分析文本本身不是质量证明。范围限于一个底座、两项任务和已有轨迹的 SFT,不能外推全部数据选择策略,也不足以证明或否定完整递归自改进、RL 后训练和新数据生成。
论文首提交:2026-10-08(UTC)。来源 A 级:DataSense-Bench 原论文、原始基准仓库。
AgenticBBO-Bench 则将合成函数、超参数调优、数据库配置、芯片宏放置和分子设计放到有限目标评估预算下,覆盖 77 项任务,并控制工具、任务语义、先验和 LLM 搜索角色。作者的结果提示,数值工具越多并不必然越好,Agent 与数值优化器的交接应作为可复验设计变量。
编辑判断是,科研和工程优化都需要保存搜索策略、约束与完整成本口径,才能解释收益来自哪里。这里统一的是目标评估次数,不包括模型推理、代码执行、工具调用和候选验证,不能称端到端时间或费用公平;数据库任务使用固定学习代理模型,没有实际运行数据库负载,不能转写为生产吞吐提高。小型 frontier challenge 也不构成通用模型排名。
论文首提交:2026-10-08(UTC)。来源 A 级:AgenticBBO-Bench 原论文、作者公开实现。