AI INFRA DAILY 系统 · 工程 · 研究
缓存命中之后,分词与掩码编译仍有成本
日报 ·
- 推理前端
- 编译器
- 平台工程
推理与编译|缓存命中以后,前端和表示仍然有成本
GraphTok 关注 Agent 反复发送长上下文时的分词开销:即使大部分前缀已缓存,请求也要先得到完整 token ID,缓存才能被查询。作者把预分词、BPE 合并与 ID 组装放进可重放 CUDA graph,短输入仍交给 CPU,并在五种具体 tokenizer 配置上核验与参考实现的 ID 一致。
对服务平台的启示是,缓存命中率与前端处理容量应分别验收;降低 prefill 并不会自动消除请求入口的排队。其真实 vLLM 实验使用单模型、单 GPU,Dynamo 的 GPU fleet 部分是前端负载模拟,不能当作真实多卡端到端收益;Qwen 的 NFC 归一化也仍在主机执行。
论文首提交:2026-10-09(UTC)。来源 A 级:GraphTok 原论文。
CompileMask 则让 mask 的表达与执行分工:区域式 MaskSpec 描述可见性规则,离线编译生成专用预处理 kernel;在线读取序列边界等批元数据,产生区间端点和 tile 状态组成的执行描述符,供 attention kernel 使用并跨层复用。编辑判断是,动态规则不必在每层都作为通用判断逻辑重新执行,编译器可以提前整理稳定结构,把变化留给元数据。
论文覆盖 HSTU、共享前缀奖励模型、CLEAR 与因果 mask,并测量 Qwen3 训练;获得区间执行路径的收益仍需能导出有界区间与端点,不满足时会回退到在线谓词判断,不能写成任意 Python 谓词都能高效编译。实验说明使用 Blackwell 系列 GPU,但未明确精确型号,部分基线走回退实现,因此这里不引用性能倍数,也不推导其他硬件上的收益。
论文首提交:2026-10-09(UTC)。来源 A 级:CompileMask 原论文。
同样的表示成本出现在 llama.cpp 的 b11540 预发布版本中:SYCL 后端纳入 MXFP4 MoE 的算术解码与权重重排,以保持位级一致的整数运算替代查表,并按专家延迟重排权重以便对齐向量加载,未对齐张量保留通用回退。对运行时选型的启示是,量化格式本身不能决定执行效率,解码路径、专家布局和目标设备需要一起检查。
作者的测试围绕 Windows、oneAPI 与 Intel Arc Pro B70 上的 gpt-oss 工作负载,评论区还报告不同 Arc 型号及 prefill、decode 阶段的收益不一致,不能推广到 CUDA 或所有 GPU;原发布明确标为 Pre-release,代码合入也不能代替生产稳定性验收。
发布日期:2026-10-10。来源 A 级:llama.cpp b11540 原始发布、对应原仓库变更。
平台工程|数据入口与生产动作需要各自的授权边界
近期补充的 Data Agent Kit GA 将 MCP 工具和 Google 工程师编写的 skills 组合,给编码 Agent 提供查询 schema、执行查询、读取作业日志和管理数据资源的入口;GA 扩展 BigQuery Graph、Bigtable 与 Managed Service for Apache Spark。
官方说明每步使用调用者或其代入服务账号的 IAM 权限,数据层访问策略继续生效。对 FDE 的启示是,数据接入应同时交付环境上下文、窄化工具和可审阅变更,避免让模型凭空猜测表结构与作业状态。skills 是可审计的工程指引,不是权限系统;Agent 接入不会扩大既有授权,服务用量仍可能产生费用,生成的查询和资源变更也需要按业务要求验收。原始发布日期:2026-09-30。
来源 A 级:Data Agent Kit GA 原始发布。
Oracle 的生产 AI 平台工程材料把这一边界延伸到共享计算与恢复:OKE 中生产服务和训练任务共享容量时,需要显式设置优先级、保留容量、namespace 配额与并发控制,并在服务目标受到威胁时限制低优先级任务。工作负载身份和数据库访问控制约束数据路径,私有网络域通过明确路由相连,恢复区域需要实际还原数据与索引。编辑判断是,平台团队的交付不应止于模型端点,应包括可重复的业务接入与恢复演练。文章给出参考架构和运营建议,没有提供共享集群的通用性能基准;底层云服务可用性也不能自动推出业务的恢复时间与数据丢失上限,这些目标需要逐工作负载验证。
发布日期:2026-10-09。来源 B 级:Oracle 官方平台工程材料。
近期补充的 AWS DevOps Agent 修复示例则给出可执行的动作边界:调查完成事件经 EventBridge 触发 Lambda Durable Functions,Bedrock 从事先批准的 Lambda 工具白名单中选择动作;只读操作自动执行,修改基础设施的操作暂停并等待批准,之后从检查点继续。
对平台工程的启示是,故障诊断、修复建议和实际变更可以形成连续流程,但必须分别保存证据与执行权限。示例以 Lambda 超时故障演示,工具范围由部署方定义;它没有证明任意生产故障都能自动修复,人工批准也不能替代工具实现的正确性与变更后检查。原始发布日期:2026-10-07。
来源 B 级:AWS 自动修复官方工程示例。
云与基础设施|服务边界和算力承诺要按交付状态理解
Cloudflare 在 Workers AI 发布 Clef-omni,让文本、图片、音频与视频进入同一次决策请求,并对齐视频画面与音轨。它对允许的答案打分,不生成开放文本;同次更新还调整 Clef-flash 的托管价格与上下文窗口,并优化 Clef 的服务路径,部分优化来自迁移到 SGLang。
编辑判断是,分类与路由类任务可以采用明确输出空间的服务接口,减少应用层串接转写和多模态模型的步骤。代价是应用必须先定义问题与候选答案,不能把决策模型当作通用生成模型;托管 Clef-flash 的窗口缩小为 24K,开源权重的自托管窗口并未同步改变。官方公布的延迟和基准属于其服务与所测任务,这里不推导硬件未知时的通用加速,也不把尚待版本落地的 SGLang 支持写成已发布。
发布日期:2026-10-09。来源 A 级:Workers AI 原始更新。
近期补充的产业信号来自 NVIDIA:公司宣布未来五年价值 10 亿美元的美国科学研究支持承诺,方向包括高校研究、量子计算与支持政府科研任务的云服务商,并将其置于 Genesis Mission 合作背景中。对科研基础设施的启示是,资源建设正在同时涉及算力供给、研究机构接入和领域工程,预算公告之外还应追踪具体项目如何开放、资源如何分配以及应用如何验证。这里的事实是公司宣布了承诺,不能写成资金已经全额投入、新系统已经交付,或科学成果已经实现;既有国家实验室合作也不应重复计为本轮新发布。原始发布日期:2026-10-08。
来源 A 级:NVIDIA 科研支持原始公告。
科研工程|会话可以重置,实验产物与恢复状态必须可检查
HMA 将长周期机器学习工程拆成两个 Agent 在共享工作区上的交替会话,每轮限制已接受实验的数量,交接时重置上下文,同时保留代码、模型与候选结果;最后再由 Agent 复核归档候选,测试集分数不向执行 Agent 开放。作者以 MLE-bench 的 Kaggle 任务研究长会话进展减速,以及定制 harness 随底座模型更新失效的问题。
编辑判断是,科研平台可以分别设计持续探索与成果保留,把会话长度作为可控制变量,并用持久工件与最终复核维持交接。主实验使用单张 A10、固定六小时预算和指定模型组合,相同时间不代表 API 成本相同;理论优势也有充分条件,不能据此断言任意双 Agent、任意切换频率都会更好,或已解决开放式科学发现。
论文首提交:2026-10-09(UTC)。来源 A 级:HMA 原论文、作者公开实现。
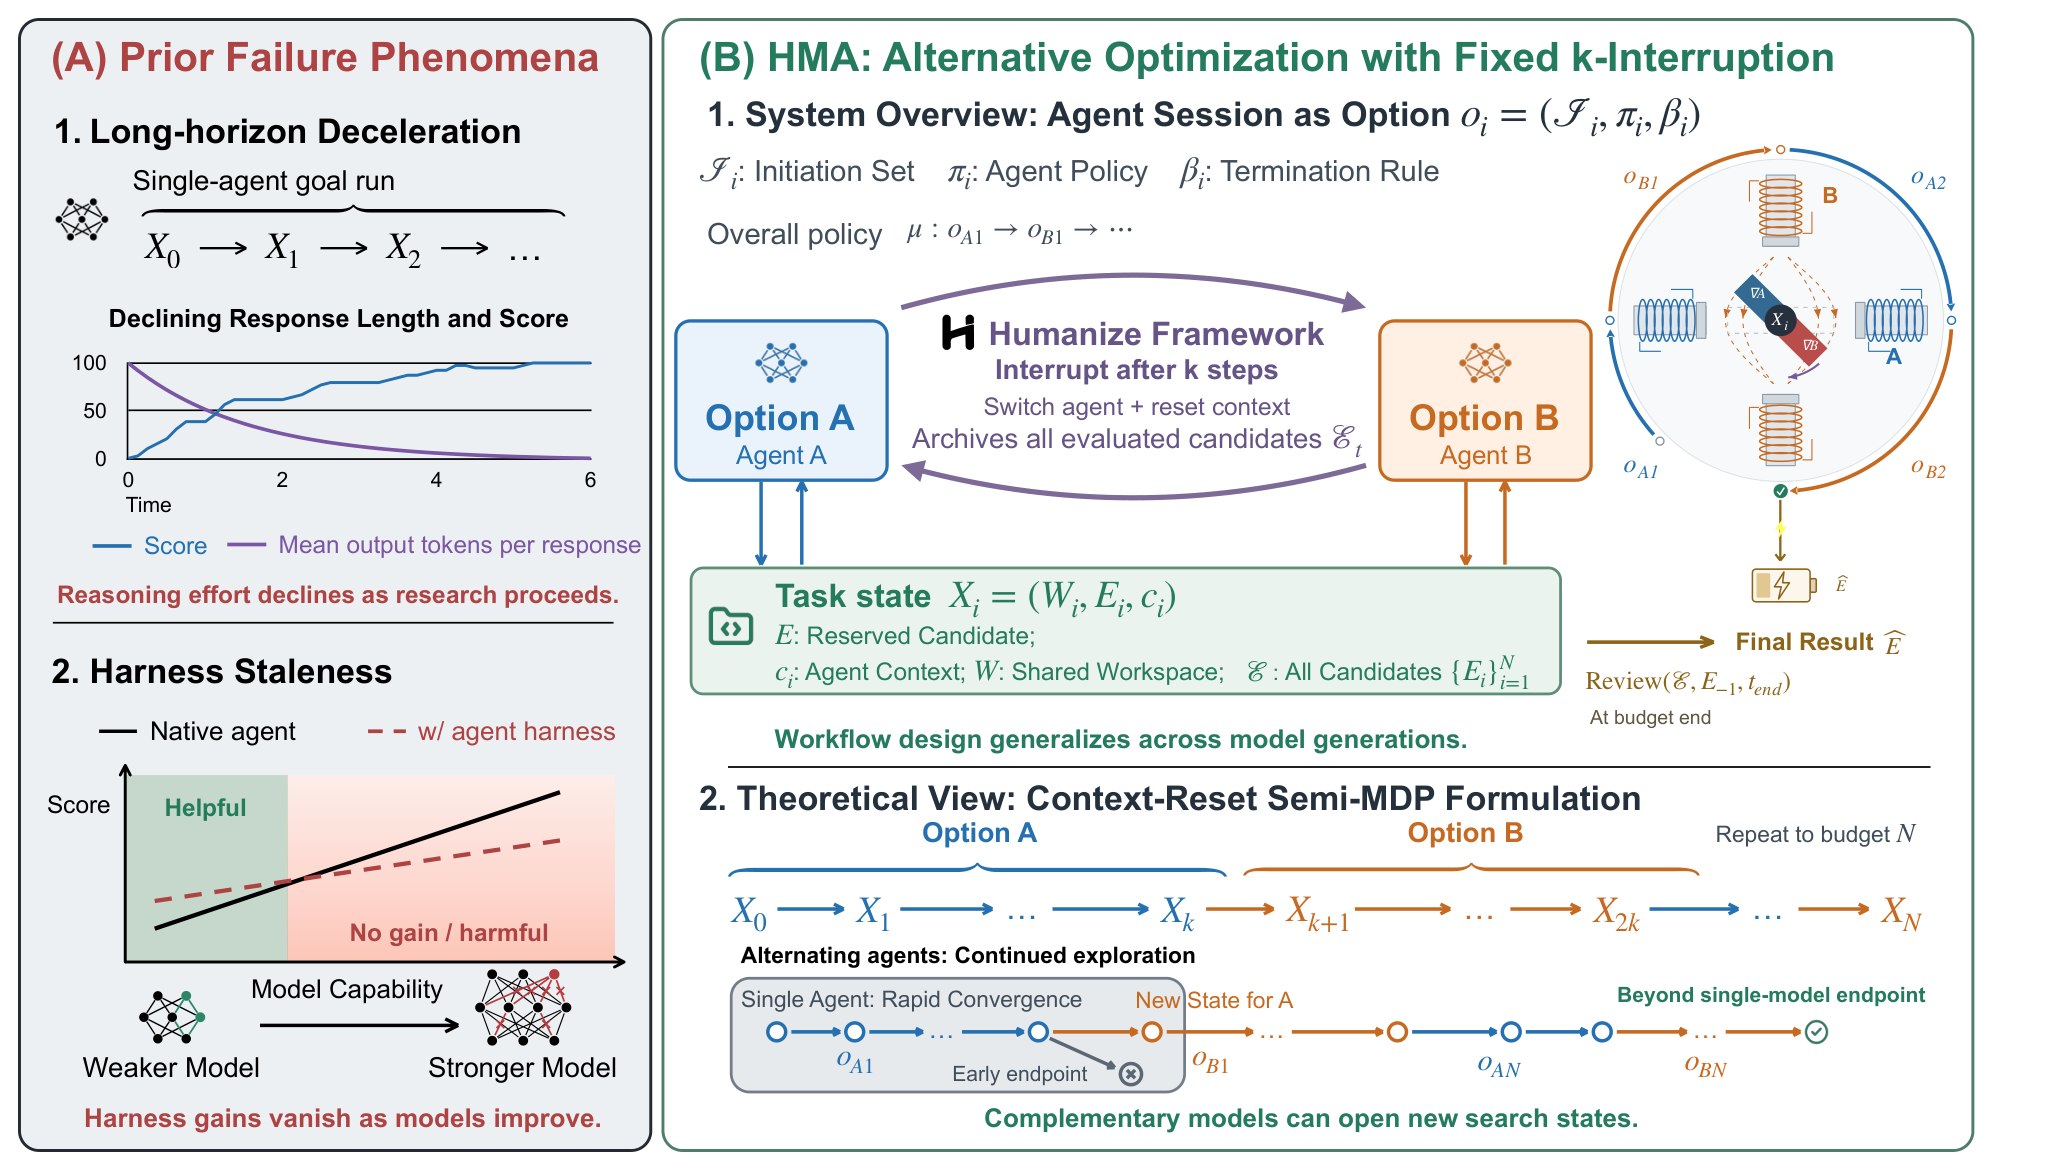
Changye Li 等,论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。
近期补充的 HPC resilience engineering 研究要求 Agent 为科学 MPI 应用真正生成 checkpoint/restart 支持,并在生成、验证、修改循环中辨认关键状态和一致的保存位置。验证包含杀掉一个 MPI rank、重启整个作业、比较输出,以及确认实际写入 checkpoint;随机输入和隔离用于防止以结果回放冒充恢复。
对科研平台的启示是,代码生成验收应覆盖故障后的行为,保存了哪些状态比“程序能再次启动”更关键。作者指出分散在多个模块中的关键状态仍难以完整识别;实验仅在单开发主机、四个 MPI ranks 上执行,不能外推大规模多节点恢复、所有失效类型或长期生产可靠性。
论文首提交:2026-10-08(UTC)。来源 A 级:HPC 故障恢复原论文、作者 autockpt 原仓库。