AI INFRA DAILY 系统 · 工程 · 研究
稀疏页打包、低比特解码与语音流水线
日报 ·
- 稀疏注意力
- 低比特解码
- 语音 Agent
推理系统|减少空算,也减少等待
KPage|把跨块有效页装进同一计算块
10 月 20 日的 KPage,将视频稀疏注意力已选中的 K/V 逻辑块拆成 16 行页,再跨块打包,直接载入共享内存,不在 HBM 生成压紧后的中间张量。Q 端按有效行数选择计算块形状,前后向都保留原稀疏邻接关系;改变的是物理执行布局,而不是再删一层注意力连接。
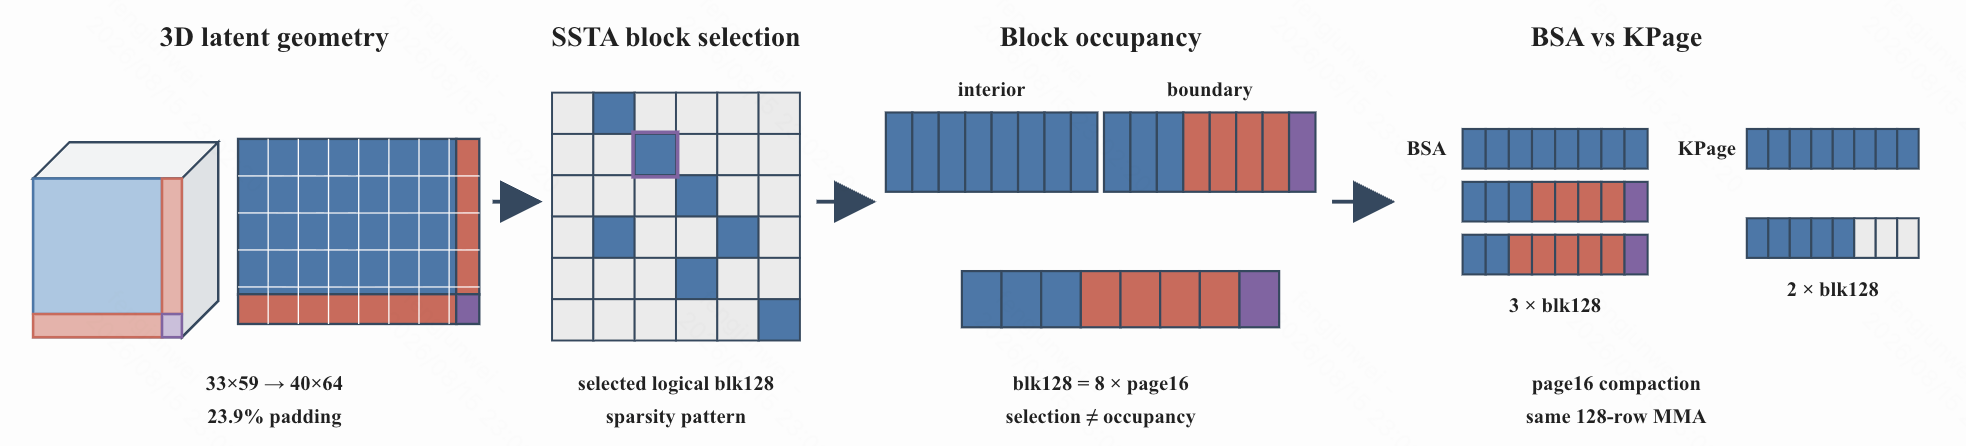
Junwei Feng 等,KPage 论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。
实验使用单卡、BF16、CUDA 13.2,比较 NVIDIA BSA 和其他精确稀疏实现,但未披露 GPU 型号。计时排除了稀疏图、页表和执行布局构建,块已充满时也接近基线。其结果不能直接换成整条视频生成管线的收益,代码开放与 cuDNN Frontend PR 仍是审查后的计划。
来源:2026-10-20,A 级|论文与首提记录 · 页布局、实验与开放计划。
三值 CPU 解码|权重本地化之后仍有同步瓶颈
10 月 20 日的一项三值 LLM 解码研究,在两台双路 Xeon Platinum 8358、8555C 服务器上追踪线程等待;每台机器暴露四个 NUMA 节点,论文中的 multi-node 指同机内存域。作者复用相同低比特 kernel 和权重,比较按输出行分片与列分片,发现仅把权重放到读取线程附近还不够,慢线程与节点 leader 仍会拖住其他线程。
测试以 Llama 3、Falcon 3 的三值版本和单序列 decode 为主;作者的 Col 引擎没有自身的 prefill、batching,也未实现原版 BitNet 的额外结构。两台服务器共享使用,绝对等待比例会受干扰。可借鉴的是同步和数据流的控制比较,不能把分开计时的阶段估算当成完整请求实测,或推广为跨服务器集群结论。
来源:2026-10-20,A 级|论文与首提记录 · 平台、分片控制实验与限制。
BitMTP|让接受前缀、KV 边界与图重放一致
10 月 20 日的 BitMTP,通过联合训练让同一个低比特模型兼具逐 token 生成与多 token 草稿能力。运行时按草稿宽度选择算子,在共享 KV 上复用 CUDA Graph,并使已提交前缀、实际物化的 KV 边界和重放状态保持一致,避免少走解码步数却增加状态维护成本。
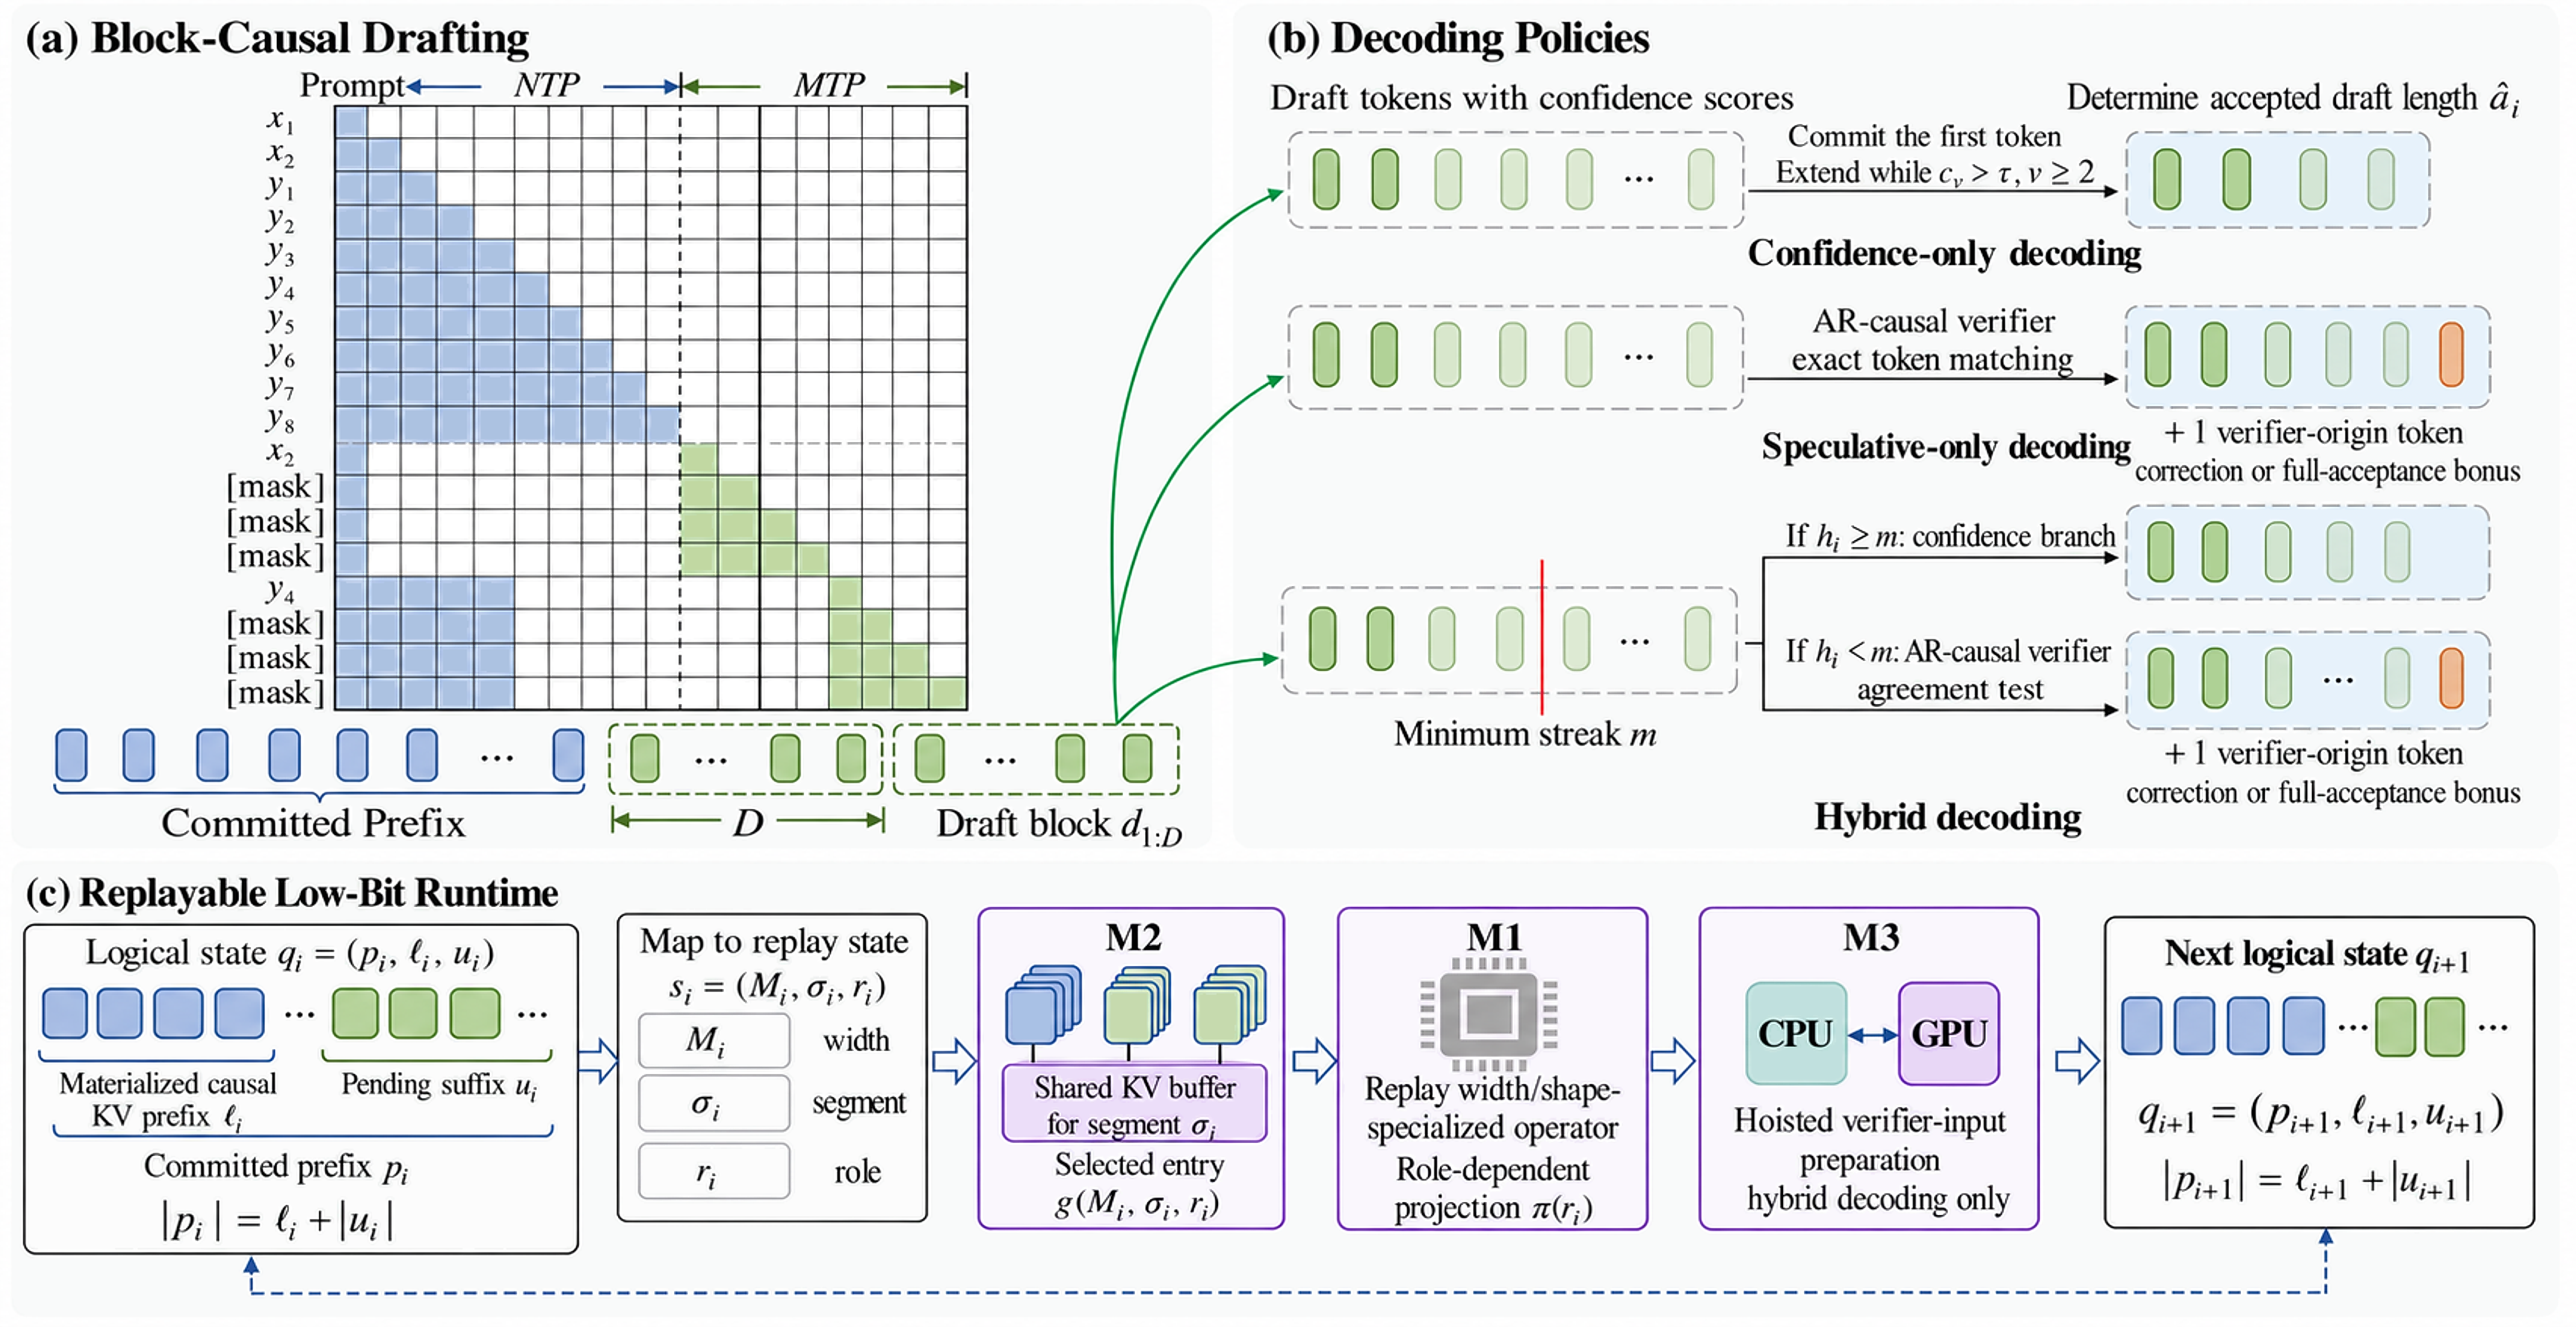
Ning Zhang、Shihao Wang、Jinrui Zhang、Chaodong Xiao、Lei Zhang,BitMTP 论文图 2 · CC BY 4.0,原图未修改。点击图片查看大图。
评估覆盖 H20、RTX 3090 与 Orin NX 上的 BitNet b1.58-2B、Bonsai 模型,采用匹配的自回归基线和 greedy 生成;吞吐只计 decode loop,不含 prefill、初始化。只有每块都验证的 speculative-only 保留验证器定义的 greedy 续写,confidence 与 hybrid 允许未经验证的提交。代码已公开,但这些策略不能统一称为无损加速。
来源:2026-10-20,A 级|论文与首提记录 · 接受策略与计时范围 · 训练、解码与评测原仓。
平台工程|原生接口仍有执行契约
TorchNeuron|Trainium 接入 PyTorch 原生设备接口
近期补充:TorchNeuron 组件随 Neuron 2.33 于 10 月 15 日发布,AWS 在 10 月 20 日公告其 Public Beta。新后端通过 PrivateUse1 注册 neuron 设备,提供 eager、torch.compile、分布式训练和 NKI 自定义算子路径;当前版本面向 Trn2、Trn3,采用 PyTorch 2.14,与此前基于 PyTorch/XLA 的同名包不同。
原生接口减少入口差异,但没有消除支持边界:编译要求静态 shape,新形状会重编译,非连续输入可能复制,部分 API 回退 CPU,float64 按 float32 执行,TorchAO 尚不可用。迁移验收仍要覆盖算子、数值、编译缓存和回退路径,Beta 公告不能代替具体训练作业的兼容性验证。
来源:2026-10-15(组件发布;10 月 20 日公告 Public Beta),A 级|AWS 原始公告 · 2.33.0 发布说明 · 原仓与版本矩阵 · API 兼容与回退说明。
CUDA Tile Mamba-2|融合分块递推的前向计算
近期补充:NVIDIA 在 10 月 19 日介绍与 Jane Street 合作的 Mamba-2 前向 kernel。实现将块内衰减前缀和、跨块状态递推和块内输出计算分开设计,再把因果掩码、衰减与 skip connection 融入输出 kernel,减少中间矩阵写回全局内存,并结合布局选择和按 shape 调优。
TileGym 已公开实现、测试与 benchmark;工程文测量的是单张 B300 SXM6、CUDA Tile 1.5.0 上的 kernel,不能写成端到端训练或解码提升。当前源码还包含 backward 路径,因此本文前向评估的范围也不意味着项目完全缺少反向实现。采用这些优化仍需核对硬件、编译工具与具体 shape。
来源:2026-10-19,B 级|NVIDIA 原始工程材料;A 级|TileGym 实现 · 对应测试与 benchmark。
科研计算|先对齐误差,再比较吞吐
潮流求解基准|把 CPU、GPU 与学习替代放到同一检验下
10 月 20 日的一项电网潮流基准,覆盖 15 个电网、14 至 70,000 母线,比较七个 CPU、两个 GPU 物理解算器与三种已发表学习替代模型,并用独立实现的 KCL 残差检查统一精度口径。作者同时提供基于 cuDSS 的批量 GPU 求解器 gpusim2grid,提醒比较学习替代之前,应先确认物理基线的并行度与实现质量。
主报告平台为双 EPYC 9135、32 物理核与 RTX PRO 6000 Blackwell 96GB;GPU 数据往返计时,初始化、JIT 不计。实验固定拓扑并改变负荷与发电,比较各方法观察到的最佳吞吐,没有重训全部 ML 架构,也未进入真实电网控制环。结果不能泛化到最优潮流、所有神经求解器;附录还有偶发 cuDSS 错误与 NaN,原仓也明确是早期研究发布,不能称为生产稳定方案。
来源:2026-10-20,A 级|论文与首提记录 · 统一评估、硬件与异常记录 · gpusim2grid 原仓。
Ozaki-II on Xe2|用整数矩阵引擎重建双精度乘法
近期补充:10 月 18 日的 Ozaki Scheme II 实现,以 SYCL 和 oneMKL 将实数、复数 FP64 GEMM 分解为多模数 INT8 精确乘法,再通过中国剩余定理重建结果。模数数目调节精度,复数路径在整数域采用 3M 形式;低精度矩阵引擎在这里承担数值重建的子任务,而不是直接降低最终运算精度。
实验使用一张 24GB Arc Pro B60,比较同卡原生 oneMKL DGEMM、ZGEMM 和 Ozaki-I;数据驻留设备,工作区预分配,报告多次运行中的最好值。输入指数范围、工作区、小矩阵启动成本和特殊值处理仍有限制,正确舍入也有输入与模数条件。MIT 原仓提供实现与测试,但应用需要显式调用,不能把矩阵核结果外推成电子结构程序或未来 Xe3 的实测收益。
来源:2026-10-18,A 级|论文与首提记录 · 重建算法、数值条件与实验 · OS2-Xe 原仓。
语音服务|把模型能力接到持续会话
Voxtral 3|语音、推理与工具调用接成流式流水线
Mistral 在 10 月 20 日推出 Voxtral 3 语音模型与 Agent SDK,把实时转写、轮次结束检测、推理、工具调用和语音合成接成基于 LiveKit 的流水线。各阶段仍是可替换的模型,应用可复用会话配置、固定版本,并通过会话事件与 webhook 记录通话生命周期,关注点从单段音频扩展到连续交互。
API 与自部署路径的交付条件要分别核对:完整私有部署需要联系团队,SIP 电话接入在首发时面向企业客户。官方延迟与语音质量展示也不能代替特定语言、噪声、打断和工具等待下的任务验证。系统集成仍要检查轮次处理与外部操作结果,不能把一次转写的准确率直接当成整通电话的成功率。
来源:2026-10-20,A 级|Mistral 原始发布;B 级|SDK、会话与接入范围。