AI INFRA DAILY 系统 · 工程 · 研究
KV 发现、原生 TPU 与科研调度
日报 ·
- KV 发现
- 原生 TPU
- 科研调度
推理系统|把发现、传输和预计算分开
KVCompass|查找缓存持有者,再转发请求
近期补充:10 月 16 日 UTC 提交的 KVCompass,将前缀身份与缓存实际位置分开。worker 上报缓存准入、层级变化和淘汰,边缘节点用多层 Ludo 索引寻找持有者,再综合剩余 prefill、排队、网络与存储成本选择目标。跨区域的主要动作是转发请求,而不是经广域网搬运大块 KV。
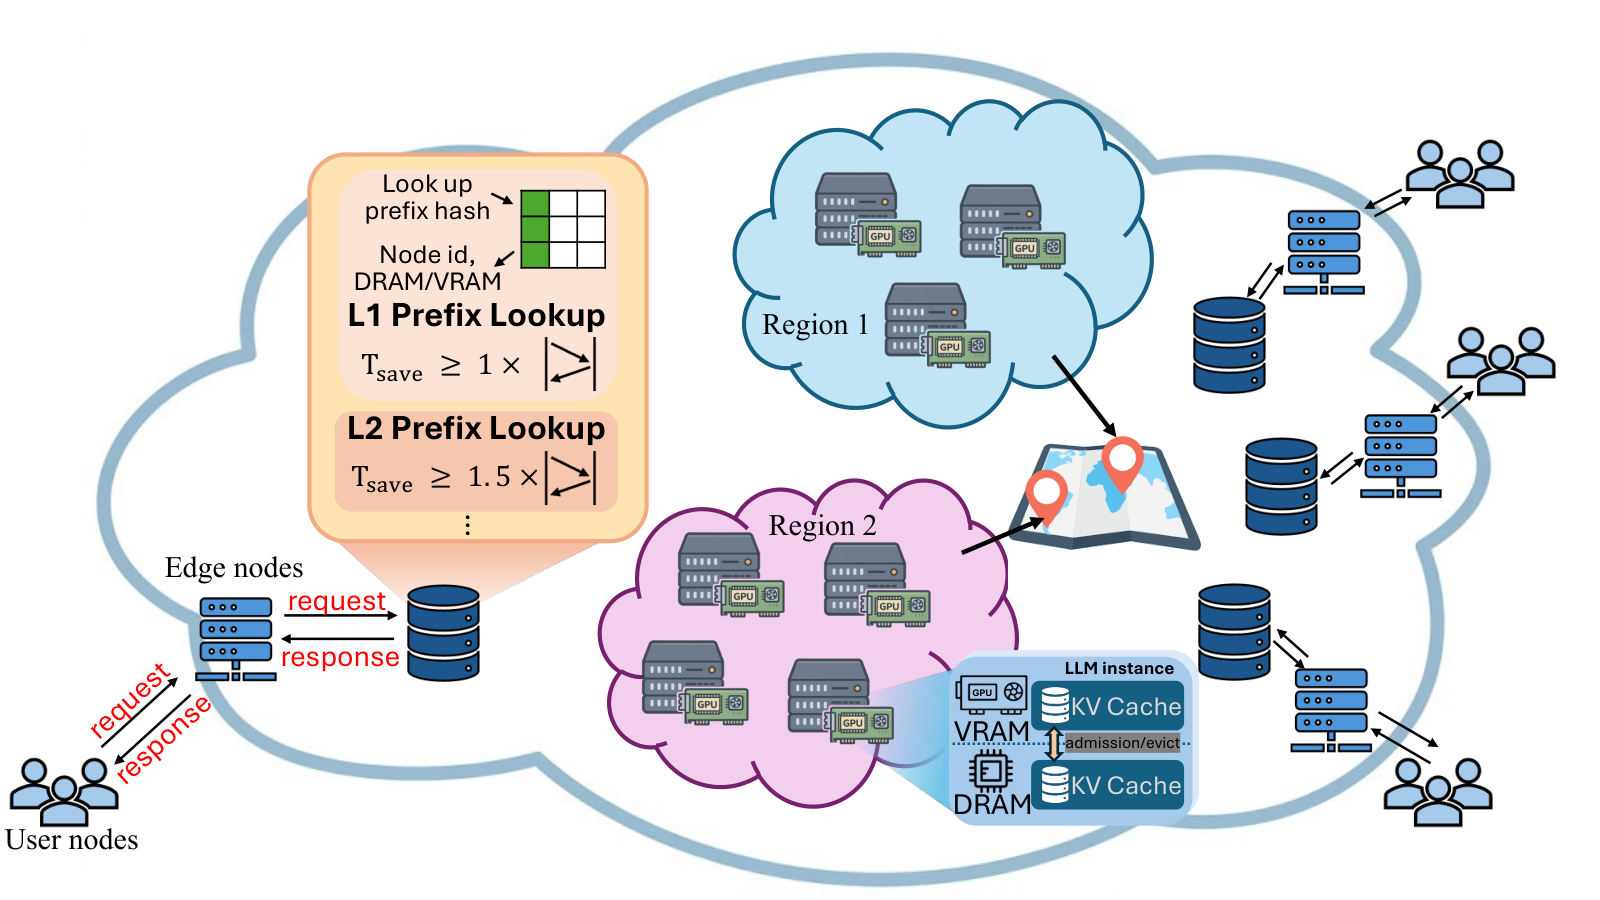
Shiyi Ling、Fei Fang、Chen Qian,KVCompass 论文图 7 · CC BY 4.0,原图未修改。点击图片查看大图。
实机由美洲 8、亚洲 4、欧洲 2 张 RTX 5090 构成,每卡运行 SGLang 0.5.10 worker,服务 Llama-3.1-8B-Instruct/BF16;使用 Mixed、WildChat、LMSYS 负载,对照哈希、Chord、PlanetServe、中央目录、SkyWalker 与 Dynamo,另做 64 worker、8 区域模拟。
索引可能过时或误命中,目标缺少缓存时仍要重算;模拟与同配置实机之间的误差未被量化。主评估只服务同一模型,不能推广为不同模型共享 KV。作者仓库已提供实机与模拟 artifact,实际部署仍要核对发现结果和真实缓存状态。
来源:2026-10-16(UTC),A 级|论文与首提记录 · 架构与实验条件 · 作者原仓。
PlaneZip|按压缩后的成本安排激活卸载
10 月 18 日的 PlaneZip 在 128 字节块内选择无损编码,用上一轮压缩率预测张量大小,再决定保留、卸载、丢弃重算与预取。它让内存规划看到压缩后的传输成本,避免只按原始张量大小决定带宽和驻留。
证据来自 trace-driven 模拟:原始张量由 CPU 小 batch 的三轮训练采集,trace 来自 meta device,BF16 样本由 FP32 转换。模拟配置为 RTX 2080Ti/FP32/PCIe 3.0 与 A100 40GB/BF16/PCIe 4.0,并假设 64GB/s 压缩引擎,对照重计算、卸载、MegTaiChi 成本模型及有无压缩的规划。
50% 内存预算仅指激活,不含参数、梯度与优化器;实验未建模 kernel fusion、复制和计算干扰,FlashAttention 也会减少可压缩的注意力张量。无损编码针对输入张量的表示,不能把模拟收益写成现有 GPU 已实现的硬件端到端加速。
来源:2026-10-18,A 级|论文与首提记录 · 压缩规划、数据采集与模拟限制。
StreamAhead|按视频片段选择预计算深度
10 月 18 日的 StreamAhead,为每段视频保留原始帧、视觉特征或 KV 三层表示,空闲时提前推进计算,查询到来再检索并补齐所需片段。独立片段表示带来调度灵活性,但不等于联合编码,合成时仍需处理位置与跨段交互。
所有实验使用一张 48GiB RTX 6000 Ada,默认 Qwen3-VL-8B/BF16、FlashAttention 2、448 像素输入和 16GiB 表示缓存,对比 ReKV、StreamingVLM、OASIS。性能扫点采用 20 秒视频、末尾一次查询,并在查询到来时停止输入;另有持续输入的在线回放,两类条件不能混成无限持续服务保证。
准确率表还包含外部发表结果,StreamingBench 仅抽取部分题目并排除音频题,不能当作所有基线的全量同题复测。这里可借鉴的是把闲时算力换成分层可复用状态,具体收益仍取决于片段命中、查询时机与缓存预算。
来源:2026-10-18(UTC),A 级|论文与首提记录 · 分层表示与评估范围。
平台工程|服务控制与设备后端继续分层
llm-d 1.0|同时管理流控、会话和滚动更新
llm-d 在 10 月 20 日发布 v1.0.0,正式 release 给出了新的优先级与公平性流控、过载准入和削减配置。router 配置 API 升至 v1,Responses API 支持 previous_response_id;router 高可用与 DisaggregatedSet 则将 prefill、decode 副本作为逻辑单元协调滚动更新。
平台需要同时看请求优先级、会话状态和升级次序,不能只验证单个引擎能否启动。P/D 部署仍依赖匹配的 LeaderWorkerSet、DisaggregatedSet API 与引擎镜像,部分镜像仍为候选版本,原自建 ROCm 镜像也已弃用。组件发布和协调升级设计不能直接换成任意模型、网络及故障条件下的统一 SLA。
来源:2026-10-20,A 级|v1.0.0 原始发布与迁移说明 · 原始开源公告。
TorchTPU|原生 PyTorch 接口接入 TPU
Google 在 10 月 20 日宣布 TorchTPU 开源,原仓按 Apache 2.0 提供;其推荐的 torch_tpu 0.2.0 已于 10 月 19 日发布到 PyPI。后端通过 PrivateUse1 注册为 tpu,将 ATen 操作降低成 StableHLO 后交给 XLA,支持 eager、torch.compile 与编译缓存复用。
原生接口可以减少迁移改动,支持矩阵仍需逐项读取。0.2.0 将 v5e、v5p、v6e、v7 及混合执行等列为 Validated,FSDPv2、MPMD 与 Helion 仍属实验性能力;动态操作可能重编译,无重编译动态操作、Streams 和 graph capture 仍在路线图上。
当前矩阵乘精度默认设置与 CUDA 不同,跨设备需要数值验收。开源公告日、包发布时间与特性成熟度是不同事实,不能据此声称所有模型都能无修改、同精度、同性能地迁移。
来源:2026-10-20(开源公告;0.2.0 包发布于 10 月 19 日),A 级|开源公告 · 原始仓库 · 0.2.0 发布物;B 级|版本支持矩阵 · 精度与数值说明。
科研计算|保留可复现状态与求解边界
CQTwin|从调度记录走向状态快照比较
10 月 19 日的 CQTwin,把离线轨迹回放、Snapshot Lab 和按事件到达的模式放进同一工具链,采用 C++ 离散事件核心与浏览器看板,支持冻结队列状态后比较策略。它让调度记录成为可重复的 what-if 输入,而不只是历史统计。
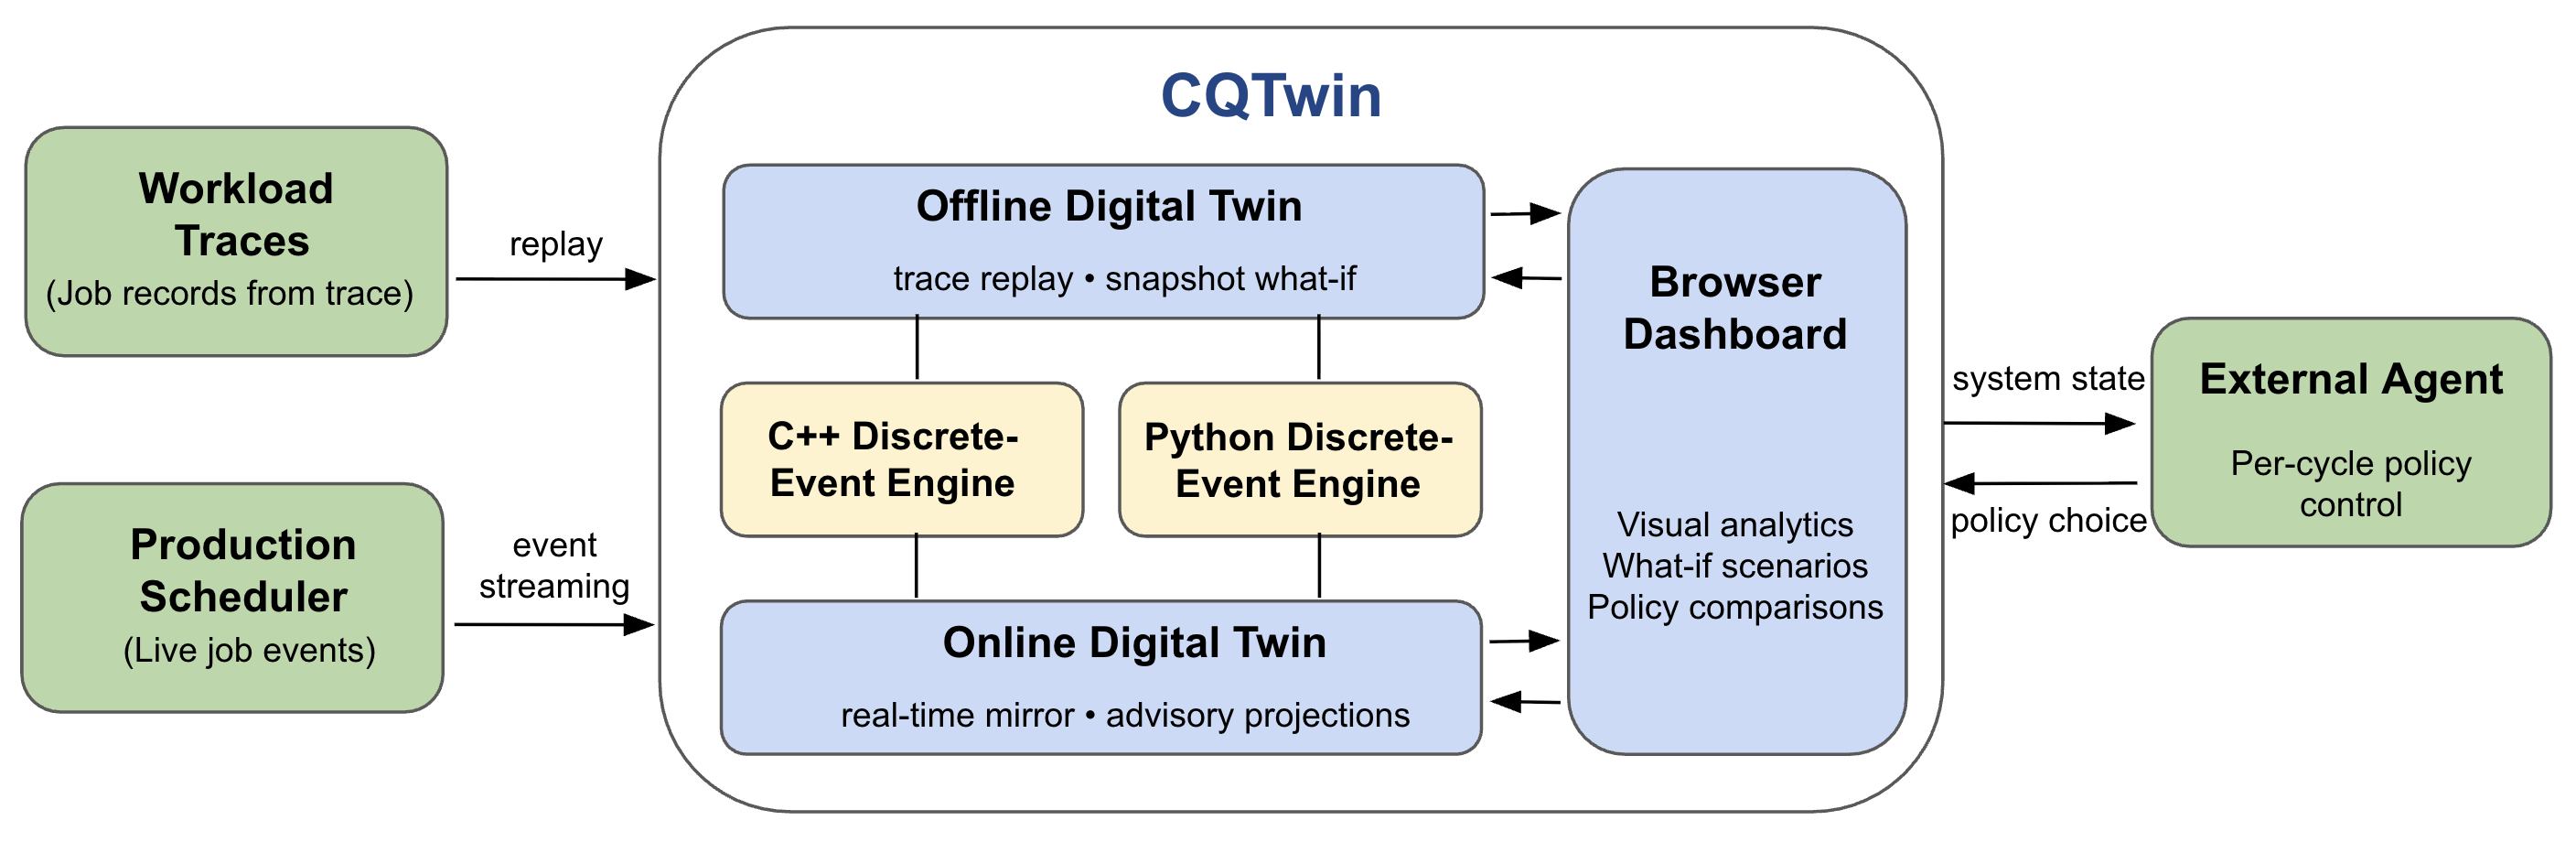
Kanglin Xu 等,CQTwin 论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。
实验使用 ALCF 的 Mira-2016、Theta-2021、Polaris-2023 生产记录。C++ 与 Python CQSim 的逐作业一致性只在 Theta 前 50,000 个作业、五种策略及 EASY backfill 下验证;计时为单线程、三轮中位数,运行主机型号未披露。
在线实验仍是记录事件流,当前只建模整节点分配,不包含 GPU、内存、异构节点或拓扑约束,也未证明切换策略能改善真实调度结果。论文给出原仓入口,但不能仅凭设计图就认为生产实时接入与整套部署已经完成。
来源:2026-10-19,A 级|论文与首提记录 · 设计、验证与限制。
KernelPack-JAX|连接节点生成、离散和参数恢复
10 月 18 日的 KernelPack-JAX,将边界采样、保留棱角的节点生成、RBF-FD 离散与 PDE 参数恢复接成 GPU 流程。JAX 自定义线性求解规则复用 cuDSS 因子,并将多个参数方向合成多右端项求解,让可微接口与实际求解开销一起设计。
数值实验全部在单张 RTX 5090、双精度下运行,覆盖二维、三维 Darcy、反应扩散、平流扩散及内部障碍物,主要检验制造解的收敛与参数误差。原仓已有源码、测试、示例和重现脚本,使用 cuDSS 扩展仍需满足构建要求。
框架依然进行离散化,可见性选择是启发式,稳定性检查也只是必要条件。反问题参数不超过六个,结果不能外推到多 GPU、真实观测数据或任意几何参数反演,更不构成对其他 PDE 框架的全面性能比较。
来源:2026-10-18(UTC),A 级|论文与首提记录 · 可微实现与数值实验 · 作者仓库与重现说明。
跨领域交付|模型速度与机器人动作各有验收尺度
Mercury 3|扩散语言模型进入百万上下文服务
Inception 在 10 月 19 日发布 Mercury 3,将扩散语言模型的上下文上限扩展到 1M token,并通过自身平台及合作服务提供 API。官方快速开始已使用 mercury-3 模型标识和 reasoning_effort 参数,给现有应用提供了可核对的接入入口。
发布页的吞吐、基准和客户案例属于厂商及合作方证据,不能直接替代特定负载的首个可用答案延迟、并发与端到端任务成功率。适配接口只是接入起点,仍应分别检查推理预算、输出长度和工具调用行为,不能把 token 生成速度等同于整条 Agent 工作流提速。
来源:2026-10-19,A 级|Inception 原始发布;B 级|官方 API 快速开始。
MoveIt Pro 10.2|模型导出与动作执行一起核对
MoveIt Pro 在 10 月 20 日发布 10.2.0,支持将微调后的 LeRobot pi0.5 检查点导出为 LibTorch、ONNX Runtime 或两者的模型包。MCP 接口也能按修订核验编辑 Objectives 与 Behavior 包,并通过目标 ID 启停任务,使模型、行为树和运行时更直接地连接起来。
动作执行仍有独立边界:新增碰撞复查等控制需要主动启用,默认不会改变既有规划;从动关节的限位会在加载模型时检查,但其自身位置限制尚未在规划中单独强制。host-user MCP 会话具有执行能力,策略限制是可选项,审批遵循客户端设置。功能交付不能代替具体机器人、控制器和场景的验证。
来源:2026-10-20,A 级|10.2.0 正式发布说明。