AI INFRA DAILY 系统 · 工程 · 研究
多层 KV 读取、轨迹准入与长程机器人任务
日报 ·
- KV 存储
- 强化学习流水线
- 机器人评测
模型系统|共同安排读取、传输与计算
KVStream|让存储层按完成速度共同读取前缀
近期补充:10 月 22 日 UTC 的 KVStream,将一轮推理所需的前缀读取合成任务池,把每个缓存块复制到本地 NVMe 和并行文件系统,空闲的存储层继续领取未读块。新 KV 的写入延后到前向计算期间,减少读写竞争;延后没有消除复制写入成本,也不提供跨节点 KV 协调。
实验使用每节点四张 H100-80GB 或 A100-40GB,连接双 NVMe RAID-0 与 VAST/Lustre,对照 LMCache、Mooncake Store、SGLang HiCache。工作负载强调长上下文与高前缀复用,基线本来也使用双盘条带化。复用不足、主存能容纳工作集或写入无法及时排空时,KVStream 可能变慢,不能概括成增加存储层就能加速。论文描述了 LMCache 后端实现,但未给可核验的本项目公开仓入口。
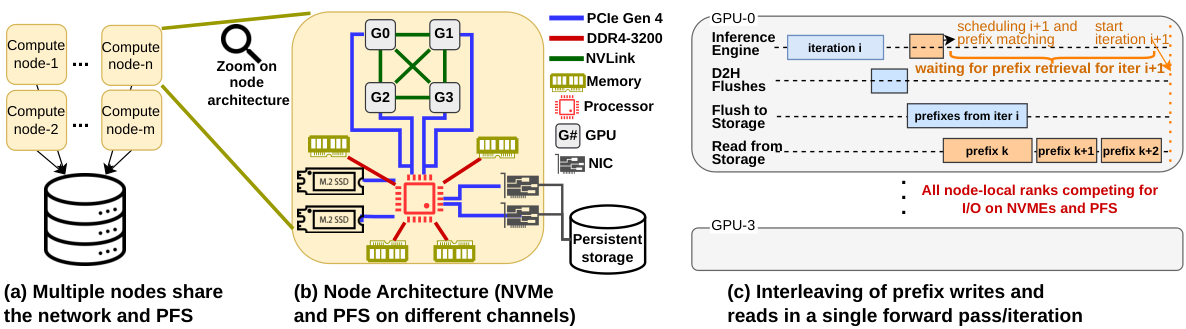
来源:2026-10-22(UTC 首提;近期补充),A 级|论文与首提记录 · 系统设计、实验与退化条件。
KnitTrans|提前接收轨迹,保留最终批次配额
近期补充:10 月 23 日 UTC 的 KnitTrans,协调 rollout 到训练之间的准入与数据传输。它允许较小批次提前进入训练,但先检查剩余容量能否满足最终数据来源配额;随后按训练拓扑读取独立数据单元,逐 micro-batch 准备输入,并复用重复的多模态编码,同时汇总所有使用者的梯度。
实验在 32 个八卡 Hopper 节点上运行 FP8 大模型 RL,覆盖 CodeAgent 和 Video Grounding,对照 VeRL 共置、slime 分离执行及多种传输基线。论文只披露 GPU 架构,没有可确认的具体型号;结果减少的是分离流水相对共置额外引入的陈旧度,未将所有陈旧度归零。多模态评估含内部数据集,传输和训练收益也不能当作完整 RL 流程的统一加速比;论文没有给 KnitTrans 自身可核验的公开仓入口。
来源:2026-10-23(UTC 首提;近期补充),A 级|论文与首提记录 · 准入规则、数据路径与实验范围。
TranSAGE|共同搜索算子分组与空间数据流
近期补充:10 月 23 日 UTC 的 TranSAGE,把相连算子作为流水簇,使用动态规划划分计算图,再搜索簇内的分块、展开、循环顺序与数据流。MLIR lowering 将结果映射到计算、存储和路由原语,生成可配置数据通路及 RTL 相关制品,让融合方式与硬件资源一起确定。
评估覆盖 Llama、Qwen、Gemma 负载;生成加速器使用 1GHz、45nm 性能模型和 Accelergy 能耗估计,再缩放工艺,与 Orin NX、A100、Ascend 910B3 测量结果比较。这是单芯片架构研究,不能当作新芯片实测或生产推理运行时;生成后物理资源固定,模型结构变化可能要求重新生成,跨芯片通信策略也未纳入搜索。原仓以 Apache-2.0 提供 MLIR/DSE、配置、RTL 和测试等制品。
来源:2026-10-23(UTC 首提;近期补充),A 级|论文与首提记录 · 架构、性能模型与比较条件 · 原始实现与许可。
平台工程|语义发现与自动化授权分别落地
LookML 索引|把生产指标逻辑带入 Knowledge Catalog
Google 在 10 月 26 日宣布,面向 Looker Core on Google Cloud 的 LookML 语义索引 GA。索引从浅层文件和看板清单扩展到生产模型、Explore 的连接条件与基数、强制过滤器、字段公式和源表血缘,使 Agent 找到数据时,也能读取团队已定义的指标口径。这仍是查询生成的依据,不能把拿到指标公式直接等同于所有答案都经过确定性执行验证。
索引默认开启,但初次启用后文档允许最多一天才可见;元数据权限在项目级授予,可覆盖该项目中已启用集成的全部 Looker 实例。索引 GA 与 Gemini Enterprise 的连接状态需要分开:后者当前文档仍标 Preview,使用终端用户凭据和只读发现工具,底层数据访问另受 IAM 约束。语义一致、可发现和实际可查询,是需要共同验收的不同条件。
来源:2026-10-26,A 级|Google 原始 GA 公告;B 级|同步时间与项目级元数据权限 · Gemini Enterprise 连接状态与访问范围。
GitHub Apps|企业安装 GA 保留分层授权
近期补充:GitHub 在 10 月 23 日将企业级 GitHub App 安装转为 GA,扩大企业仓库政策、ruleset、旁路请求、双因素要求、IP allowlist 与管理设置的 API 权限覆盖,使更多平台自动化可以从经典 PAT 迁往独立授权的 App。
安装必须由 enterprise owner 完成,App manager 没有该安装权;企业安装只授予所申请的企业权限,不会自动获得组织和仓库访问权,需要访问这些资源时仍须分别安装到组织。当前也不支持企业安装的 webhook,API 覆盖并不完整;公告所说的 GHES 3.24 支持仍是后续交付。采用时应逐项迁移所需权限与调用入口,不能把一次企业安装视为全域授权。
来源:2026-10-23(GA 公告;近期补充),A 级|GitHub 原始发布;B 级|安装主体、权限与当前限制。
科研计算|比较平台与调度策略都要对齐条件
Open ISA 比较|软件优化与能耗口径一起报告
近期补充:10 月 23 日 UTC 首提的《Toward Open ISA Supercomputing》,把 Sophgo SG2044、NVIDIA Grace CPU Superchip 和 Intel Xeon Platinum 8480+ 放到共同的软件框架中,比较 STREAM、HPL、HPL-MxP、HPCG 与四类应用。研究同时改变进程放置:SG2044 把进程分散到不同 L2 簇,Grace 与 Xeon 则利用多个内存域;算子实现与进程绑定需要一起评估。
实验采用 Linux 6.12、GCC 14.2、OpenMPI 5.0,以及针对各架构目标优化的 OpenBLAS;HPL 矩阵按平台内存容量选取,并非相同规模。能耗包含风扇和辅助组件功耗的建模校正,不能当作整机插座测量,或据此断言某种 ISA 全面更节能。论文声称公开 HPL-MxP 变体,但截至本次核验,所链 GitLab 项目为空,不能认为代码已经交付。
来源:2026-10-23(UTC 首提;10-26 修订;近期补充),A 级|论文与版本记录 · 已读 v2 的实验与能耗范围 · 论文所链项目的当前内容。
HyDRA|为突发作业联合考虑公平份额与预计期限
近期补充:10 月 23 日 UTC 的 HyDRA,面向固定节点数、不可抢占的 HPC 作业,把项目预算、用户已获得的服务份额和等待时间纳入分层调度。作业到达时获得预计开始期限,临近期限的作业优先处理;后续作业回填时,还需检查队首保留作业的预计开始时间与预算条件。
论文实现调度器,但集群与资源管理器由模拟器代替;实验运行于单台 20 核 Arm、128GB 内存的 DGX Spark,负载由 Polaris 2025 年日志采样、调整生成。对照包括 SJF、WFQ,以及改写的 Themis、PCS、PBS 排序模型,不能称为直接击败这些生产系统。评估仍有作业未按预计期限启动,公平性、尾部等待和利用率存在负载相关取舍,不构成逐作业硬等待上界;正文未给可核验的实现下载入口。
来源:2026-10-23(UTC 首提;近期补充),A 级|论文与首提记录 · 调度机制、模拟负载与期限结果。
端侧与机器人|把响应时间和完整任务放回评测
ExecuTorch 流式 ASR|同时选择分块长度与精度
Arm 团队在 10 月 26 日的工程文章中,将 Nemotron 3.5 流式语音识别经 ExecuTorch、XNNPACK 和 KleidiAI 接到 Arm CPU。文章联合比较 FP16、QC8W 量化与不同音频分块长度:更长的块可改善最终转录准确率,却需要等待更多音频;启用 SME2 只为支持的算子提供相应执行路径,还需原生采样确认哪些 kernel 实际运行。
质量在主机 ExecuTorch/XNNPACK 上,用四个语料共 14,019 条语音评估;设备计时则在 Pixel 11 上,以单个中核线程、ExecuTorch 1.3.1、1,120ms 分块处理一段 24.9 秒录音,各配置两次预热后做一次 tracing。处理时间包含前处理到最终解码,处理余量不等于用户看到首字的延迟。主机 WER、设备整段处理与合成输入估计的首字时间也不能混为同一次实测。
来源:2026-10-26(官方工程评估),B 级|模型到 CPU 指令、质量与设备计时条件。
LADDER|在固定场景中拉长机器人任务
INSAIT 在 10 月 26 日发布 LADDER 基准项目,原论文于 10 月 13 日 UTC 首提,作为近期补充一并阅读。基准在三个仿真套件中提供 145 个任务,把子目标从 1 个增加到 10 个,尽量保持场景与物体条件一致,自动检查任务完成;它区分直接低层策略、文本子目标编排与工具选择式编排,检验长流程失败究竟来自哪一层。
论文与官网还给出 Franka、WidowX 的实体补充实验,但有限任务上的趋势一致不代表任意机器人都可靠。完整 145 任务与只有 10 个任务的 LADDER-Lite 也使用不同评测范围,不能混用排行榜成绩。原仓提供 MIT 代码与 Bridge 策略、评测协议和结果打包入口,并说明项目仍在快速开发;评测输出需要同时保留任务、策略和编排配置,而不能只比较基础模型名称。
来源:2026-10-26(机构项目发布);2026-10-13(论文 UTC 首提;近期补充),A 级|INSAIT 原始发布 · 论文与首提记录 · 官方基准与 Lite 范围 · 代码、评测协议与许可。