AI INFRA DAILY 系统 · 工程 · 研究
网络内 MoE、内核对照与可控世界
日报 ·
- 专家并行
- 内核评测
- 端侧多模态
模型系统|重排通信、内核与误差
INC-MoE|按 token 分带重叠专家通信
10 月 26 日 UTC 首提的 INC-MoE,将专家并行的 dispatch/combine 改写为网络内 AllGather/ReduceScatter。一个持久化 kernel 用不同角色的线程块准备下一带 token、计算当前带、归并上一带;路由和模型权重沿用 vLLM,变化集中在数据移动与重叠方式。
验证使用四个加速器模拟四个专家并行节点,第五个模拟 INC 交换机,具体设备型号未披露。负载为 OLMoE-1B-7B、FP16、DP4/EP4、无张量并行的 prefill,每加速器约 24K–126K 提示 token;双方网络均限制为每 rank 100Gbps,并禁用服务器内互联。
对照是 vLLM 的 ring AllGather/ReduceScatter,不能写成胜过最优 DeepEP。原型说明了网络与算子共同排流水的可能性,但真实交换机、decode 与在线尾延迟仍不在这组验证范围内。
来源:2026-10-26(UTC 首提),A 级|论文与首提记录 · 网络内原型、负载和基线。
JustGoal|把专用内核工具放回相同任务对照
10 月 27 日 UTC 的 JustGoal,是“只给目标”的研究对照配置:保留通用 Claude Code 与 B200 硬件访问,让模型自行建立编译、正确性检查和计时循环。提示仍含数值容差指导,不能称完全没有专家指导;作者在生成结束后另做独立验收。
实验使用 B200、CUDA 13.0,主表计时清空 L2 后读取 CUPTI kernel span,排除 JIT、清缓存和同步开销。在 Fable 5.1 的同模型、单形状任务对照中,专用 harness 未获总体收益;该模型的任务扩展到完整算子定义的全部负载时,harness 仍有帮助。部分生成结果未通过独立复测,这些有限算子实验既不代表完整模型吞吐,也不说明专用工具普遍失效。
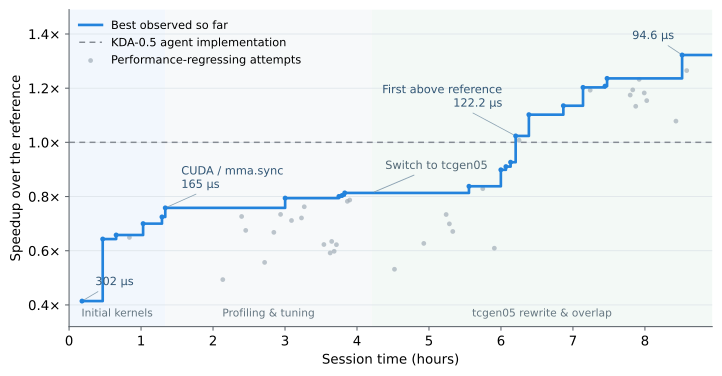
来源:2026-10-27(UTC 首提),A 级|论文与首提记录 · 任务范围、独立复测与计时协议。
ResCom|用激活残差补偿低比特误差
近期补充:10 月 25 日 UTC 的 ResCom,冻结既有量化模型的权重,对激活舍入残差增加低秩补偿分支,并用校准统计量闭式拟合。它把量化时舍弃的信息重新送入计算,代价是额外的因子存储与推理工作,不是免费恢复精度。
精度实验覆盖 Llama、Mistral、Gemma,主要比较同一 SERQ 检查点补偿前后。单 B200 的实现证据要分开看:FP32 量化仿真、紧凑四比特存储后反量化计算,以及另做的 native MXFP4 wrapper。前两者不能证明原生低比特执行速度,后者也仍慢于 BF16;目前适合讨论精度修复和成本,不能据此宣称服务吞吐提高。
来源:2026-10-25(UTC 首提;近期补充),A 级|论文与首提记录 · 补偿机制与三条执行路径。
平台工程|共享资源与浏览器内网入口
ECS MPS|调度时声明共享显存和计算上限
AWS 在 10 月 27 日为 ECS 增加 NVIDIA MPS GPU 共享,容器声明所需显存和可选的最大计算份额,ECS 按剩余容量放置任务。功能覆盖 Managed Instances 与 ECS on EC2,适合单任务无法占满 GPU 的小模型推理、嵌入和仿真,公告没有将 Fargate 纳入支持范围。
Managed Instances 会监测 MPS 控制守护进程,异常时替换实例并迁移任务,这项托管恢复承诺不能直接扩展到所有 EC2 部署。NVIDIA 的机制文档还说明,动态计算份额不保留专属执行资源,致命 GPU 错误可能影响共享相应 GPU 的其他客户端。资源上限和更高装箱率,不能代替租户故障隔离验证。
来源:2026-10-27,A 级|AWS 原始功能公告;B 级|NVIDIA MPS 的资源分配与错误传播边界。
Agents 0.31.0|让浏览器检查接入定义好的内部主机
Cloudflare 在 10 月 27 日发布 Agents SDK 0.31.0,用 internalHosts 把 Browser Run 对指定主机名的请求送往 Agent、工作区文件、开发服务器或另一个 Worker。带目标 schema 的主机还允许模型用 browser.assignHost() 选择端口或目录;分配通过校验后,可跨浏览器替换与重新部署保留。
这让修改产物与真实浏览器检查接到同一运行环境,但只适用于部署后的顶层 Durable Object/Agent,不适用于 sub-agent。最多八个保留后缀主机名,仅 HTTP 80,不支持 HTTPS 或 WebSocket;内部主机不受普通 guardrails 限制,有副作用的处理器仍需验证请求来源。注册内部主机与完成访问授权,是需要分别实现的条件。
来源:2026-10-27,A 级|0.31.0 原始版本发布;B 级|该版本内的内部主机、校验与限制说明。
科研计算|从日志证据走向可微求解
IOSage|先识别 I/O 行为,再生成修改建议
10 月 26 日 UTC 首提的 IOSage,先从 Darshan 日志识别七类已登记的 I/O 行为,再把命中的模式卡、逐文件证据和作业配置交给 LLM。它将日志行为识别与应用修改建议分开,减少对正常日志也提出优化的情况;计数器可见的模式仍不能等同于应用内部的性能根因。
应用验证在 NCSA Delta 的 CPU 节点上实测,每节点双路 AMD EPYC 7763、256GB 内存,使用一至四节点和同一 Lustre 文件系统的磁盘、闪存层。研究者手动应用建议,改动前后各运行 11 次,比较配对的总墙钟时间并审计输出等价,不是系统自动执行修复。
八个应用场景中,六个得到已测有益修改,但提示词也在这些场景上开发,训练外工作负载的泛化明显变弱。代码、模型与测量数据计划录用后公开,不能视为已经交付的通用自动调优服务。
来源:2026-10-26(UTC 首提),A 级|论文与首提记录 · 逐文件证据、配对实测与泛化范围。
diff-soup|把稀疏隐式求解接入自动微分
10 月 27 日 UTC 的 diff-soup,把刚性 ODE、DAE 与 PDE 离散系统放入 JAX 的建模、求解和推断路径。它用自动微分构造稀疏 Jacobian,结合变步长变阶隐式积分与 GPU 上的 cuDSS 稀疏直接求解,让参数估计和嵌入物理模型的神经网络沿同一过程求导,而非以神经网络替代物理方程。
BSD-3-Clause 原仓已有实现、测试、文档和性能验证工具;DAE 支持范围到 index one,GPU 路径要求 Linux x86_64 与计算能力至少 8.0 的 NVIDIA GPU。已接受基线、比较报告和论文研究驱动由维护者在仓外归档,示例结果也含占位值,因此公开工具并不意味着整套论文性能证据已随仓发布。这里的可交付信号是求解与求导实现,收益仍须在具体稀疏结构、精度和规模下比较。
来源:2026-10-27(UTC 首提),A 级|原始论文 · 原始实现与许可;B 级|性能验证工具与仓外基线说明。
多模态|端侧模型与交互世界分别交付
LFM3|同一骨干分出不同模态检查点
Liquid AI 在 10 月 27 日发布 LFM3,将短卷积、滑动窗口注意力与全局注意力组合成共享骨干,分出文本、视觉、音频、Omni 和决策模型。模型卡提供多个推理格式与单 GPU 微调入口,重点是按实际输入和设备选择检查点,而非部署一套固定的大型通用模型。
文本版 LFM3-1.7B 的输入输出合计上下文为 256K;Omni 版则为 2.17B 参数、32K 上下文,接收图像、视频与音频并输出文本或语音,不能把文本版上限移植到全部模态。文本模型卡也不推荐将其用于复杂多步推理或 agentic coding;权重采用 LFM Open License v1.0,落地时须同时核对检查点能力、运行格式与许可。
来源:2026-10-27,A 级|Liquid AI 原始发布 · 文本检查点与定位 · Omni 的接口和上下文范围。
Genie 4|用语言引导带原生声音的交互世界
Google DeepMind 在 10 月 27 日公布 Genie 4,将实时场景生成与原生环境声、音乐、对话结合,允许用自然语言改变场景。Gemini 在循环中观察画面、分解步骤和调整计划,为创作预演、交互原型与机器人研究提供可控制的模拟入口。
当前交付是面向可信测试者的研究预览;Project Genie 消费者和 API 早期伙伴入口仍待后续推出。官方明确说明物体持久性会漂移,复杂物理、空间精度和长时一致性仍待研究。演示中的可控场景并不构成机器人真实任务可靠性或物理准确度的验证。
来源:2026-10-27(研究预览),A 级|Google DeepMind 原始发布与当前限制。