AI INFRA DAILY 系统 · 工程 · 研究
缓存拥塞的反馈、模型行为契约与可编辑幻灯片
日报 ·
- 推理服务
- 行为验证
- 多模态交付
推理与训练|突发之后的缓存反馈,以及前向算力的用途
Basin|流量回落之后,缓存拥塞仍可能持续
Agent 调用变慢会延长会话停留时间,增大的合计上下文又挤压缓存、增加重算,形成自我维持的拥塞。Basin 将会话排序、准入、借用 decode 空闲内存与卸载需求结合,控制这种反馈;只把到达流量降回原水平,未必足以恢复服务。
Qwen3.6-35B-A3B FP8、SGLang+NIXL 的四张 H200 1P3D 测试回放 Terminal-Bench 和 SWE-bench Pro 轨迹。四种突发场景中,作者报告实机原型的有效会话吞吐为 Continuum 的 1.20–1.70 倍。该指标同时要求会话 slowdown 不超过 4,且至少 95% 解码步骤满足 50ms ITL,并非原始 token 吞吐。
实机原型采用到达时间排序与当前上下文准入;预测峰值上下文、按大小固定优先级的完整控制器仍在模拟中验证。单一模型和固定容量的实验,也不足以证明父子 Agent 工作流或动态扩缩容具有相同恢复特性。
来源:2026-11-02(UTC 首提),A 级|论文与首提记录 · 缓存反馈、有效吞吐与原型范围。
BasisKV|同一份 Value latent 减少缓存和通信
BasisKV 将张量并行各分区的 attention 输出压到低秩 Value latent,经 AllGather 后重建完整输出。同一 latent 又用于压缩 Value 缓存,并结合 Key 专用残差选择页面;选中页面后才读取原始 Key 计算精确 QK,压缩目标因此同时考虑完整输出和分布式通信。
八张 L40S 48GB、PCIe 4.0×16、无 NVLink 的测试,在 4K 提示、128 输出、batch 256、Value 宽度 64 的 Llama-3.1-8B 配置下,相对 dense 对照最高端到端加速 1.42 倍。rank、校准语料和页面配置仍影响质量与成本,不能将它解释为严格无损或跨硬件通用收益。
公开代码当前的 compact-vLLM adapter 只支持 Qwen3,尚未交付论文中 Llama 的对应比较路径;它还依赖特定运行时接口,普通 vLLM 安装不足以直接复现。质量评估与系统性能使用的页面协议也不同,复现时需要分别核对。
来源:2026-11-02(UTC 首提),A 级|论文与首提记录 · 低秩机制与系统实验 · 作者仓库;B 级|基准协议与交付限制。
ZO-Curv|空闲前向设备提供曲率,训练仍计算真实梯度
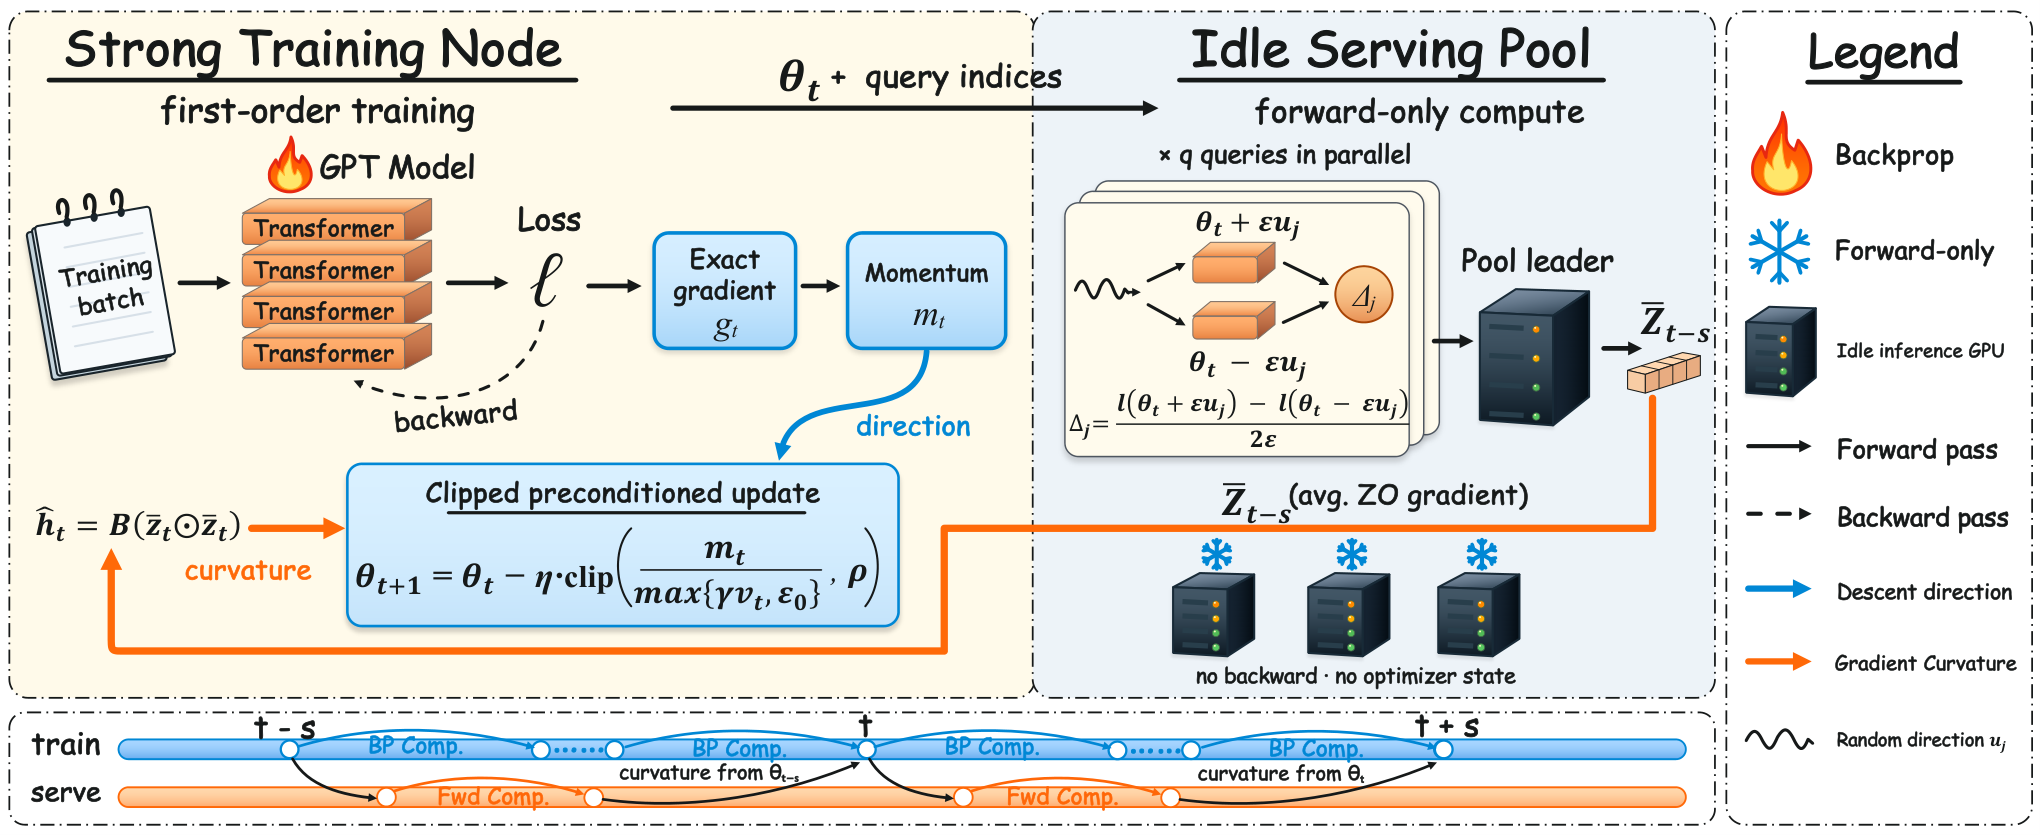
ZO-Curv 让 serving 设备执行扰动前向查询、返回曲率统计,训练节点继续反向传播,并用这些统计调整更新。它利用的是零阶查询中的曲率信息,而不是用噪声零阶梯度直接替代完整预训练梯度。
OpenWebText、125M–1.5B 模型的主实验以八张 H100 模拟 serving 池,计时排除了假定由闲置设备并发承担的查询时间,因此训练关键路径改善不等于总 GPU 成本下降。另一个四张训练、四张前向查询 GPU 的同节点并发实验支持分工的可行性,但尚非大规模异构 serving 集群验证;代码仍计划在录用后开放。
来源:2026-11-02(UTC 首提),A 级|论文与首提记录 · 查询计时口径与真实并发实验。
平台工程|写入可协调,行为基线也要可审阅
Pando|独立协调 ref 更新,复用已有 packfile
OpenAI 披露的 Pando 保留 Git 协议与客户端工作流,将 push 的 packfile 放入对象存储,把 ref 版本及依赖写入元数据服务。不同 ref 可以独立协调更新;fetch 选择已有 pack,通过 packfile-uri 和区域缓存交付,减少逐客户端重新打包的计算。
单个 ref 的更新可串行化,跨分支读取却不保证仓库级同一时点快照。新功能分支默认共享 trunk 基础,也会重复传输 trunk 之外的对象,用更多客户端带宽换取服务端复用。11 月 2 日是工程披露日期,生产服务已从 4 月运行;公开 Git 分发与上游补丁不等于 Pando 后端已经开源。
来源:2026-11-02(工程披露),B 级|OpenAI 原始工程说明。
Transformers MIC|冻结小模型和人工审阅的行为基线
Model Integration Contracts 将保留关键层与原 tokenizer/processor 的小型 fixture、可运行的 Markdown 使用路径、人工审阅的输出基线组合起来。冻结工件在 CI 中检查生成、loss、梯度与优化步骤,覆盖“能运行 forward”之外的行为;LLM 可以起草代码和 manifest,预期输出变更仍需人工批准。
UMT5 历史提交的回放中,SDPA 路径能发现 decoder 看到未来 token 的回归,仅测 eager 会漏掉,说明 fixture 需要保留相关执行路径。这是旧提交的回放证据,不是本周新发生的漏洞。截至文章记录的 11 月 1 日,MIC CI 仅报告失败、不阻断 PR;该提议及公开工具仍需评估覆盖和维护成本,小模型通过也不能替代真实检查点的 nightly 或发布测试。
来源:2026-11-03,B 级|作者工程发布 · 当前证据与覆盖范围;A 级|MIC 原仓库。
科研计算|稀疏算子与论文复现分别限定比较对象
Ascend-SpMM|按稀疏结构分配 Cube 与 Vector 工作
Ascend-SpMM 用内存成本模型分配稠密区域和稀疏残余,协调 Cube、Vector 子内核及输出写冲突,再用分层流水和环形缓冲隐藏访存。Atlas 800I A2、CANN 8.5.0 上,820 个 SuiteSparse 方阵、FP16/FP32、特征宽 128/256 的测试中,作者报告几何平均 12.70–20.55 倍加速。
这里的基线是逐矩阵选出的最强 NPU 实现,不是 A100。跨硬件对照中 FlashSparse 在部分配置更强,不能概括为 NPU 全面胜过 GPU。公开仓库已有算子、PyTorch NPU 扩展和正确性测试,但不包含完整 benchmark、profiling 与绘图流程,算子开放与整套性能可复现仍有距离。
来源:2026-11-01(UTC 首提),A 级|论文与首提记录 · 硬件、逐矩阵基线与跨设备对照 · 作者代码与交付范围。
OmniQ|先核对研究记录,再复用专家确认的修复
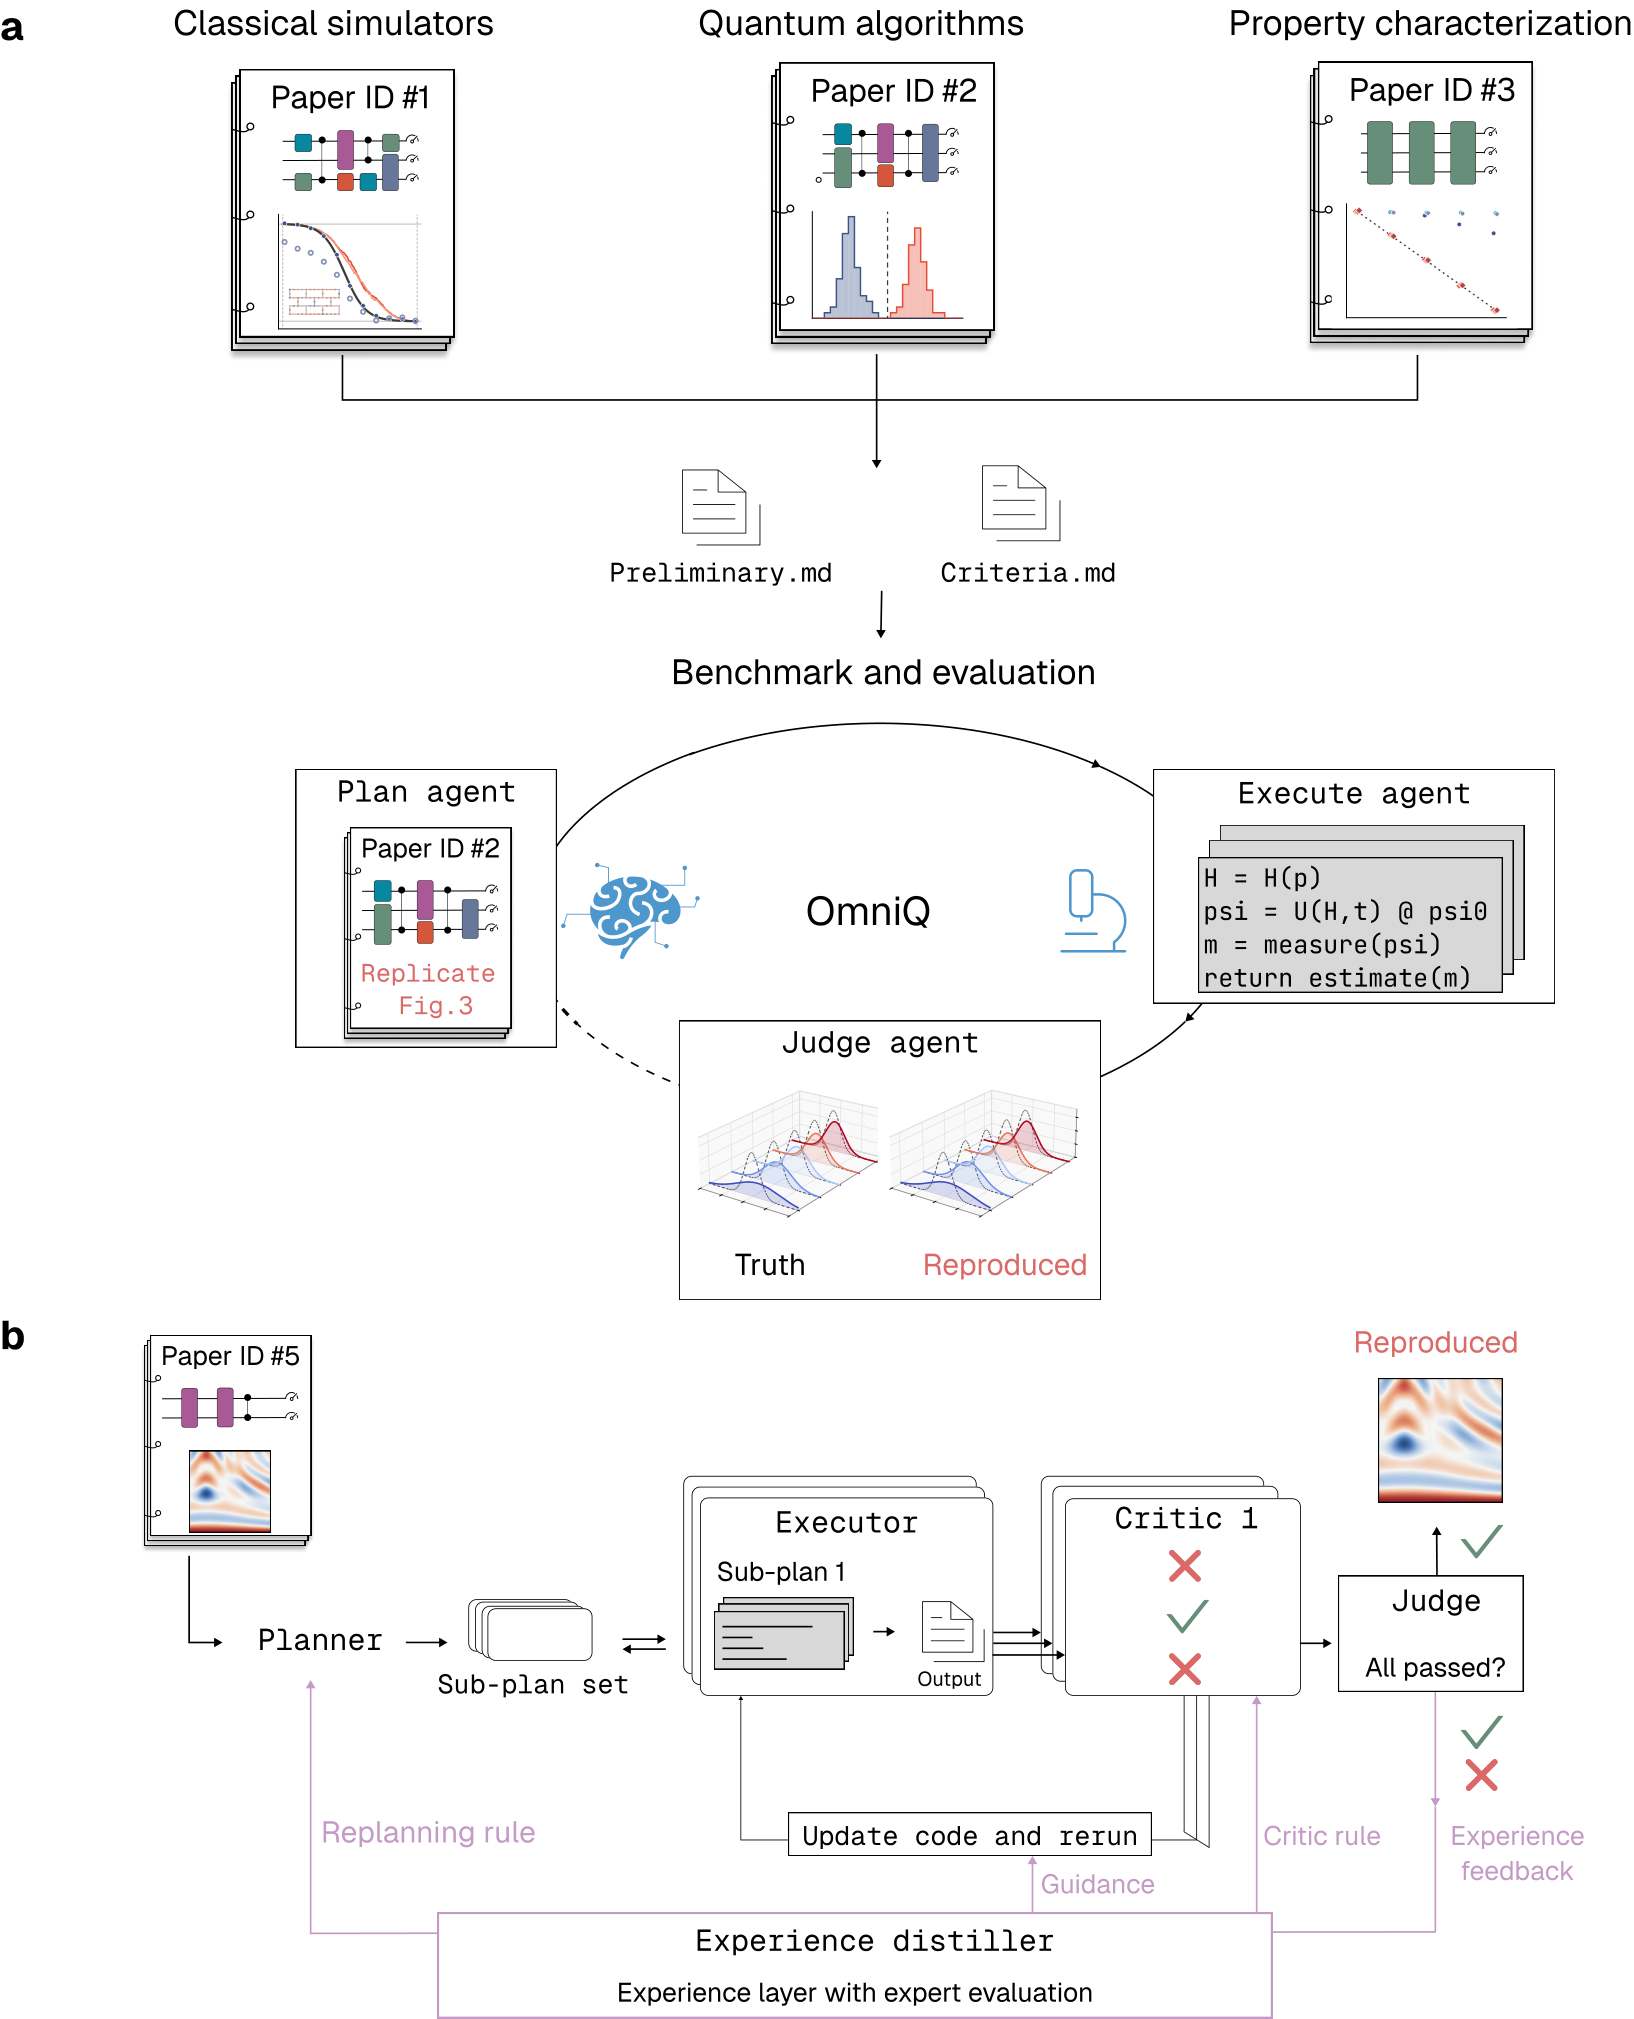
OmniQ 与 Residual Agents 先检查论文、代码和目标结果之间的矛盾,再将专家核验过的修复整理为经验,更新前仍需专家审阅。60 篇量子研究经过清理,排除一个无法忠实复现的案例后形成 59 项任务;它解决的是复现记录和执行链条的缺口,而不只是接通科学工具。
固定 DeepSeek V4.1 Flash+DSH、每任务 24 小时预算下,作者报告复现率约从 68% 升至 85%。经验来自五项开发任务,另外 54 项在开发时未见,不能把 59 项全部称为留出测试。签名证据针对指定计算的复现,不能证明原论文结论正确;完整公共服务也仍计划部署。
来源:2026-11-02(UTC 首提),A 级|论文与首提记录 · 任务划分、专家反馈与服务交付范围。
模型与产品|可修改的中间结构,以及可核实的服务入口
Palette|先编辑幻灯片 brief,再生成和检查代码
IBM Research 的 Palette 将设计与编码拆成同一 20B 模型 LoRA 的两个角色:designer 先生成可编辑 JSON brief,coder 再按单页规格生成 pptxgenjs 代码。渲染检查发现重叠或越界后,另一个 editor 模型提出修复,只在检查指标改善时保留修改,让中间结构成为人和 Agent 都能核对的接口。
PresentBench 的三个领域中,团队报告两项第一、三领域均分第二;完整评测先由另一个前沿模型把源文档变成计划,修复也使用独立模型,因此不是单个 20B 模型独立完成全部流程的证明。几何检查改善也不等于事实完全正确。文章尚未给出本次模型权重或完整 harness 下载入口,便于迁移用户模板的轻量方案仍属后续工作。
来源:2026-11-03,A 级|IBM Research 原始研究发布。
LongCat-2.5|正式服务接上视觉编码与长程训练
美团在 11 月 2 日发布 LongCat-2.5 正式服务,区别于 9 月的 Preview。模型总参数 1.6 万亿、每 token 激活约 480 亿,以多层级离散 token 处理视觉与文本,并将长程轨迹、可验证任务和跨 harness 训练接到智能体编程流程。
技术说明还披露 W4A4 专家权重与激活量化,在 token 复制和分发前完成共享变换,让同一 INT4 表示贯穿通信与计算。这些优化针对团队的国产加速器路径,不能据此为任意 GPU 推断吞吐收益。本次能核实的交付是在线与 API 服务,原文没有提供 2.5 权重下载入口;自有工具链仍需验收图像输入、工具调用和多轮结果。
来源:2026-11-02(正式发布),A 级|美团原始技术发布;B 级|正式版与 Preview 的 API 发布记录。