AI INFRA DAILY 系统 · 工程 · 研究
通信分工、流式落盘与手持机器人数据
日报 ·
- 通信优化
- Agent 持久化
- 机器人预训练
推理与训练|通信分开调,收益还要连同质量核对
GC-MoE|通信与计算分占 SM,再用 Graph 并行执行
GC-MoE 用 CUDA Green Contexts 把 GPU 分成较小的通信分区和较大的计算分区,让 token 分发与 grouped GEMM 使用独立内核、资源预算及同步范围。token ring 的首批数据到达就启动计算,双缓冲计数去掉重放之间的尾部跨 rank 屏障,避免把所有职责塞进同一个融合内核。
八张 B300、GLM-5.2 与 DeepSeek-V4.1-Flash、每 rank 1–256 token 的 CUDA Graph 重放测试中,相对同精度的 DeepGEMM Mega MoE,decode 算子平均加速 1.106 倍,融合 shared experts 后为 1.123 倍。这里没有证明整模型服务吞吐获得同样提升;prefill、大 batch、共享 workspace 的调用串行约束及完整 serving 集成仍需分别处理。
来源:2026-11-03(UTC 首提),A 级|论文与首提记录 · 分区机制、算子实验与限制 · 已公开算子、基准与测试。
ROCm InferaSim|先测少量内核锚点,再预测服务配置
InferaSim 对每组不同内核先做一次实测,将 batch、长度和 GPU 数带来的工作量变化交给分析模型;多节点配置先缩成单节点测量,再补回通信与调度成本。离散事件模拟器重放多轮请求,让部署选择同时考虑首 token、输出间隔和吞吐目标。
AMD MI355X、vLLM/SGLang/ATOM 实验中,11 个锚点用时 9.1 GPU 小时,逐项测量其覆盖的 226 个固定长度配置需 204 GPU 小时;通过测量过滤的 172 个配置,单输出 token 时间的误差中位数为 8.1%。这支持先缩小候选集再实测验收,不代表任意新内核都能直接外推。
硬件测量均在 MI355X 上完成,迁移到 NVIDIA 尚未验证;锚点、语料和脚本计划在 camera-ready 阶段释放。本次 192 组搜索采用确定性种子网格,也不能作为 LLM 调优器优于传统搜索的证据。
来源:2026-11-02(UTC 首提),A 级|论文与首提记录 · 锚点、误差筛选与工件交付范围。
FP4Quant|把通信压到四位,吞吐与收敛一起比较
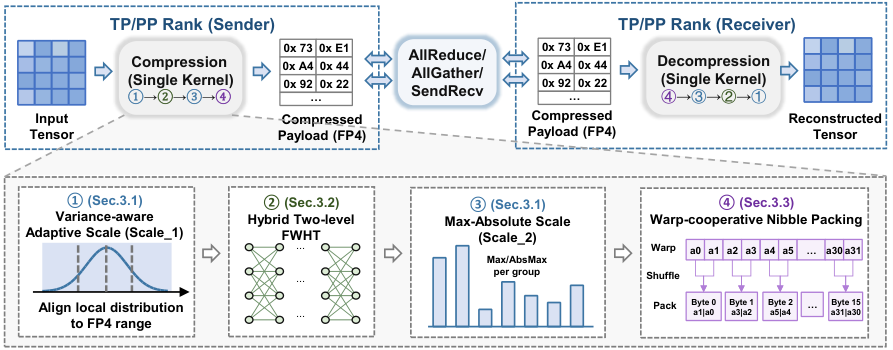
FP4Quant 用微分组双尺度量化、两层 FWHT 和 warp 协作打包,压缩模型并行训练中的传输张量。压缩与还原各放进单一内核,减少低位表示节省带宽之后又被额外执行开销吃掉的风险。
单节点八张 H100 80GB、NVLink、Qwen-7B/OpenWebMath、10,000 步测试中,TP4 的 G64 配置相对 BF16 Ring 提升吞吐 1.40 倍,但困惑度从 8.5893 升至 9.3050。G256 达到最高 1.56 倍时,困惑度已升至 21.3613,不能把最大加速与近似保持质量写成同一个结果。PP 场景仅约 1.01 倍,也说明通信不占主要时间时压缩收益有限。
实验尚未覆盖多节点和更大模型,原文也未提供代码仓库,当前不能视为已交付的通用 NCCL 压缩插件。
来源:2026-11-03(UTC 首提),A 级|论文与首提记录 · 压缩流程、吞吐与质量对照。
芯片与运行时|互联决定资源能否合池,版本决定接口能否使用
Galaxy|低成本芯片合池,先把集合通信的代价压低
一项基于 Tenstorrent Blackhole Galaxy 的研究,把集成通信引擎、流水环传输、计算通信重叠和设备端 decode replay 组合起来。它比较的是一整个服务池每美元能输出多少 token,而非单颗芯片的峰值算力。
32 颗 Blackhole 对八张 RTX PRO 6000 Blackwell Server Edition 的测试覆盖三个稠密模型、BF16 与八位配置、8K–256K 上下文。在三年持续使用、每度电 0.15 美元的购置与电力模型下,作者报告每美元 token 为对照的 1.07–2.24 倍;给同一批芯片模拟 TCP 级通信后,吞吐下降 23.5%–67.4%,所有测试配置的成本优势消失。
该结果依赖价格与利用率假设,不能替代完整机房 TCO。两侧八位格式分别为 BFP8 与 FP8,功耗遥测也分别取芯片核心电源轨和 GPU 板级,不能把比较外推成任意集群的等质量、等口径能效优势。
来源:2026-11-02(UTC 首提),A 级|论文与首提记录 · 互联实现、成本假设与测量边界。
CUDA 13.5|Rubin 支持转 GA,Tile 互操作仍保留预览边界
CUDA 13.5 将 Vera Rubin 支持推进到 GA,MPS 增加资源借用、出借和路由控制,CUDA Tile 则继续把跨 GPU 数据操作放进内核表达。运行时开始提供更细的分工接口,但应用仍需按实际硬件拓扑选择路径。
Tile 到 SIMT 的库函数互操作仍为 public preview,自定义 device 函数不是本次已经交付的能力;多播和归约还需相应 NVSwitch/NVLink SHARP 支持。正式发布说明要求 13.5 新功能和新平台使用支持它们的 R620 或更新驱动,旧 CUDA 13.x 程序可在较早驱动运行的兼容规则不能代替这项要求。
来源:2026-11-04,B 级|NVIDIA 原始技术说明;A 级|CUDA 13.5 正式发布说明。
Agent 与平台|已经显示、已经落盘和已经切换是不同状态
Pi 1.5|流式结果先显示,再批量持久化
Cloudflare Agents SDK 0.33.0 升级 Pi 1.5,把答案与工具输出从逐次写入改成批量持久化,同时减少调度器全会话扫描和大工具调用的重复文本拷贝。界面仍能立即观察流式结果,默认最多约一秒后落盘;崩溃也可能丢失这段已经显示的进度。
session.watch() 提供转录和实时状态,session.continue() 可在会话空闲且没有最终答案时沿既有记录继续运行。继续不等于外部副作用恰好执行一次;已经进入 1.5 格式的会话也不能交给 1.4 读取。升级故障需要向前修复,不能把旧格式回滚当成无损恢复。
来源:2026-11-03(SDK 发布;Pi 1.5 记录为 11-02),A 级|SDK 0.33.0 原始发布 · Pi 1.5 固定版本变更记录;B 级|持久化与升级约束。
Model aliases|客户端保留名称,网关调整模型池
Cloudflare AI Gateway 的 model aliases 让应用请求 custom/<alias>,由网关按保存顺序失败回退,或通过 smart routing 选择目标。运维可以调整模型池和选择算法,而不必把每次模型更换都传播到客户端代码。
alias 只属于一个 gateway,各地点可能短暂使用刷新前的缓存配置。它不会统一不兼容的输入协议,也不绕过认证、计费或策略;smart 无法排序时使用默认顺序。需要条件分支、百分比分流等复杂流程时仍应使用 dynamic routes,这次交付本身也没有证明模型质量或总体成本改善。
来源:2026-11-04,A 级|模型别名原始发布;B 级|缓存传播、协议与路由范围。
机器人与科研|数据能够迁移,结果仍需要真实环境验证
AIRoA-0|手持示范借助同一夹爪迁移到机器人
AIRoA-0 用 16,151 小时 YUBI 手持夹爪示范训练策略,预训练数据不含机器人遥操作、强化学习或机器人纠正轨迹。采集端和执行端共用夹爪及腕部相机,状态和动作围绕夹爪坐标定义,让示范复用建立在具体传感器与动作接口上。
Franka 的十项双臂任务、每项 15 次试验且含部分完成计分时,作者报告平均 78%,最强对照 π0.5 为 27%。四个基线均使用同批任务示范后训练,并逐任务搜索设置;AIRoA-0 使用统一 recipe。其他机器人只展示部分任务,且仍安装同一 YUBI 末端和腕相机,不能概括为任意机械臂直接通用。
论文描述的不足四小时后训练使用单节点八张 H200,不能视为消费设备成本。截至项目页当前状态,权重、数据和后训练代码仍标为 Coming soon;已发布报告与硬件/采集软件入口,不等于整套预训练交付已完成。
来源:2026-11-02(UTC 首提),A 级|论文与首提记录 · 同末端迁移、对照协议与计算条件 · 项目页与实际开放状态。
Cheminformatics Skills|模型编排流程,化学工具执行计算
Google Antigravity 的 Cheminformatics Skills 将文献和分子数据库检索、数据整理、匹配分子对分析及候选反应建议接成可审阅流程。LLM 负责编排和科学推理,RDKit 等确定性工具负责分子计算,并连接 ChEMBL、PubChem,保留可检查的数据和中间结果。
原始发布以 crizotinib/lorlatinib 刚性化案例演示,并通过 Science plugin 交付 skills。所示模型比较使用 scaffold split;稀疏数据、实验室差异和有限的读出范围仍限制预测。提出宏环或合成路线只是待合成、待实验验证的假说,流程执行完成不能替代药效证据。
来源:2026-11-03,A 级|DeepMind 原始发布、工具分工与验证边界。