AI INFRA DAILY 系统 · 工程 · 研究
推理压测加入多轮反馈,Agent 批处理拆开两种并发
日报 ·
- 推理压测
- Agent 调度
- 科研计算
推理与训练系统
LLMRunner|按用户等待时间回放多轮请求
LLMRunner 可固定并发用户数,让每个用户收到回复、等待一段可配置的时间,再带着会话历史发出下一轮。与按固定到达率发请求的测试相比,闭环负载会随服务响应变慢而降低请求生成速度,更接近用户逐轮交互的过程。
作者用一张 48 GB A40 和 vLLM 跑 Qwen3-0.6B,在 64–256 个并发用户的 WildChat 多轮负载中比较默认 CUDA 分配器和统一虚拟内存分配器。两者每秒完成的轮数相差在 2% 内,平均延迟相差在 60 毫秒内。模型和 KV 缓存均在显存中,这组数据只反映未发生显存溢出时的开销。
来源(2026-11-13,arXiv 新刊,A 级)LLMRunner 论文与测试配置。
llama.cpp 1.0|对公开接口采用语义化版本
llama.cpp 与 ggml 同步发布 1.0.0。维护者公布了 C API 和 ABI 的版本策略,将不兼容变更归入主版本。此次把 NextN 推测解码接口从扩展头移进公开的 llama.h,并清理 35 个此前已弃用的函数。
仍调用旧符号的上层封装需要迁移接口,分发二进制绑定的项目也应核对新库与绑定的兼容性。版本号可以提示兼容边界,后端和模型组合仍需分别验证。
来源(2026-11-13,A 级)llama.cpp 1.0.0 发布记录;维护者的版本策略。
SS-HSDP|计算布局和优化器更新各自分片
SS-HSDP 让同一份存储同时提供计算视图和优化器视图。前向和反向可以把 Q、K、V 打包给内核,更新时 Muon 又可以按头处理矩阵。层次化分片帮助两种视图共享底层数据,减少为了切换布局而搬运权重和梯度。
作者用语言和视频模型的合成输入测量训练步骤,比较 PyTorch FSDP2、Megatron-FSDP 和复现的 veScale-FSDP。文中衡量的是算力利用率和显存,尚需长程训练验证收敛与真实数据下的收益。
来源(2026-11-13,arXiv 新刊,A 级)SS-HSDP 论文与实验。
Agent 运行与观测
Ling|任务准入与工具执行分别限流
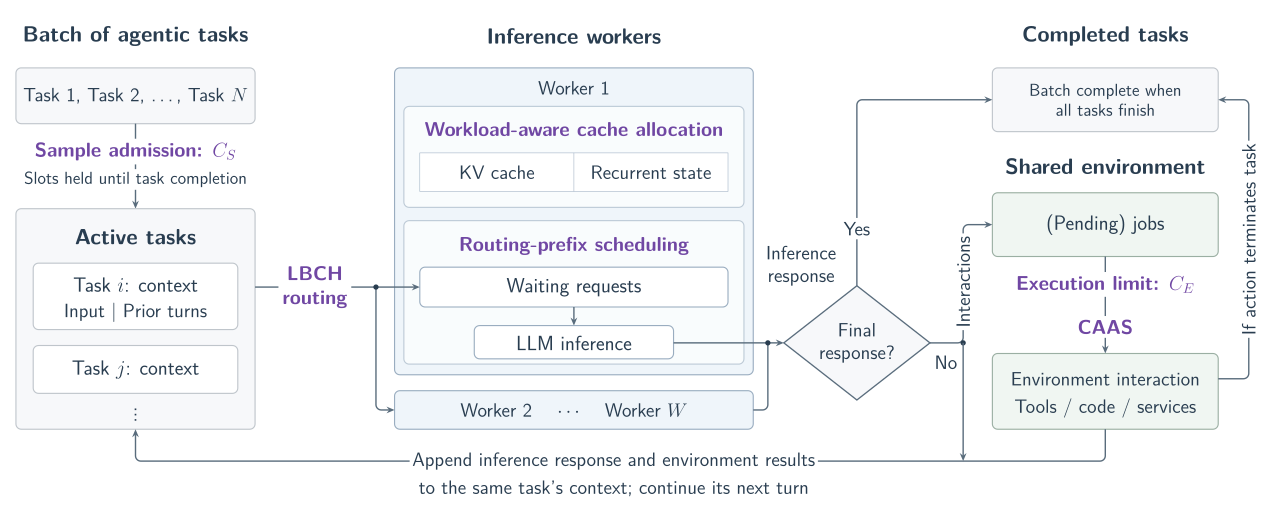
蚂蚁 Ling 团队把批量 Agent 的活跃任务上限和工具执行上限分开。工具队列满时,其他已接入任务仍可做模型推理。推理侧按任务轨迹保留跨轮缓存复用,工具侧根据已观察到的进度优先推进可能拖长整批时间的任务。
在 8 张 H20 上,Ling-3.0-Flash 对 MCP-Atlas 重复运行三批、每批 500 项,工具执行上限均为 3。相对共用并发上限的基线,拆开上限并同时调整推理侧后,按先进先出派发的整批均值从 466.1 分钟降至 168.2 分钟。进一步调整工具派发次序后降至 163.0 分钟。主要收益来自前一组改动,这组实验衡量的是整批用时。
来源(2026-11-13,arXiv 新刊,A 级)Ling 团队的批处理论文。
BigQuery 与 Looker|把运行指标和会话内容分开记录
Google Cloud 给出 BigQuery 和 Looker 的 Agent 可观测性方案。运行指标与经过筛选的官方 Trace 可用于查看请求量、延迟和 token 消耗。更深的会话日志由管理者对单个 Agent 选择启用,提示和回答进入客户自己的 BigQuery 数据集。
受行级权限、列标签或动态掩码保护的知识源会触发跳过该轮日志。自定义 Agent 的插件可采集更细的工具调用树和多模态载荷,接入时要区分采集范围、数据集权限和日志缺口。
来源(2026-11-13,B 级)Google Cloud 可观测性工程说明。
芯片互联与超算
PACER|按预填充负载设定 GPU 频率上限
PACER 研究了短算子触发瞬时功率峰值、随后被固件限频的现象。方案先离线分析各负载的算子,再按在线调度时合批的输入 token 数选择频率上限,减少功率波动引起的反复限频。
在单节点 8 张 MI300X、vLLM 张量并行度 8 的预填充实验中,作者用泊松到达回放 500 条 LongBench 请求。FP8 Llama-3.1-405B 相对默认功率管理的首 token 中位延迟下降约 9%–12%。同一测试的 DeepSeek-V3.2 改善很小,Mistral 的 p99 也可能变差,频率表取决于模型的算子构成和硬件。
来源(2026-11-13,arXiv 新刊,A 级)PACER 论文与功率实验。
RCCL 与 rocSHMEM|GPU 发起通信,SDMA 搬运数据
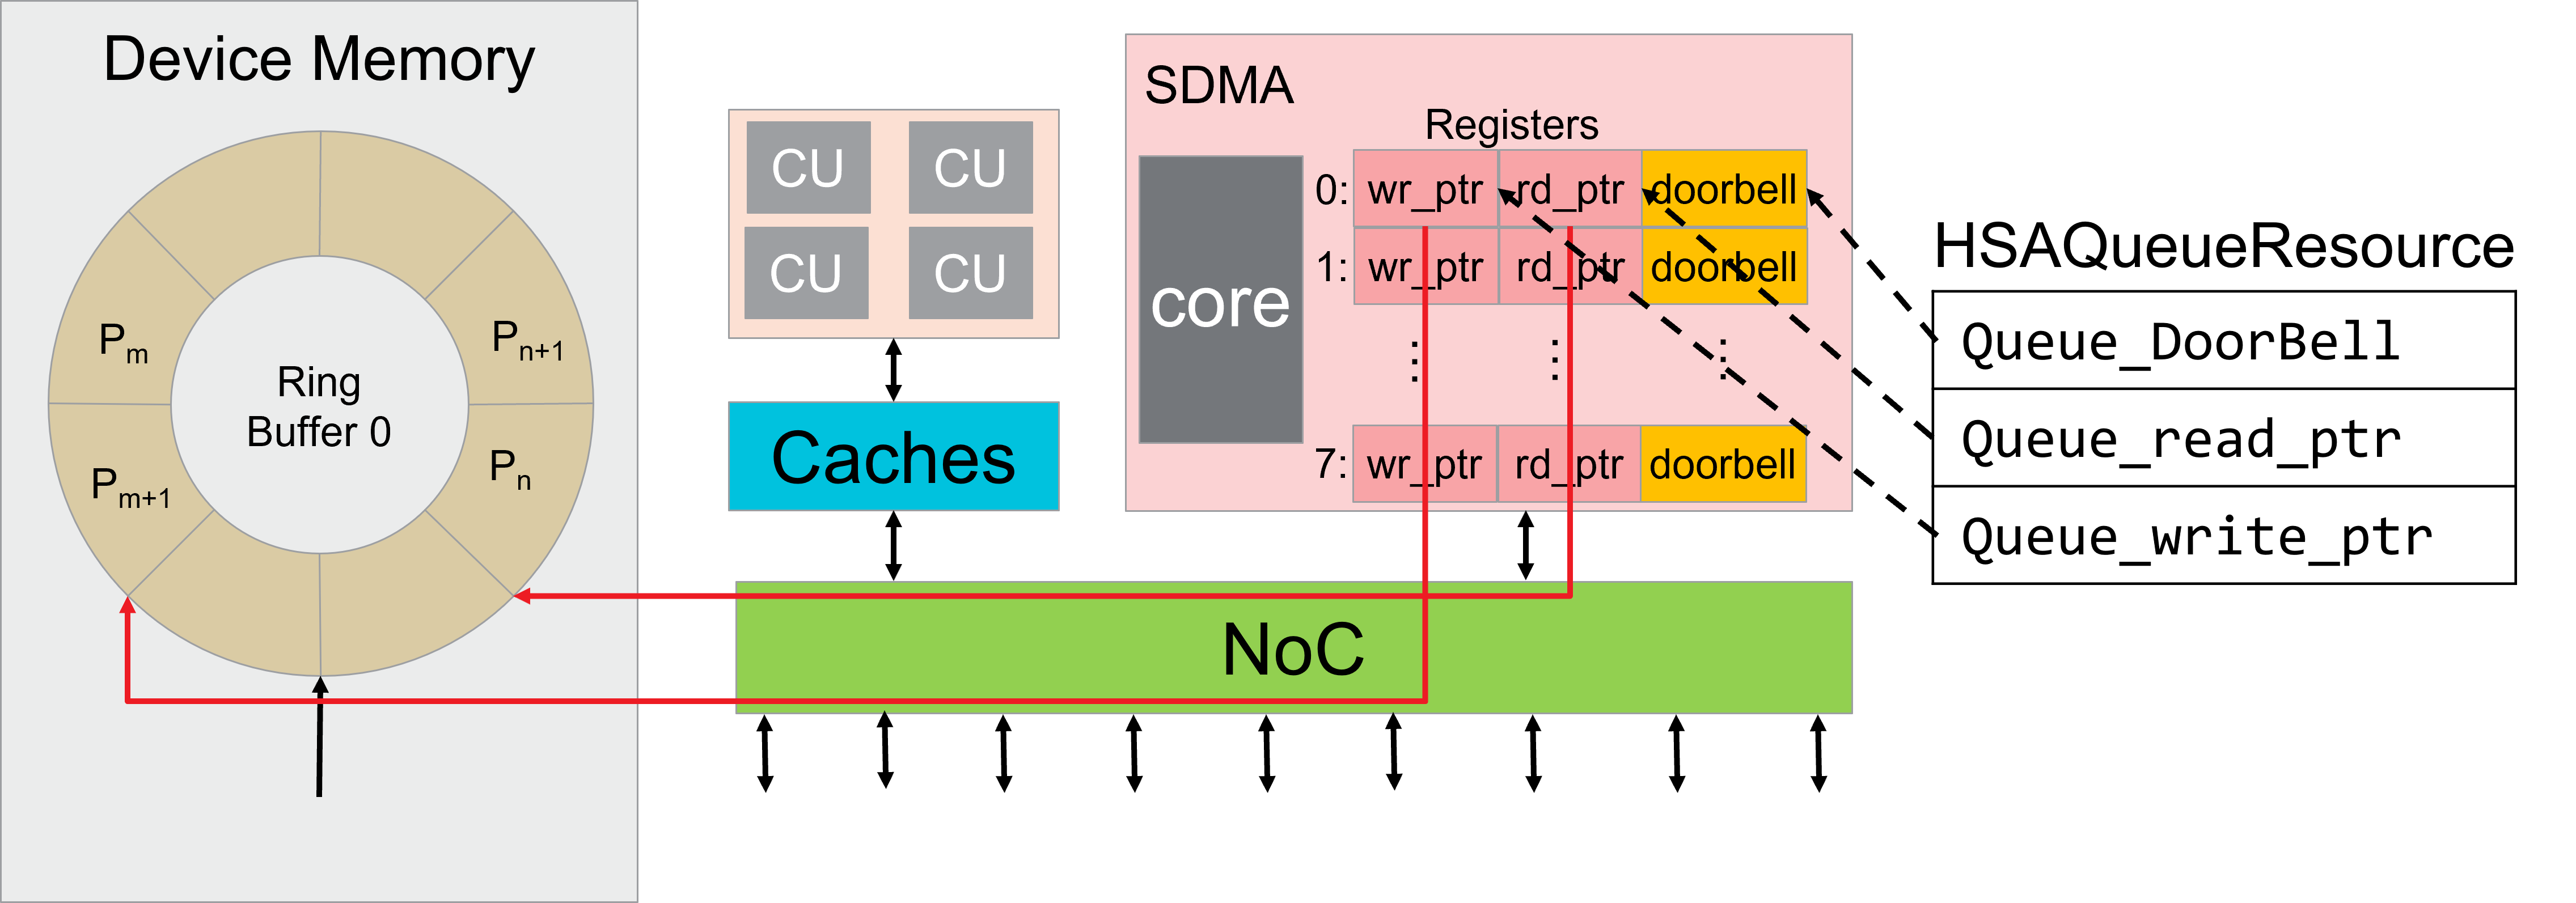
AMD 工程团队公开了 GPU 发起的 SDMA 实测。内核可把节点内复制交给专门的 DMA 引擎,计算单元只负责提交和协调。这样,融合内核有机会把更多计算单元留给模型算子。
在单节点 8 张 MI350X 的集合通信微基准中,SDMA 路径用于大于 32 MiB 的 AlltoAll 和至少 512 KiB 的 AllGather。两者用 1 个计算单元达到与默认加载存储实现使用 64 个计算单元时相当或略高的总线带宽,需注册对称内存。结果只覆盖单节点通信,能否缩短端到端请求仍要测量。
来源(2026-11-13,B 级)AMD ROCm 工程说明与微基准。
Argonne IRI|用 API 串接 Polaris 和 Crux 作业
Argonne 领导级计算设施向现有用户开放 IRI API。用户可以从外部工作流提交、监控 Polaris 和 Crux 的作业,并对挂载存储执行文件操作,查询资源和计算额度信息。
这为实验软件提供了把前处理、排队、计算和结果读取串在一起的接口。当前开放范围是这两套系统,使用仍受账户、分配额度和作业队列约束。
来源(2026-11-13,A 级)Argonne IRI 开放公告;ALCF 维护的接口实现。
百度天池|公布千卡全光互联超节点
百度在大会上公布 1024 卡全光互联天池超节点。其此前公开的超节点参考架构已经讨论过大规模互联用光链路,这次给出了具体的超节点规格。同场公告还称推理芯片 M100 已出货,M300 计划于 2027 年推出。
千卡互联域的使用价值取决于模型的并行布局、实际集合通信和部署条件。本次公告未披露这些负载的测量或新超节点的交付范围。
来源(2026-11-12,A 级)百度大会原始公告。
多模态与工程应用
Decider 1.3|判定结果可附文本位置
Perplexity 发布 Decider 1.3 和蒸馏版 Flash 1.3。判定接口可对同一份输入处理多个独立问题。新版增加 locate,按描述从原字符串返回匹配的文字区间、字符偏移和分数,应用可据此高亮命中内容。
模型可处理文本和图片,locate 当前只接收纯文本,不适用于网页检索增强。两个版本都开放权重,已有应用若用 v1.2 校准过阈值,切换模型后需要复测。
来源(2026-11-12,A 级)Perplexity Decider 1.3 发布与技术说明;产品更新记录。
MechFoundry|从物体描述进入有限元求解
MechFoundry 用 Agent 将物体描述变成候选几何、材料、支撑和载荷,再交给 GPU 非线性有限元求解器。系统用符号距离场描述表面,在自适应八叉树网格上求解,所得结果可反馈给形状或拓扑优化。
团队用 50 个日常与工程物体测试流程,对照了贴体网格的有限元结果。同一问题的两种数值解可用于比较离散方法。Agent 对材料和边界条件的选择还取决于实际工况,论文中的模型评分分歧也较大。
来源(2026-11-13,arXiv 新刊,A 级)MechFoundry 论文与验证。