AI INFRA DAILY 系统 · 工程 · 研究
MoE 专家跨显存与主存调度,Agent 服务可自托管
日报 ·
- 推理运行时
- Agent 部署
- 多模态
推理调度与运行时
Tideway|预填充与解码共用专家池
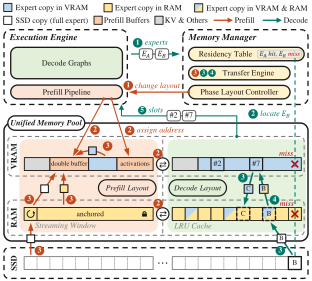
Tideway 将显存和主存视为同一个 MoE 专家权重池,缺页时才从 SSD 读入。预填充阶段固定主存中的专家,用双缓冲把权重送进显存。逐 token 解码时,系统把所需专家映射到固定显存槽,在条件允许时复用 CUDA Graph。KV 缓存先保留显存,剩余空间决定能驻留多少专家。
作者在单张 32 GB RTX 5090 上,把可用主存限制在 16–128 GiB。270 组配置覆盖 BF16 的 Qwen3.6-35B-A3B 和 Gemma 4 26B A4B,以及 FP4 的 DeepSeek V4 Flash,输入 4K–128K token、输出 128–2K token。相对包括 llama.cpp、FreeToken 和两种论文复现方案在内的最快基线,论文报告平均端到端加速 1.97 倍。结果来自单 GPU 的请求实验,多会话如何争用专家池仍待验证。
来源(2026-11-13,arXiv 新刊,A 级)Tideway 论文与实验。
SubGPU Pipelining|一张 GPU 上交错执行解码微批
这项工作把一张 GPU 的流式多处理器分成互不重叠的池,分别执行模型的不同层段。微批依次经过各段,让一个阶段的访存与另一个阶段的计算重叠。流水线填充和分段成本也随微批大小变化。
作者在单张 B200 上用 TensorRT-LLM 和 CUDA Green Contexts 模拟 GPT-OSS 120B 在 32 卡配置中的单个 rank,全局批大小为 2048。相对逐段串行基线,36 层解码迭代时间下降约 10%。实验用虚拟内核估算跨卡通信,实际集群里的网络争用与在线服务尾延迟仍需实测。
来源(2026-11-13,arXiv 新刊,A 级)SubGPU Pipelining 论文。
ONNX Runtime 1.32|按会话规划 CPU 和 GPU 专家卸载
ONNX Runtime 1.32 为量化的 QMoE 和块打包的 MoEPacked 增加按会话规划的混合卸载。新增的 CPU QMoE 内核支持 AVX-512 和 AVX2,并配合内存映射读取专家权重。使用 CUDA 插件时,核心与插件需匹配算子定义。
对接入方而言,能否使用这条路径取决于模型的权重格式和执行提供程序。实际收益还受 PCIe 带宽、专家命中率与请求长度影响,升级前应在目标机器上测量。
来源(2026-11-13,A 级)ONNX Runtime v1.32.0 发布记录。
训练与 Agent 平台
MoE 预训练|并行布局会改变路由轨迹
一项预训练研究固定随机种子、数据和超参,对小型 MoE 比较九种数据并行与专家并行布局。作者追踪到,路由器给两个专家的分数接近时,浮点归约顺序的微小差异足以翻转选择。实验中的验证损失接近,模型的逐样本预测仍出现分歧。
80 次受控运行使用 2500 万至 1.17 亿参数、2000 万 FineWeb-Edu token,覆盖 CPU FP32 与 GPU FP16。结果说明这组实验中损失曲线不足以判断两次训练的路由是否一致。更大的模型和集群是否重现同样的分歧幅度,需要独立测量。
来源(2026-11-13,arXiv 新刊,A 级)MoE 预训练并行布局实验。
Claude Managed Agents|会话服务和沙箱进入同一自有环境
Anthropic 发布 Managed Agents 自托管方案。此前已有沙箱自托管选项,这次把 API、Agent 循环、会话历史的 PostgreSQL 存储以及执行工具的 worker 都交给部署方。应用仍可沿用相同的 API,团队负责部署、升级和数据库运维。
每次模型调用发送到所配置的推理提供方,进入模型上下文的工具结果也会随请求传出。部署评估要分别核对会话落盘位置、模型出站数据和托管版特有功能。安装包须通过 Anthropic 客户团队获取。
来源(2026-11-12,B 级)Anthropic 自托管架构与要求。
Organization Policy|查询生效策略,再用样本检查草案
Google Cloud 为 Organization Policy 增加 MCP 查询能力,可读取组织、文件夹和项目上的策略,并查询资源最终生效的规则。工程团队可用同一任务上下文比较继承结果,再用 Gemini 辅助起草 CEL 自定义约束,以合规和违规的配置样本检查表达式。
查询沿用 IAM 权限。样本能验证输入覆盖的规则分支,变更前还要覆盖关键资源类型和继承层级,确认实际影响范围。
来源(2026-11-12,B 级)Google Cloud Organization Policy 工程说明。
超算标准与硬件
OpenMP 6.1|设备团队可按网格组织
OpenMP 架构审查委员会发布 6.1。新规范增加设备端团队的网格执行模型,并通过 dyn_groupprivate 表达动态分配和管理的组私有存储,还扩展了线程亲和性控制。对于有分块或邻域访问的 HPC 内核,这让源代码能更直接地表达线程组和局部工作空间。
规范定义程序语义,编译器、设备运行时及目标硬件仍需各自实现。试用时应核对工具链覆盖的指令和存储语义,再用目标内核测量。
来源(2026-11-12,A 级)OpenMP 6.1 正式发布。
AMD Helios|同一机架方案新增两档显存选择
AMD 公布 Helios 的 MI450X 选项,每颗 GPU 配 288 GB HBM4。MI455X 配置为 432 GB。AMD 的产品规格列出两者相同的峰值显存带宽,这使显存容量成为选型差别之一。调度侧需要算清模型权重、KV 缓存和并行切分能否在较小的显存预算下同时容纳。
本次披露的离线推理测试使用 MI455X,MI450X 的在线延迟、实际交付周期和总成本仍待核对。
来源(2026-11-12,A 级)AMD MI400 系列公告。
模型、机器人与科研
Inkling 2 Small|开放权重后可自选推理栈
Thinking Machines Lab 在 11 月 5 日开放模型试用,11 月 12 日放出可下载权重。模型接受图像与文本输入,生成文本,总参数约 5940 亿,每 token 激活约 170 亿。权重采用 Apache 2.0 许可,发布方提供 NVFP4 与 MXFP8 版本。
每 token 激活量影响计算,部署还要为整组专家权重和 KV 缓存留空间。模型卡按量化方案分别列出多 GPU 配置,接入方还需验证量化实现、上下文长度和并行切分。
来源(2026-11-12,A 级)Thinking Machines Lab 权重发布更新;官方模型卡与权重。
VBot Exo2Ego|用第三人称录像生成第一人称视角
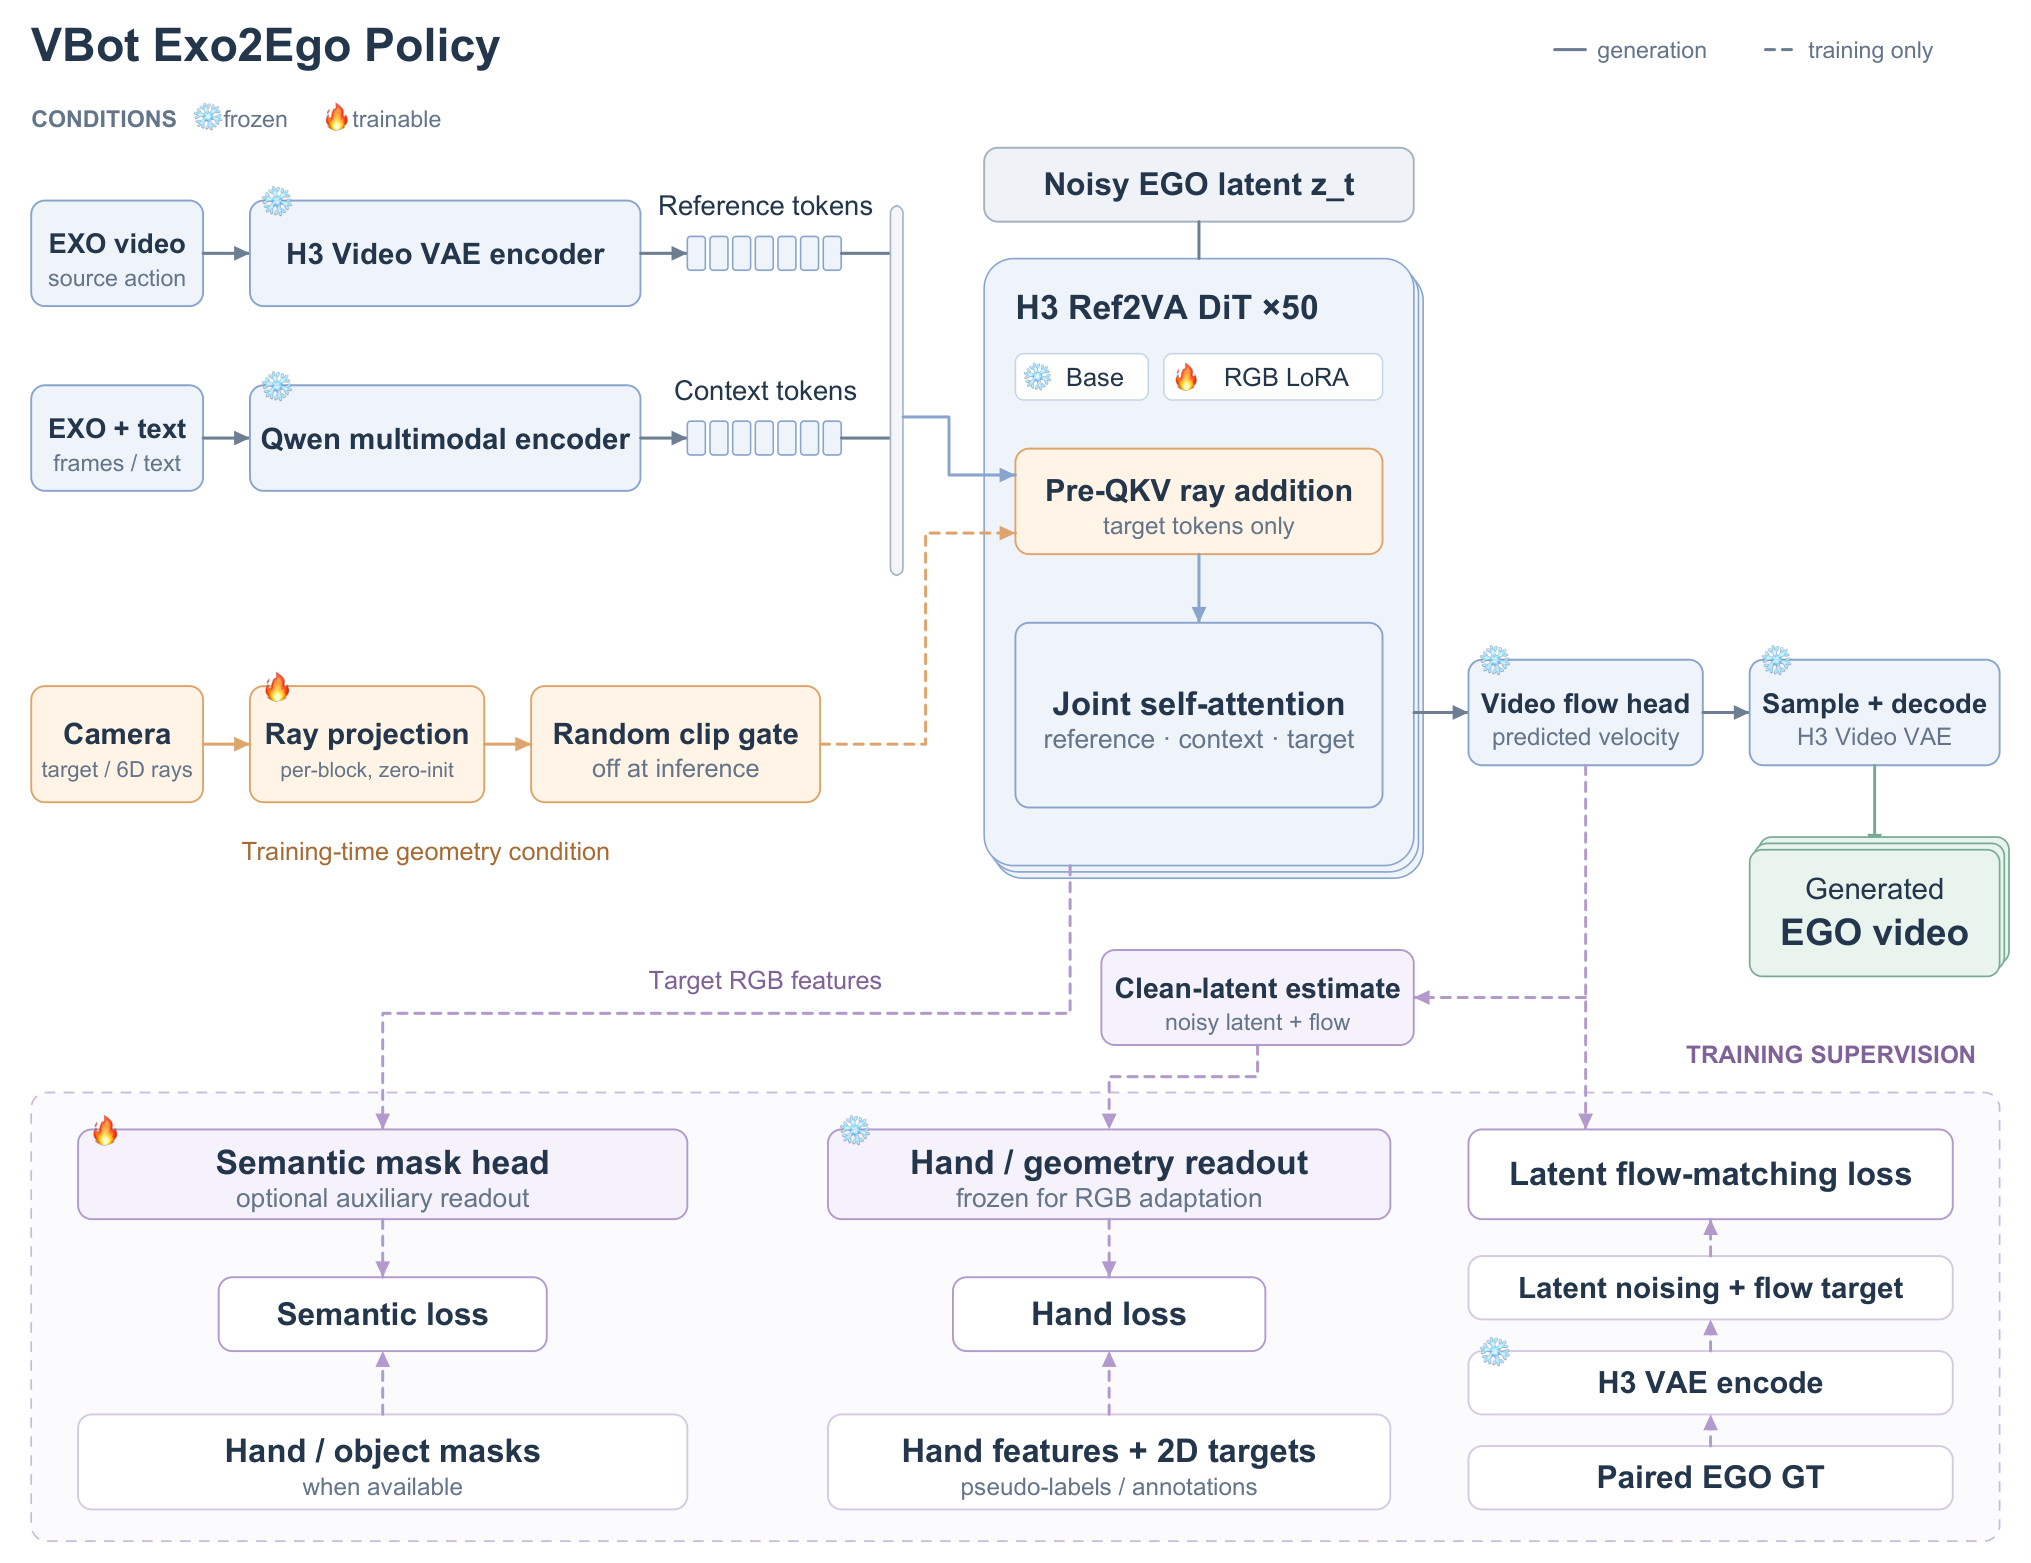
VBot 用移动采集装置录制配对的第三人称和第一人称视频。训练中用目标相机的几何信息,以及手部和语义监督约束视频生成。相机几何条件逐步退火至零,推理时可以用第三人称视频和语义提示生成第一人称画面,无需标定目标相机。
论文评估了画面保真度,以及从生成视频中恢复手部关键点和交互区域的效果。这为难以大规模采集的第一人称素材提供了一条补充路径。合成数据能否改善实际机器人的闭环操作,仍需在控制任务中验证。
来源(2026-11-13,arXiv 新刊,A 级)VBot Exo2Ego 论文。
SatWeave 与 PARDIG|开放卫星拼图与全球降水估计
Google DeepMind 开放 SatWeave 和 PARDIG。SatWeave 将地球同步气象卫星的 17 个通道拼到同一网格,方便对齐不同区域的观测。PARDIG 用轨道降水雷达样本监督模型,结合卫星拼图和 ECMWF 数据,在约 10 公里的网格上生成每 15 分钟一帧的全球降水估计。
两份数据可用于跨区域的天气模型训练或验证。PARDIG 的近实时产品仍有数小时延迟,训练雷达样本未直接覆盖约南北纬 67 度以外区域。用它检验极区和强降水时,应另找独立观测。
来源(2026-11-13,A 级)Google DeepMind 数据开放公告;PARDIG 方法与验证。