AI INFRA DAILY 系统 · 工程 · 研究
解码状态与激活卸载,传输时机决定优化空间
日报 ·
- 数据传输
- 激活卸载
- 推理运行时
推理与训练|状态表示和传输时机需要共同设计
近期补充的 ReplaySSM 研究在 NVIDIA 10 月 12 日的工程介绍中进一步展开:SSM 状态表示为高精度 checkpoint 与近期输入缓冲,普通步骤读取二者计算输出,缓冲填满才更新 checkpoint;推测解码通过缓冲指针提交或丢弃草稿,减少逐草稿保存完整状态。
低精度读取副本不参与后续高精度递归,降低误差累积,却不等于输出没有误差。编辑判断是,固定大小的 SSM 状态也可能成为内存流量瓶颈,缓存应该围绕更新规律设计。作者的四模型评估使用每模型单张 H100 或 B300,batch 1 未见加速,不能外推所有解码负载。
作者仓库还区分已合入上游的 Mamba-2 标准解码与仍需 fork 或待合入的其他路径,不能把一项支持写成 GDN、推测解码和量化 kernel 已全部交付。论文首提交:2026-10-09(UTC);工程介绍:2026-10-12。
来源 A 级:ReplaySSM 原论文、作者实现与集成状态;配套 B 级材料:NVIDIA 官方工程介绍。
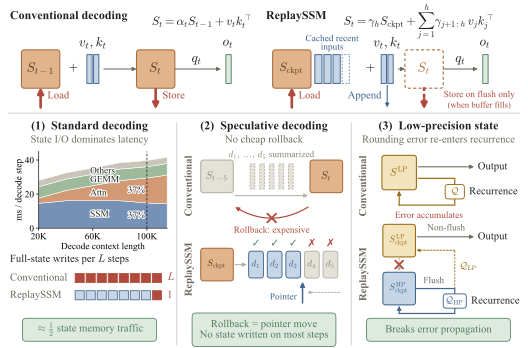
Ze-Wei Liou 等,论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。
llama.cpp 的 b11574 预发布版本从更低层减少数据移动开销:Hexagon 后端将连续短行合并进 DMA descriptor,对非连续 CPY 与 dim-0 CONCAT 使用线程化 HVX gather 路径,并用双缓冲重叠 DMA 与向量运算,同时修正多设备 session 同步竞态。
对设备运行时的启示是,模型中的复制与拼接也需要按目标硬件整理访问模式,不能只比较矩阵乘法 kernel。维护者讨论主要针对 CPY、CONCAT 较重的小型 Qwen3.x 模型,日志中的手机、驱动与量化条件不足以形成统一基准,因此这里不引用性能倍数。它是 Hexagon 的特定优化,不能推导其他 llama.cpp 后端的收益;发布仍标为 Pre-release,目标设备需要复测。
发布日期:2026-10-12。来源 A 级:b11574 原始发布、对应原仓库变更。
近期补充的 SlackSwap 将主机链路时间当作训练资源预算。它根据一次迭代 profile 优先交换重计算代价较高的激活,再以重计算较便宜张量填补内存缺口;FIFO 卸载与最早截止时间优先预取,减少逐层同步。编辑判断是,激活卸载不能只按显存缺口选择张量,还要判断传输能否藏进计算窗口。
论文结果全部来自模拟,主评估基于单 GPU、A100 与 PCIe 4.0 假设,模型状态驻留 GPU,覆盖 BERT-Large、GPT-2 XL 等负载。模拟器未计入分配器碎片、拷贝的 HBM 竞争和多 GPU 共享链路,与梯度卸载流量结合也属后续工作,不能称为已完成实机训练验证或可直接部署的 PyTorch 实现。
论文首提交:2026-10-09(UTC)。来源 A 级:SlackSwap 原论文。
平台工程|外部证据入口和修复动作应留下可检查的交接
Cloudflare Agents SDK 的新发布同时补充网页读取与嵌入式 harness:web_fetch 将网页、PDF 和支持的 Office 文档转换为可读文本,返回最终 URL、状态码、内容类型及分段读取位置;实验性的 OpenCodeHarness 则把 OpenCode 2.0 放进 Durable Object,以 SQLite 保存会话,用 Lifecycle jobs 在对象被驱逐后唤醒中断工作。
编辑判断是,Agent 平台应同时管理证据来源和持久任务状态,让读取、暂停与继续具有明确接口。部署方仍需设置允许的 host、响应大小、超时与重定向规则,文档转换不能证明内容可信或提取完整;会话持久化和任务唤醒也不能单独证明外部副作用恰好执行一次。OpenCode 适配仍属实验能力,应按实际插件与运行环境验收。
发布日期:2026-10-12。来源 A 级:网页读取原始发布、OpenCode harness 原始发布。
Daimler Truck、CGI 与 AWS 的 SRE 案例把这类交接放入事故处理:SRE Agent 规范化告警,DevOps Agent 做只读调查,独立 Dev Agent 在允许的仓库内准备补丁、执行检查并创建带事故时间线与结果的 PR,工程师审核后再部署。
DynamoDB 告警去重、状态授权与限流、成本熔断分别限制重复运行、动作范围和异常支出。对 FDE 的启示是,诊断结果应成为有结构的修复输入,修复产物应进入既有工程审查入口。案例只处理严格验证过的已知故障类型;文中已有沙箱检查,但扩大测试覆盖仍列在后续计划中,不能写成所有故障都能无人审批修复,也不能把客户报告的耗时节省当成通用基准。
发布日期:2026-10-12。来源 B 级:Daimler Truck 与 AWS 原始工程案例。
芯片与云部署|集成层次决定哪些能力已经成立
Microsoft 宣布 Maia 200 已承载其生产工作负载,同时公布 Maia 300,并计划从 2027 年起扩大到多吉瓦部署。Maia 300 的设计针对长上下文、内存密集和 decode 为主的负载,以软件定义 dataflow、片上 scratchpad、低精度格式和 Ethernet 系统互联减少跨层搬运。
编辑判断是,云端自研推理系统的价值需要结合真实服务、内存与网络布局评估,单芯片峰值不足以描述机架和数据中心能力。Maia 200 的当前服务状态、其他产品年末接入计划与 Maia 300 的未来部署应分别理解;公告中的吞吐与能效是公司主张或预期,缺少足够统一的模型、负载和比较细节,这里不引用数字,也不写成 Maia 300 已量产部署或任意模型已完成验证。
发布日期:2026-10-12。来源 A 级:Microsoft Maia 原始公告。
AWS 的 Ray LLM 多节点 DLC 工程示例则将 vLLM、Ray Serve、NIXL 与 EFA 软件栈放进维护的容器,在 EKS 上用 CPU head 与两个 GPU worker 分别执行 prefill 和 decode,并通过单一兼容端点提供服务。编辑判断是,依赖组合由容器维护,可以减少部署拼装,但运行时仍需确认 KV cache 走的是预期传输后端。
示例明确选择 LIBFABRIC,检查实际后端,且将 GPU 节点放在同一可用区;连接成功不代表 EFA 已被使用,分离两阶段也不保证传输开销小于收益。本例展示的是 P/D 分离,不是把权重切分到两节点,因此不能据此声称单节点装不下的模型已被验证可运行;镜像、设备支持、权限与模型配置仍需逐项匹配。
发布日期:2026-10-12。来源 B 级:Ray LLM 多节点官方工程示例。
科研计算|复用模型和分散配额,都需要保持语义一致
近期补充的 Mesh-Native Tokenisation 提出以物理坐标定义局部窗口的 Mesh-Native Convolution,将规则网格 CNN 编码器、解码器的预训练权重迁入连续核,同时保留原模型处理器。作者在 The Well 的流体与活性物质数据及非结构网格绕圆柱流动任务中检查迁移和有限微调。
编辑判断是,科研基础模型复用需要先处理离散表示与预训练接口的兼容关系,改变网格不只是重排输入。规则网格等价与连续极限依赖采样条件,不能外推任意网格密度或长期物理稳定性;论文也保留零样本比较中的基线例外。完整代码、适配权重和不规则网格仍是审稿后发布计划,不能称为已完成开源交付。
论文首提交:2026-10-08(UTC)。来源 A 级:Mesh-Native Tokenisation 原论文。
另一篇近期补充研究将 Snellius、LUMI、Frontier 的独立队列与异构 GPU 配额组织为一次 LLM 预训练:弹性外层聚合处理站点加入退出,DARL 通过心跳租约、过期回收及先检查点后确认数据块维护消费记录,调度器依据 Slurm 非特权排队探测规划提交位置。
对科研平台的启示是,跨设施训练需要共同管理队列准入、数据消费和模型版本,不能仅把通信链路连起来。实测只覆盖 Qwen3-0.6B、C4 的单 epoch 设置及所选设施,未提供下游基准;作者承认集中式对照在质量和用时上更好。队列收益来自理想化推算,租约覆盖结果也只适用于所述协议和站点退出场景,不能写成通用生产提速或任意网络分区下的保证。
论文首提交:2026-10-02(UTC)。来源 A 级:Cross-Facility LLM Pre-training 原论文。