AI INFRA DAILY 系统 · 工程 · 研究
显存驻留与 RDMA 流控,把资源压力交给软件
日报 ·
- 内存管理
- RDMA
- 推理准入
推理与训练|驻留策略、通信窗口和准入共同决定资源压力
近期补充的 Ember 将冷区保留为主机映射,把热区提升到 GPU,并主动批量回收冷区。静态方案使用现有 CUDA 接口;自适应方案修改 UVM 驱动,以访问计数决定区域放置。编辑判断是,超过显存容量的工作集需要控制迁移量和热区驻留,不能仅依赖缺页后的搬运。
论文的 LLM 实验在 RTX 5080、A40、H200 上把可用显存统一限制为 16 GB,使用量化 Qwen2.5-14B、Qwen3-32B,以 512-token 输入后生成 128 tokens,统计解码阶段,对照原生 UVM 等放置方案。这些实验不代表高并发服务吞吐;框架只管理 cudaMallocManaged 内存,自适应方案还需加载修改后的内核模块,多 GPU 属后续工作。
论文首提交:2026-10-09(UTC)。来源 A 级:Ember 原论文、实验配置与实现局限。
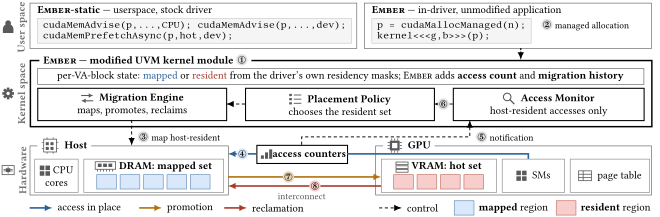
Senad-Leandro Lemes Galera 等,论文图 6 · CC BY 4.0,原图未修改。点击图片查看大图。
近期补充的 ByteExpress 则把控制放到 RDMA 的软件通信层:注册内存分配、零拷贝所有权、QP 复用、接收 credits、发送窗口与 RPC 恢复共同处理连接规模、突发流量和服务失效。作者披露的是已有生产经验。
推荐服务实验使用 300 个参数服务器、124 个 rankers 与 25 Gbps ConnectX-5,在匹配操作负载下,参数 Fetch 的 P99 从已部署内核 TCP 的 63.1 ms 降到 35.5 ms;它测量的是参数读取,不能外推为 LLM token 延迟或端到端推荐加速。
训练对照还显示,仅硬件拥塞控制的尾延迟可能更差。编辑判断是,硬件卸载需要配合有界的在途数据与恢复协议;观察期无 PFC pause 不意味着可以关闭 PFC,RPC 重试也未证明副作用恰好执行一次。
论文首提交:2026-10-08(UTC)。来源 A 级:ByteExpress 原论文、线上对照与流控条件。
同样属于近期补充的 vLLM v0.31.0 在服务层增加独立的 RUNNING 请求准入上限,依据等待 prefill 数调整分块,并优先调度已经持有 KV blocks 的等待请求;版本同时修正 KV connector 与 MTP 在缓存压力下的死锁。编辑判断是,并发上限、输入排队与缓存占用应作为关联的调度参数验收。发布没有提供这些变化的统一硬件和负载基准,因此不引用性能倍数,也不把一项修复推导为所有配置均无死锁。升级还包含请求级多模态参数的信任门控、参数更名及量化配置迁移,应按实际模型和旧配置检查兼容性。
发布日期:2026-10-05。来源 A 级:vLLM v0.31.0 原始版本说明。
平台工程|语言互操作与调查工具需要保留能力边界
Google 的 ADK 五语言工程介绍展示 Python、Go、TypeScript、Java、Kotlin 的原生实现,通过 MCP 接工具、A2A 接远程 Agent,让不同运行时共享协议。Kotlin 的 KSP 在构建时生成工具 schema,TypeScript 使用显式 schema,语言差异进入了具体接口设计。
对 FDE 的启示是,Agent 可以进入既有服务或客户端栈,减少单独引入一种运行时的需要,同时保留协议级交接。五种语言的成熟度仍有区别:Kotlin 仓库明确标为 Preview/Pre-GA,Graph Workflow 仍属实验能力,ML Kit 后端尚无 tool calling;协议互通不能推导能力完全等价或所有本地模型都能执行工具。本文是工程介绍,不是五语言全部 GA 的公告。
发布日期:2026-10-13。来源 B 级:Google ADK 官方工程介绍;配套 A 级材料:Kotlin 原仓库与状态声明。
AWS 的 Session Manager 日志参考实现把调查接口接到既有运维记录:会话结束、完整 transcript 上传 S3 后,Lambda 关联 CloudTrail 身份上下文,交给 Bedrock 分类,将摘要存入 DynamoDB 并按类别告警;调查者再通过 AgentCore harness 与 Gateway 调用查询工具,读取摘要和原始日志。
编辑判断是,平台应把模型结论与可追溯的会话、身份和查询接口一起交付,让人工调查能够回到原始证据。公开 CloudFormation 样例已有对应组件,但这是会话结束后的分析,不能称为实时阻断;分类受提示词影响,材料未给出准确率、误报率或独立安全基准。样例仍需适配生产权限、日志覆盖与成本,不能替代既有检测体系。
发布日期:2026-10-13。来源 B 级:AWS 原始工程教程;配套 A 级材料:公开参考实现。
调度与云运行时|开放控制面和镜像版本共同约束部署选择
NVIDIA 将完整 Run:ai 平台开源,公开仓库包含控制面、集群服务、安装器与客户端;KAI Scheduler、GPU Fractioning Operator、KAI Resource Management、Workload Map 也可分别采用。编辑判断是,组织配额、GPU 放置与工作负载描述可以分层集成,平台团队能按已有栈选择所需组件。
Workload Map 只描述工作负载结构,本身不调度、排队或自动伸缩;CUDA 原生 GPU fractioning 也依赖兼容驱动与容器栈,不能因为代码公开就认为现有节点已满足条件。源码许可与 NGC Community Product 的下载条款应分别核对,社区产品不包含 NVIDIA 企业支持,也没有可直接外推的通用利用率收益。
发布日期:2026-10-13。来源 A 级:NVIDIA 原始开源公告、Run:ai 完整原仓库。
Google Cluster Director 的 GA 镜像更新则给出更具体的运行边界:Ubuntu 24.04 LTS 镜像组合 Slurm 26.05、NVIDIA driver 595 与 CUDA Toolkit 13,支持矩阵区分 A4X 的 Arm 镜像和 A4、A3 Ultra、A3 Mega 的 x86 镜像。
对云端训练与科研作业的启示是,把操作系统、调度器和 GPU 软件版本作为一个部署单元选择,并继续核对控制器兼容性。文档要求计算节点的 Slurm 版本不高于控制器;25.05 控制器不能接入 26.05 节点,而且控制器版本在集群创建后不能直接更改。新镜像可用不等于现有集群自动升级,更不能把镜像支持写成应用性能已验证。更新日期:2026-10-12。
科研计算|数据格式与批处理接口需要同科学含义一起迁移
近期补充的 cuPhoton 工程介绍把 FITS 读取、天空坐标对齐、点扩散函数匹配与相减、残差拟合和候选复核组成科研流水线。xDataReader 在 CPU 规划字节范围,将读取与支持的 GZIP 解压衔接到 GPU,后续模块尽量保持数组驻留。编辑判断是,科研加速需要同时保留坐标、像素对应关系和人工复核接口。
教程使用可在 DGX Spark 或单 GPU 工作站运行的小型合成图像,多 GPU 示例按完整图像对分配任务,并以未训练模型检查启动和完成。性能图比较 GB200 NVL72 与 x86 CPU 的单项操作,不是整条流水线的加速倍数,也未证明观测识别准确率。GPUDirect Storage 依赖兼容驱动和文件系统,FITS 压缩支持也有限;源码可检查,真实观测数据不随仓库提供。
工程介绍日期:2026-10-07。来源 B 级:cuPhoton 原始工程材料;配套 A 级材料:源码与环境说明。
近期补充的 A-GHOST 原型研究把高能物理触发级数据接入 GPU 后端:IGX Thor 上的同机软件发送器,经 ConnectX-7 外部线缆回环将数据送入 GPU 可访问缓冲,CUDA 再整理成持久化 TensorRT 输入窗口,分开处理网络包粒度和模型批处理。实验负载来自 Pythia/Delphes 模拟碰撞,压缩为十个领先量热器簇,测试事件级自编码器与三事件时序模型。
编辑判断是,稳定的数据接口可以让前端电子学、传输层和后端模型分别演进。它仍是后端概念验证,尚未接入独立 FPGA 源,没有完整探测器载荷或最终物理选择验收;批处理 TensorRT 时延也不能替代完整源到推理分布。论文自身的完整原仓库未核定,不能把公开依赖当作该系统已开源交付。
论文首提交:2026-10-01(UTC)。来源 A 级:A-GHOST 原论文、原型数据路径与实验边界。