AI INFRA DAILY 系统 · 工程 · 研究
MoE 弹性与训练调优,找对系统优化的时间尺度
日报 ·
- 弹性推理
- 训练调优
- 科研基准
推理与训练|把扩缩容、调参和 rollout 分别放到正确的时间尺度
FastEEP 研究实例内的专家并行弹性,通过复用 worker 执行结构、虚拟地址和父通信域,重新配置活跃 rank、专家放置及物理页,减少整实例重建。编辑判断是,MoE 容量调整可以围绕可复用状态设计,但必须将资源回收与通信域切换一起协调。
作者在两节点、16 张 H20-3e 上,以节点内 NVLink、节点间 400 Gb/s ConnectX-7 和 vLLM 0.27 测试六种 MoE、EP 2—16,对照重启与 Elastic EP,覆盖固定形状和 ShareGPT 请求。这里不引用缩放倍数,因为扩缩容时间与请求服务时间是不同指标。原型只在启动时预初始化的最大拓扑内伸缩,扩容需要可用显存,过程仍有协调暂停;实际采用还需核对上游版本及代码状态。
论文首提交:2026-10-13(UTC)。来源 A 级:FastEEP 原论文、实现与实验条件。
ATTUNE 将优化单位放在训练 recipe:单个编码 Agent 诊断短跑结果,每次调整一项配置,GPU-hour 预算、配置限制和 loss 检查由外部脚本控制。作者已公开 skill、harness 与检查代码。对训练平台的启示是,把吞吐搜索与训练目标约束共同交付,能让配置试验留下可检查的边界。
主实验在 64—128 张 B200/H100 上使用 Megatron-LM 与 slime,测试四个模型,比较同环境运行的公开 recipe;这不是与针对该环境充分调优的专家配置比较。门禁主要观察 20 步 loss,未检出全部注入故障,不能保证长程收敛和最终质量;框架不修改训练框架代码或编写 kernel,也不覆盖 RL rollout。
论文首提交:2026-10-13(UTC)。来源 A 级:ATTUNE 原论文、评估与局限、作者公开实现。
Prorsa 针对多轮 Agent RL 中持续交错的 prefill 与 decode,根据轨迹采样、sandbox 启动及工具返回预测短期需求,调整两类 worker;切换时保留权重,并通过取消、续接请求转移工作。编辑判断是,rollout 调度需要观察轨迹生命周期,静态 P/D 配比未必能跟上工具调用造成的阶段变化。
实验集群为 16 台、每台 8 GPU,使用 NVLink 和每台八张 400 Gb/s RDMA 网卡,原文没有披露 GPU 型号;FP8 的三种 MoE 模型以 GRPO 覆盖数学、代码和通用 Agent 任务。结果衡量 rollout,单轮数学任务的多数设置反而变慢,不能外推为总训练提速或质量提升。预测也未显式建模解码 KV 增长与完成回收,仍依赖容量余量保护。
论文首提交:2026-10-12(UTC)。来源 A 级:Prorsa 原论文、配置、角色切换与负结果。
平台工程|把自改进的对象和最终产物写进验证接口
AWS 的文档处理参考方案先用 Textract 解析文档,再通过 S3 Vectors 查找相似格式;新格式生成抽取 instructions,经 schema 和 Aurora DSQL 中的业务规则验证,失败则修改指令,通过后持久化。已知格式复用指令,失败时由 Troubleshooter 修正当前数据。
对 FDE 的启示是,业务规则和格式知识可以成为有状态的工程资产,让“自改进”具有明确对象。这里迭代的是抽取指令,不是基础模型参数训练。AgentCore Runtime、Gateway 与 Identity 连接执行、工具和身份,公开代码仍是需配置 schema、规则、权限与支持区域的参考实现;材料没有独立准确率或跨文档泛化基准,不能将规则通过等同于所有语义均正确。
工程介绍日期:2026-10-14。来源 B 级:AWS 原始工程教程;配套 A 级材料:公开编排实现。
Siemens 与 NVIDIA 的 NeMo Gym 案例则以最终 Liberty 文件约束芯片表征 Agent:覆盖、格式、相对参考新增失败和完整性作为硬门,数值容差形成评分,诊断再反馈到 skills 与 MCP 工具描述。编辑判断是,工具调用效率应与最终工程产物一起评估,缺失 cell、PVT 条件或重用旧值都需要被验证器识别。
案例固定 Claude Opus 4.8 与 Claude Code,调整接口和技能,并非已经进行 RL 参数训练;每轮实际使用两个 cells、36 个 PVT corners,而非对全部 229 cells 做完整调优。NeMo Gym 的公开库不等于 Siemens 自定义环境、商业仿真工具和参考数据全部公开;此处省略成功率与 token 节省数字,也不把小规模调优写成整芯片生产验收。
工程介绍日期:2026-10-14。来源 B 级:NVIDIA 与 Siemens 原始工程材料;配套 A 级材料:NeMo Gym 原仓库。
云基础设施|容量可用、数据持久与查询完成是不同约束
近期补充的 Google Compute Engine 更新将带 375 GiB 至 12,000 GiB 本地 Titanium SSD 的 C4N 规格转为 GA。这个更新针对带本地盘的规格,不能写成 C4N 整个系列首次可用。C4N 以 Xeon CPU 和 Titanium 网络、存储卸载面向高 I/O 的数据层与 CPU 工作负载,不能挂载 GPU。
编辑判断是,AI 系统的数据准备、检索或分布式文件服务可以独立选择 I/O 配比,避免只按 GPU 实例规格规划外围资源。部署仍需核对具体机型、区域和配额;Titanium SSD 是未自动复制的临时存储,停止、终止或主机故障可能丢失数据,关键数据需要持久存储及恢复设计。可用规格与容量不是应用吞吐基准,也不证明任意分布式作业会获益。
发布日期:2026-10-12。来源 A 级:C4N 本地盘规格原始 GA 记录、机型与限制、本地盘持久性说明。
BigQuery 的新工程教程解释已 GA 的生成式 AI token 配额:按项目及项目内用户分别限制每日输入与输出,跨区域汇总,输出包含 thinking tokens。执行前额度已耗尽会拒绝查询;执行中耗尽则停止新的模型调用,支持 max_error_ratio 的函数可能返回部分结果或失败,而 AI.GENERATE 的未处理行会留下 quota error 状态。
编辑判断是,预算治理应接入逐行完成状态和重试策略,查询成功不能代替结果完整性检查。token 配额也不是精确的美元支出上限;不同模型价格、计量聚合和非生成式调用需要另行核对。embedding 函数不在这组配额内,AI.COUNT_TOKENS 的文本估算也不包含输出、thinking 与全部包装输入。这里按成本管理工程说明理解,不把教程日期当作功能首次 GA 日期。
工程介绍日期:2026-10-14。来源 B 级:BigQuery 官方工程教程;配套 A 级材料:配额和执行行为文档。
科研计算|通信仿真和速度结论都需要匹配实测条件
Orrery 在应用与 SMPI/SimGrid 之间加入链接时插桩层,捕获 CUDA 内存操作、kernel、数据移动与 MPI 调用,以校准后的成本推进虚拟时钟。Skeleton 模式不执行 GPU kernel 或产生设备计算结果,Twin 模式才实际执行 kernel。
对 HPC 规划的启示是,设备内存路径与 MPI 实现需要进入模型,才能分析 GPU-direct 通信。参考测量来自 MUSICA 最多 32 节点、128 张 H100,每节点四卡 NVLink 4.0,跨节点 200 Gbit/s InfiniBand,运行 CUDA-aware 集合通信微基准与 GPU Jacobi。
当前模型仍有显著的集合通信误差,按顺序建模的操作不能捕获计算与通信重叠;Jacobi 总时长接近实测也不代表通信项准确。超过实测规模的结果属于模拟,kernel 成本不能直接跨架构泛化。
论文首提交:2026-10-13(UTC)。来源 A 级:Orrery 原论文、校准、实测与模型限制。
近期补充的一项拓扑优化研究在同一工作站复跑八个方法,对 OAT 和 HGTO 深入比较:保持经典优化算法,先改进有限元平衡方程的求解实现,再比较达到相同设计质量所需的时间。作者使用 i5-14600KF、RTX 5090 与 CUDA 12.8,以 GPU 预条件共轭梯度及 CPU PARDISO 等对照检查线性二维问题。
编辑判断是,科研 AI 的速度结论需要同时对齐比较实现、质量和计时边界;论文并未发现所有学习方法都失去优势,因此不应推广成对 ML 求解器的普遍否定。OAT 的等质量预算由运行后识别,部分规则和扩展分析属事后加入,不能视为在线停止策略;单样本推理也未包含模型加载、批处理和完整候选选择成本。
论文首提交:2026-10-12(UTC)。来源 A 级:拓扑优化基线审计原论文、方法、计时边界与研究局限。
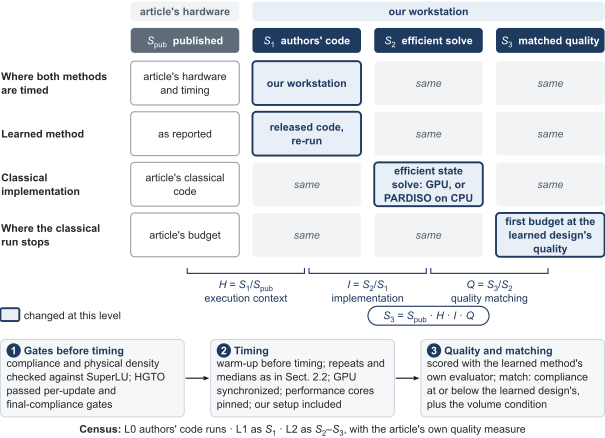
Shaoliang Yang、Jun Wang,论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。