AI INFRA DAILY 系统 · 工程 · 研究
从增量分词到长期工作流,复用需要明确边界
日报 ·
- 前缀复用
- 训练配置
- 持久工作流
推理与训练|复用前缀,也要重新检查质量和配置
Delta Tokenizer 保留会话已有 token,只重编追加文本和可能受影响的尾部,在分词规则允许的稳定边界拼接;没有会话状态可复用的无状态长请求则在安全边界分块,并由共享 CPU 池协调长任务与短更新。对服务入口的启示是,GPU 已复用 KV 的请求仍可能在 CPU 重复处理全文,前后端需要共同利用会话状态。
论文 CPU 主实验使用 EPYC 9115 的单插槽 16 个固定核心,以冻结配置的 Hugging Face tokenizers 0.22.2 为参考;SGLang 0.5.19 实验配 RTX PRO 6000 96GB 或 RTX 5090 32GB,比较 HF、无状态编码、作者重实现的 LoPT 和整请求 worker pool,覆盖英文、代码、多语言及代理轨迹。
首次初始化仍需完整编码,专用核心、会话状态和进程间传输也有成本,不能将分词提速等同于所有请求的端到端加速。论文首版仍写分块、池调度与适配器待发布,随后 TokTier 0.3.0 已提供这些可选接口;分块准入目前仅四个 artifact,其余回退串行,native 路径也不能借用 Python 路径的语料验证结论。论文首提交:2026-10-14(UTC);版本发布日期:2026-10-15。
来源 A 级:Delta Tokenizer 原论文、方法与实验、TokTier 0.3.0 原始发布。
CacheSmith 则处理 RAG 复用片段 KV 时缺失跨片段注意力的问题:WarmUp 完整计算前若干层,Probe 提取选择信号,Patch 重算选定 token,再由批调度和预算规划共同分配质量与首 token 延迟预算。编辑判断是,缓存策略应直接优化“质量门与 TTFT SLO 同时满足”的请求比例,单看命中率不足以决定是否值得复用。
原型基于 vLLM 0.10.2、RTX PRO 6000 96GB、EPYC 9554 和 PCIe 5 NVMe,Llama-3.1-8B-Instruct 使用一张 GPU,Qwen3-32B 使用两张;在 LongBench、RULER 与混合请求上比较 CacheBlend、EPIC、ProphetKV、FusionRAG 及完整复用、完整 prefill。
该目标不是逐请求无损保证;部分基线共用作者实现且未调优的 QCI Triton kernel,绝对延迟不能与其他论文直接横比。KV 由独立 passage 预先生成和存储,论文也未给出可核验的原型代码链接,不能写成任意在线 RAG 均已验证或开源交付。
论文首提交:2026-10-13(UTC)。来源 A 级:CacheSmith 原论文、调度、画像与实验边界。
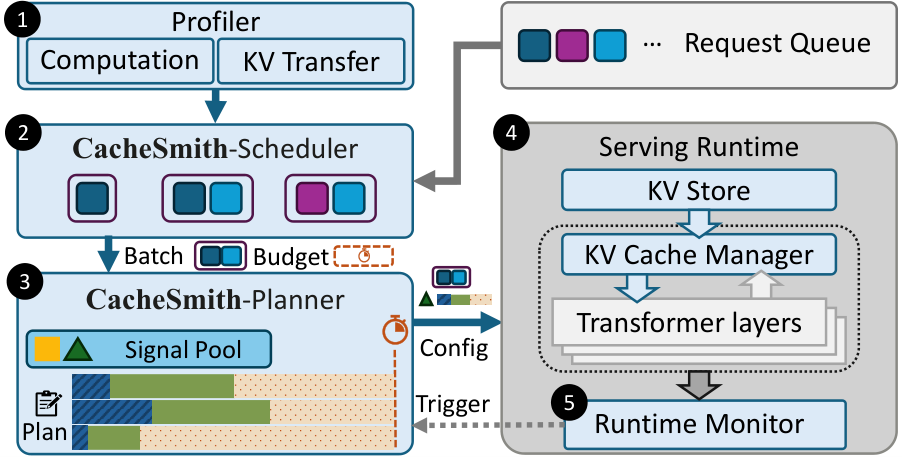
Xinyue Ma 等,论文图 6 · CC BY 4.0,原图未修改。点击图片查看大图。
Primus Projection 将训练配置搜索前移到单 GPU 或子节点的代表性层实测,再解析恢复目标规模的通信、FSDP 重叠和流水线调度;种子规划器搜索单轴,LLM 提议跨轴组合,内存预过滤先排除不可行配置。对训练平台的启示是,把有限设备时间用于校准代价模型,再将少量候选送回集群验证,可以缩小昂贵试跑的范围。
论文在 AMD Instinct / ROCm 栈上验证,Llama 3.1 以 MI325X 的八节点、64 GPU 为目标,Mixtral 8×22B 以 MI355X、BF16 的四节点、32 GPU 为目标,并与同规模 AMD 参考配方比较。这里不引用吞吐增幅:投影未建模网络争用,假定节点同质,FP8 配方仍需另验收敛,NVIDIA 和 TPU 也未获同等实证。新信号是此次论文及系统评估,投影器与调参代理此前已有代码。
论文首提交:2026-10-14(UTC)。来源 A 级:Primus Projection 原论文、方法、评估与局限、Primus 官方仓库。
平台工程|让持久执行、操作技能与测试验收各有接口
Google 与 Temporal 的工程材料介绍 Preview 状态的 Serverless Workers:Temporal Cloud 按任务队列需求,通过获授权的 Cloud Run Admin API 调节 worker pool;worker 在用户项目和服务账户下主动轮询,无公共入口,可缩到零。
每个 Worker Deployment Version 对应独立池,并要求 Worker Versioning。编辑判断是,多步骤、会等待外部输入的 Agent 工作流,可以把持久编排与按需执行容量分别管理;版本策略仍需设计,PINNED 与 AUTO_UPGRADE 的迁移行为不同。新实例仍需要启动并连接,材料不能支持“瞬时无冷启动”;活动重试也不保证外部副作用恰好执行一次。
工程介绍日期:2026-10-15。来源 B 级:Temporal 与 Cloud Run worker pools 官方工程材料。
MWAA 新发布的 AI agent skills 将工作流编写部署、故障诊断、触发测试与复测、环境升级整理为操作技能,放入 Agent Toolkit for AWS 的 aws-data-analytics 插件,由编码助手调用实际 AWS CLI 操作。对 FDE 的启示是,交付给助手的知识应包含从修改到验证的完整操作路径,并明确目标环境。
技能包本身不是另一项独立托管 Agent 服务,也不证明自然语言运维已经可靠。官方文档区分 Provisioned 的 Python DAG 与 Serverless 的 YAML,升级技能仅支持 Provisioned;实际操作仍取决于资源范围内的 IAM 权限。
发布日期:2026-10-15。来源 A 级:MWAA 原始发布公告、技能与环境支持文档。
Resilience Hub 与 DevOps Agent 的新集成进一步把调查接到韧性验证:测试启动时可自动发起调查,返回症状、根因、影响及观察到的恢复动作;故障模式评估 finding 也能携带上下文启动交互调查,辅助形成缓解计划。编辑判断是,平台可以将测试证据送入诊断闭环,同时保留清晰的验收权威。官方明确 Agent verdict 仅供建议,测试本身的结果仍是权威结果,API 也将调查的 verdict、confidence 与 summary 单列;使用前需要连接并配置 Agent。调查解释不能替代测试通过,更不能据此推断生产环境已自动修复。
发布日期:2026-10-15。来源 A 级:Resilience Hub 新集成公告、调查结果与权威边界。
云与机架|可观测的时间基准,以及尚待交付的容量形态
Amazon Time Sync 将微秒级准确时间扩展到全部商业区域中的另外 135 种 EC2 实例、覆盖 12 个家族。新增支持通过 Precision Time Placement Group 启用 PTP 硬件时钟,需要低网络延迟时可与 Cluster Placement Group 关联。
对分布式 AI 平台的启示是,跨机器事件排序和单向网络延迟测量有了更广的时间基准选择,但应用仍须配置并使用相应时钟与时间戳。公告的微秒级时间准确度与纳秒级硬件时间戳精度是不同指标;硬件包时间戳还要求 Linux 及受支持的 PHC 配置。这项覆盖扩展不能直接证明训练吞吐或任务恢复速度提升。
发布日期:2026-10-15。来源 A 级:Time Sync 扩展原始公告、硬件包时间戳前提。
近期补充的 AMD Helion 发布介绍了基于 OCP 规格设计的 Agent 机架蓝图:CPU 主导的配置承接代理执行并连接独立模型推理设施,也可把 EPYC CPU、Instinct MI350P GPU 和通用计算组合为企业一体式配置。编辑判断是,代码执行、工具调用与模型推理具有不同资源需求,机架规划需要分别核算 CPU、GPU、功耗和支撑服务。当前证据是参考架构与合作伙伴开发计划;AMD 计划向 OCP 贡献规格,相关机架配置计划于 2026 年 11 月可用,不能写成已经交付或已获 OCP 接纳,也不能将配置上限当作应用基准。
发布日期:2026-10-12。来源 A 级:AMD Helion 原始发布。
科研计算|将高阶求导与稀疏输出纳入完整数据流
TrimSO(2) 将 SO(2) 原子势中的旋转、重组和逆旋转融入特征收集、激活与聚合,避免额外物化大型边张量,并支持能量、力及应力训练所需的反向和二阶反向计算。对科研训练的启示是,几何表示与高阶求导会延长中间量的存活时间,优化需要覆盖整个训练数据流。
作者在 OMat24 上测试 eSEN-30M-OMat、UMA-S-1.2 与 EquiformerV3,对照各自官方 PyTorch 实现;硬件为单张 A100 80GB 或 H100 80GB,使用 FP32,禁用 TF32 与混合精度。长程比较只覆盖 eSEN 的 40,000 步,每实现每 GPU 一次,数值接近不能写成逐位一致或普遍收敛保证。研究缺少采用 NequIP 式 tracing 的编译训练基线,不能声称胜过全部编译实现;代码在论文中仍标为计划发布。
论文首提交:2026-10-14(UTC)。来源 A 级:TrimSO(2) 原论文、完整训练与基线条件。
Birdseed 关注张量编译器中并行稀疏 scatter 的输出构造:线程先写私有分片,再按非零分布划分坐标范围、合并重复项,最后生成标准稀疏输出,支持 list、bytemap、hash 和 dense 等层级。编辑判断是,稀疏算子的并行收益不仅取决于输入非零量,还受输出分配、去重与格式交接约束。
实验使用 Xeon 6972P 的单插槽 16 核分区,覆盖 SuiteSparse 矩阵、网页截图与合成负载,比较 MKL、Eigen、GraphBLAS、WingSpan、NACHO 和 Halide,取 warm-cache 多次试验的最小值。SpGEMM 数据专门构造为 Gustavson 算法不利的分布,SpAdd 上 NACHO 仍更快,因此不能概括为全面胜过专用库,也不能外推到 GPU、冷缓存或完整应用;本文未提供可明确核验的 Birdseed 原始发布仓库。
论文首提交:2026-10-13(UTC)。来源 A 级:Parallel Sparse Outputs 原论文、Birdseed 方法与评估。