AI INFRA DAILY 系统 · 工程 · 研究
轨迹复用与远端 KV,先算整条路径的净收益
日报 ·
- 轨迹复用
- KV Cache
- 增量计算
训练与推理|减少等待和重算,同时核算新增状态的成本
ReFlow 将近期轨迹 replay 与 rollout、trainer 调度共同设计:双重 replay 数据流控制新旧样本组成及陈旧程度,弹性 worker 池和调度器再按生成、消费速度调整 GPU 分配。它提示 RL 平台可以同时优化样本使用方式与执行资源,而不能只靠提高异步程度。
论文原型建立在 VeRL/Ray、vLLM rollout 和 FSDP 训练上;实验集群为 16 节点、128 张 H800,节点内 NVLink、节点间 8×400 Gbps,使用 Qwen3-4B/8B/14B/32B,覆盖 DAPO-Math-17K、APPS 多轮代码与工具交互,对照同步 VeRL、one-step-off 和 VeRL-async。
这里的吞吐按 trainer 消费 token 与 step time 计算,包含复用样本,不能解释为新增轨迹生成速度;常规吞吐仅测 warm-up 后五步,代码任务测十步,训练 reward 接近也不足以保证全部任务的 held-out 质量。论文未给可核验的实现仓库链接。
论文首提交:2026-10-15(UTC)。来源 A 级:ReFlow 原论文、数据流、调度与实验。
Batch Cost Lookahead(BCL)把同步等待的一部分前移到数据加载侧:在每个 rank 的有限前瞻窗口内,重新组合固定文档数的训练 pack,缓解等记录数、不同序列成本造成的负载偏差,无需跨 rank 交换成本信息或修改 collective。其系统含义是,数据顺序和组包策略也属于分布式训练调度。
公开 SFT 实验使用 Llama-3.2-1B、NeMo-RL 0.7.0、单节点八张 H200、BF16/FSDP2/FlashAttention 3,覆盖 13 个语料并采用相同 p99 截断,对照相同输入路径的无前瞻 packing;另有内部序列负载在一、二、四节点 H200 上做弱扩展。
与 pooled MFFD 的比较包含输入路径变化,不能归因于纯调度;长度分布模拟也不能当作 GPU 实测。单条记录仍须装入显存,持续的 rank 总成本偏差仍需协调,NeMo 实验未测重排序后的 held-out 质量或精确重启,论文也未给直接实现仓库。
论文首提交:2026-10-15(UTC)。来源 A 级:BCL 原论文、输入路径、负载与限制。
一项 Remote KV 研究则说明,远端命中仍需跑赢 GPU 重算。作者在 GLM-5.3 FP8/MLA 的 prefill-decode 分离部署中,让每个 prefill 节点使用八张 B300、PCP8,以 LMCache 的 host RAM 为 L1、Valkey 为 L2;通过隔离回放生产流量,比较冷重算、L1、单实例同步 L2,以及按 PCP rank 分片、每 rank 远端实例、异步加载和客户端修复。
固定引擎开销与传输成本决定命中临界点,将集中在 rank 0 的 I/O 分散出去才可能释放远端层的收益。对服务平台的启示是,命中率必须和传输路径、并行布局一起观察;组合修复的收益也不能全部归给缓存。结论限于该模型、带宽与命中负载。核心代码于 10 月 8 日公开提交上游,本次新信号是论文及评估,三个相关 PR 当前均为 Open,尚不能视为已合并的正式版本能力。
论文首提交:2026-10-15(UTC)。来源 A 级:Remote KV 原论文、诊断与比较条件、分片 PR、每 rank URL PR、异步加载 PR。
平台交付|让修改、执行和业务验收留下不同证据
AWS Transform 将 Azure 到 AWS 的云原生代码转换作为 .NET modernization agent 的正式能力提供:先识别源码中的 Azure SDK,在评估报告和现代化计划中列出转换选项,用户可以调整或退出,再转换支持的调用。Azure Functions→Lambda、Blob Storage→S3、Queue Storage→SQS 已支持,Cosmos DB→DynamoDB 单独仍为 Preview。
对 FDE 的启示是,跨云交付可以将依赖识别、转换范围与残留工作放进可审阅计划。当前范围仅包括应用代码,云基础设施和数据迁移仍需另行实施;无法转换的部分可能留下 TODO、stub 或 Next Steps。确认修改进入转换后的代码,不能代替业务语义、目标环境部署与数据完整性验收。
发布日期:2026-10-16。来源 A 级:AWS Transform 原始 GA 公告、转换范围与残留处理。
Google Cloud 的新评估工程复盘把类似问题落到 Agent 工具轨迹:只看最终答复会漏掉已经执行的正确步骤,将遥测摊平成顺序事件又会掩盖同一 turn 的并发派发。案例中,技能加载与文档搜索同时发出,完整技能指令在后续 turn 才注入,搜索已先执行。
文章据此建议按实际工具轨迹评分,保留 turn 与并发结构,分别运行带沙箱凭据的 live 条件和移除凭据的 plan-only 条件,并用人工整理的 golden sets 回归整个 harness、模型与工具栈。其工程含义是,评估需要同时观察规划与执行:前者可暴露被权限错误遮蔽的问题,后者才能检验真实权限与副作用约束。这是已发布 Developer plugin 的新工程复盘,文章没有交付新的公开可复现基准,团队案例也不能外推为跨模型、跨 harness 的普遍结论。
工程介绍日期:2026-10-16。来源 B 级:Google Cloud 原始评估工程材料。
GPU 工程|运行时提供路径,kernel 仍需按实际目标调优
近期补充的 ROCm 10.1.0 更新将存储、主机内存放置与可观测性接在一起:hipFile 提供异步 fast path、批量 I/O 和统计能力,HIP 的 host-NUMA VMM 可以在指定 NUMA 节点分配 pinned host memory,编译器迁移到 LLVM 24。
对训练 checkpoint、KV 卸载与集合通信的启示是,优化可以从“算得更快”扩展到“数据从哪里来、经过哪些缓冲、如何定位瓶颈”。HIP 的完整 host-NUMA VMM 生命周期要求 Linux 及具备 NUMA、VMM 能力的 GPU;hipFile 无法使用直接路径时会回退 POSIX I/O,应通过兼容性检查和遥测确认实际后端。WSL2 在此版本仍为 Technical preview,升级还需核对驱动、框架及编译器依赖,不能将版本功能直接折算为应用吞吐承诺。
发布日期:2026-10-05。来源 A 级:ROCm 10.1 原始版本介绍、正式版本记录与支持条件、hipFile fast path 兼容性检查。
AMD 新公开的 RDNA FP16 GEMM 工程材料展示了另一层边界:从 WMMA 出发,逐步调整 LDS padding、全局读取、K 深度、块顺序、预取及单双缓冲,部分改动在不同架构上方向相反。它提示 kernel 策略需要把寄存器、LDS 与驻留率放在同一张成本表中。
测试使用 Radeon PRO W7800、8060S 与 RX 9070 XT,ROCm 10.0、CU mode,以 hipBLASLt 的 heuristic 结果作基线;两组矩阵为 8192³,以及 M=8192、N=28672、K=8192,预热十次后取三十次平均。
双方均为 FP16 输出及 FP16 累加,A 行主序、B 列主序,测试直接生成目标布局,未计入真实输入可能需要的转置成本。±1 输入的精确比较不能证明一般 FP16 数值误差,两个大矩阵上的结果也不能外推到 skinny GEMM、小矩阵或完整模型;正文多处代码为结构性伪代码。
工程介绍日期:2026-10-16。来源 B 级:AMD RDNA FP16 GEMM 原始工程与基准条件。
科研计算|统一地址与增量更新都需要明确复用成本
Grace–Blackwell 的 placement-controlled 微基准分别测量本地 HBM、host-mapped 内存、managed 首触、预取、再次使用、超额订阅和 CPU–GPU 交接,再按驻留与复用次数建立成本模型。
对科研负载的启示是,统一地址接口下仍需要区分实际位置、访问历史和容量压力,单一“统一内存带宽”无法指导所有选择。研究以 GB200 为主、GH200 为前代对照,CUDA 执行限于一个完整双 die B200 GPU,覆盖流式、跨步、随机、稀疏页状访问与容量扫描;GB10/DGX Spark 只用于流程验证。
预取时间与预取后 kernel 时间分别报告,后者不能当作完整移动成本;缺页或迁移计数不可得时,部分机制由时序趋势推断。结论不覆盖多 GPU、NVL72 机架或完整应用,GB10 的共享 LPDDR5X 也不能替代 GB200 的放置对照;基准和脚本计划在双盲审稿后公开。
论文首提交:2026-10-14(UTC)。来源 A 级:Grace–Blackwell 原论文、放置控制、计时与边界。
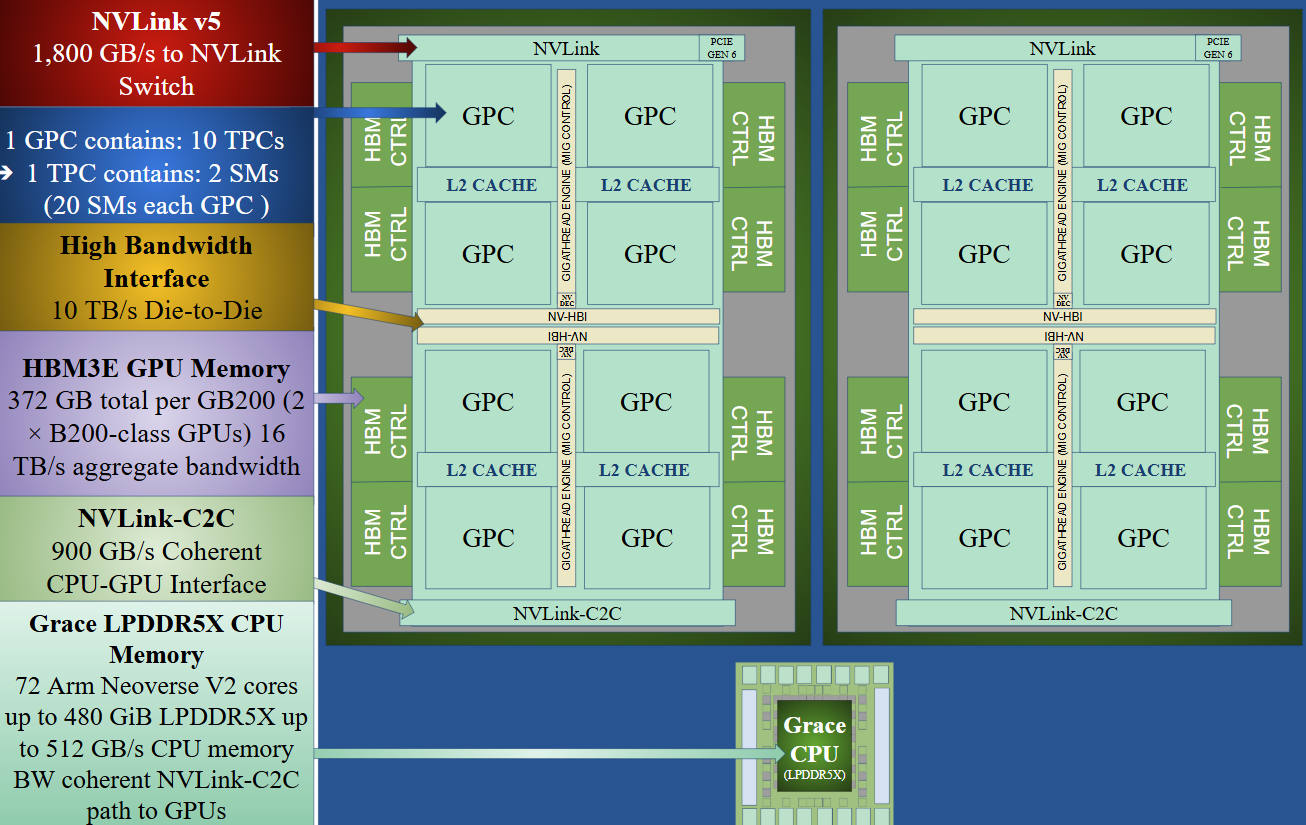
Nathan Graddon 等,论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。
How the Dirty Set Moves 则将增量稀疏乘法的收益拆开:固定算子 A,只更新变化输入行对应的乘积;长期可复用的 tile 准备,与依赖具体 tile 集合再次出现的 session 调度,具有不同的有效期。研究比较直接 CSC、重建 CSR 和保留准备、调度的 P3,并分别计入设置、维护与输出交付。
编辑判断是,减少重算和复用预制调度需要分别验收,session 缓存扩容并非总能提高净收益。主测在 AWS c7i.2xlarge、Xeon Platinum 8488C 上固定单核、单库线程,另有 EPYC、一至八核及最多两主机扩展;负载包含 21 个 SuiteSparse 矩阵、局部漂移和随机跳变更新、MovieLens 与空气质量回放,并对照 SciPy 检查输出。
P3 的稳定优势集中于特定矩阵家族,准备、维护及排名成本可能抵消 kernel 收益;主要结论来自一个 CPU 执行器,不能直接推广到 GPU,大规模分布式收益也仍需验证。