AI INFRA DAILY 系统 · 工程 · 研究
异构训练与端云推理,明确设备间的协作契约
日报 ·
- 异构训练
- 端云推理
- 科研编译
训练与推理|让异构设备真正协作
Meta AMD|迁移要覆盖整个训练栈
Meta 的新论文将 AMD GPU 上的训练迁移描述为端到端协同设计:GEMM 选择、RCCL、Triton/Inductor kernel,与按 HBM 容量调整的 batch、activation checkpointing 和 embedding 放置共同影响结果。其系统含义是,设备适配应覆盖模型配方和执行栈,单独替换算子不足以代表完整迁移。

Haoyu Zhang 等(Meta / AMD),论文图 2 · CC BY 4.0,原图未修改。点击图片查看大图。
主评估是十个生产 DLRM,规模八至 128 GPU,在相同 GPU 数、相同 batch 下比较 MI350X 与 B200;Meta 配置的功率限制分别为 1000W、750W,HBM 分别为 288GB、180GB。
这里省略总体倍数:这是不同功率与容量条件下的推荐模型比较,各模型表现有高有低,不能推成等功耗优胜或通用 LLM 训练结论,kernel latency 分类也未计多流 overlap。作者称相关贡献已进入 PyTorch、Triton 和 ROCm 上游,但未提供整套生产模型与复现包的统一发布入口。
论文首提交:2026-10-15(UTC)。来源 A 级:Meta AMD 训练协同设计原论文、模型、硬件与执行栈评估。
ETH|按设备能力分配数据与通信
ETH 将异构流水线的 local batch、stage 划分、设备放置、TP/DP 与重计算联合搜索,并用 block-wise All-Reduce 缓解不对称梯度通信,配置缓存、剪枝和动态规划则控制搜索开销。对集群调度的启示是,数据分配与通信模式需要随设备差异共同改变。
实验包含 Ascend 910B2/B3/B4,以及 A100/RTX 3090 集群,覆盖 GPT-3 350M–175B 和 LLaMA-2 70B,主设置为 sequence length 2048、global batch 1024,对照 HexiScale、Metis。
当前搜索限于 PP/TP/DP,代价模型假定 1F1B,启发式 stage 调整不保证全局最优;收敛证据限于 LLaMA-2 70B、Enwiki、2000 iterations。作者原仓提供 profiling、search、runtime 与示例代码,但公开环境是 Ubuntu 22.04、Python 3.10、CUDA 12.4 和 PyTorch 2.6,不能据此推断 Ascend 已获开箱即用支持。
论文首提交:2026-10-15(UTC)。来源 A 级:ETH 原论文、搜索与收敛评估、作者实现。
HyCo|手机生成草稿,云端负责验证
HyCo 把部分推测解码移到手机:原生 MTP head 提供 draft 深度,小模型单次执行补充替代分支,云端 verifier 回传所需状态,手机 NPU 生成混合 draft tree;量化、受限输出词表与 1K context 控制设备成本。它提示端云协作除了网络往返,还要将输出分布的要求写入接口。
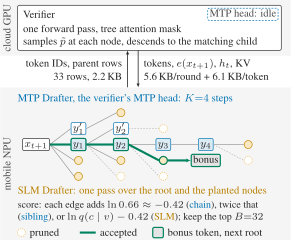
Hanbin Bae 等(Samsung Research),论文图 2 · CC BY 4.0,原图未修改。点击图片查看大图。
实测使用 Galaxy S26 Ultra/SM8850/Hexagon v81、商业 LTE/5G,云端一张 RTX PRO 6000 96GB,以 Gemma 4 26B-A4B AWQ 为 verifier、Gemma 4 E2B 为 drafter,覆盖 Spec-Bench 与 32K 英文长摘要,对照 Cloud+MTP、SpecEdge-style、相同接受规则和 exact 变体。
默认 ε=0.005 是有损接受,不保持 verifier sampling distribution,不能与 exact 变体混称无损。测试只有单客户端及一种手机、网络、云 GPU 和 verifier 家族,未测满载容量、金钱成本或设备与无线电能耗;还需访问原生 head、hidden states 和 KV,不能直接套用闭源模型 API。论文未给明确可核验的实现仓库。
论文首提交:2026-10-15(UTC)。来源 A 级:HyCo 原论文、端云实现与接受规则。
平台工程|验收真实执行路径
AgentCore|把回归测试与线上漂移分开
AWS 的 AgentCore 九阶段评估工程案例,在工具、单 Agent 和多 Agent 三层分别建立契约:暂存环境部署触发小型 sentinel,发布前使用完整 golden set;先独立验证工具,再冻结正确响应作为回放数据,隔离工具变化与 Agent 推理。
生产阶段另用 canary、线上抽样和低分轨迹回流观察未伴随代码发布的数据漂移。对 FDE 的启示是,变更回归与生产质量漂移应由不同证据支撑。
冻结回放不检验真实工具的速度、可用性或生产副作用;OTel 轨迹与质量分数来自不同管道,存在轨迹也不等于评估通过。材料是团队自述的生产案例,多张图为示意数据,不能据此计算改善比例,也不能把评估建议写成已经自动修复任意环境;正文没有可核验的框架源码仓库。
工程介绍日期:2026-10-16。来源 B 级:AWS AgentCore 原始评估工程材料。
Security Agent|沿指定漏洞路径验收结果
AWS Security Agent 的新评估披露则把“完成”约束到具体漏洞路径:在隔离容器内运行真实受影响软件或最小复现,禁用运行时 CVE 检索,取得 flag 后再由人工和工具检查是否经过指定漏洞到达 intended sink,旁路结果不计通过。其工程含义是,最终产物与实际执行路径需要共同验收。
这是持续刷新内部基准的一次评估披露,单题上限十小时,没有同条件外部基线,近期漏洞与禁检索也只能减少污染。
材料明确,基准未启用生产交付中的非破坏性约束,另有两题因攻击过程使目标停机而失败;因此不能把测试结果外推为可安全自主操作生产系统,也不能把厂商对生产护栏的主张视作独立验证。
工程介绍日期:2026-10-15。来源 B 级:AWS 原始 CVE 评估与轨迹审计说明。
开发与部署|交付完整运行条件
RTX Spark|本地开发先看容量与兼容性
NVIDIA 的 RTX Spark 发布材料将 Grace CPU、Blackwell GPU 和最多 128GB 统一内存用于本地编码 Agent、定制与开发,Windows on Arm 与 WSL 提供不同执行入口。对开发基础设施的启示是,本地算力可以承担更完整的模型与工具循环,但仍需按目标环境验证依赖。
官方称笔记本已可用,小型台式计划于 11 月提供;应用迁移仍须检查 Arm64 原生依赖或 Arm64EC 路径,并测试安装、功能及 CUDA 调用。
此处不引用厂商速度倍数:其比较是 RTX Spark N1X 对 Core Ultra X9 388H,负载分别为 Qwen3.8-27B 的 AA-AgentPerf-local、Llama-3.1-8B 的 Unsloth LoRA 与 Linux kernel 编译,不能代表任意项目、模型或云端部署。统一内存容量也不能直接等同于任意上下文、并发与精度组合下的可用模型容量。
发布日期:2026-10-16。来源 A 级:RTX Spark 原始发布与测试范围、官方产品规格。
Beam|模型、路由和缓存一起交付
Google Cloud 的 Beam 工程方案则把云端多轮服务作为整体配置:前缀与负载感知路由结合 prefill/decode 分离、推测解码,以及 GPU、主机 DRAM 和本地 SSD 的分层 KV。
原仓已提供 Beam 专用配置,其中 G4 的 vLLM 示例显式设置 OffloadingConnector、CPUOffloadingSpec 与 draft 配置。其系统含义是,模型 checkpoint、缓存格式、路由和资源配比应共同版本化,配置存在仍需在目标集群验收。
材料使用 AgentX 多轮轨迹,对 Dynamo/A4X Max 的 32 张 GB300 与 llm-d/G4 的八张 RTX PRO 6000 分别测量,每组只对比同硬件的无状态 round-robin 基线;两组图不能拿来比较硬件或推理引擎优劣,客户测试也不是跨负载保证。本段不复述标题中的倍数。
工程介绍日期:2026-10-17。来源 B 级:Google Cloud 原始 Beam 部署工程材料;配套 A 级材料:Beam prefill 配置、G4 的 KV 卸载与推测配置。
科研计算|让通信和数据流可编程
Cyclotron|在程序里改变通信路线
近期补充的 Cyclotron 新稿,将通信路径写进递推方程,并与空间、时间映射分开,让同一计算调整广播、环、树或混合通信,编译器再生成匹配的发送、接收和计算顺序。该研究在 2025 年已有前身,本次进展是更明确的通信语言、依赖处理和多 GPU 实测。对科研编译的启示是,通信不应只由算子库外部猜测,程序可以显式保留可变的通信路线。
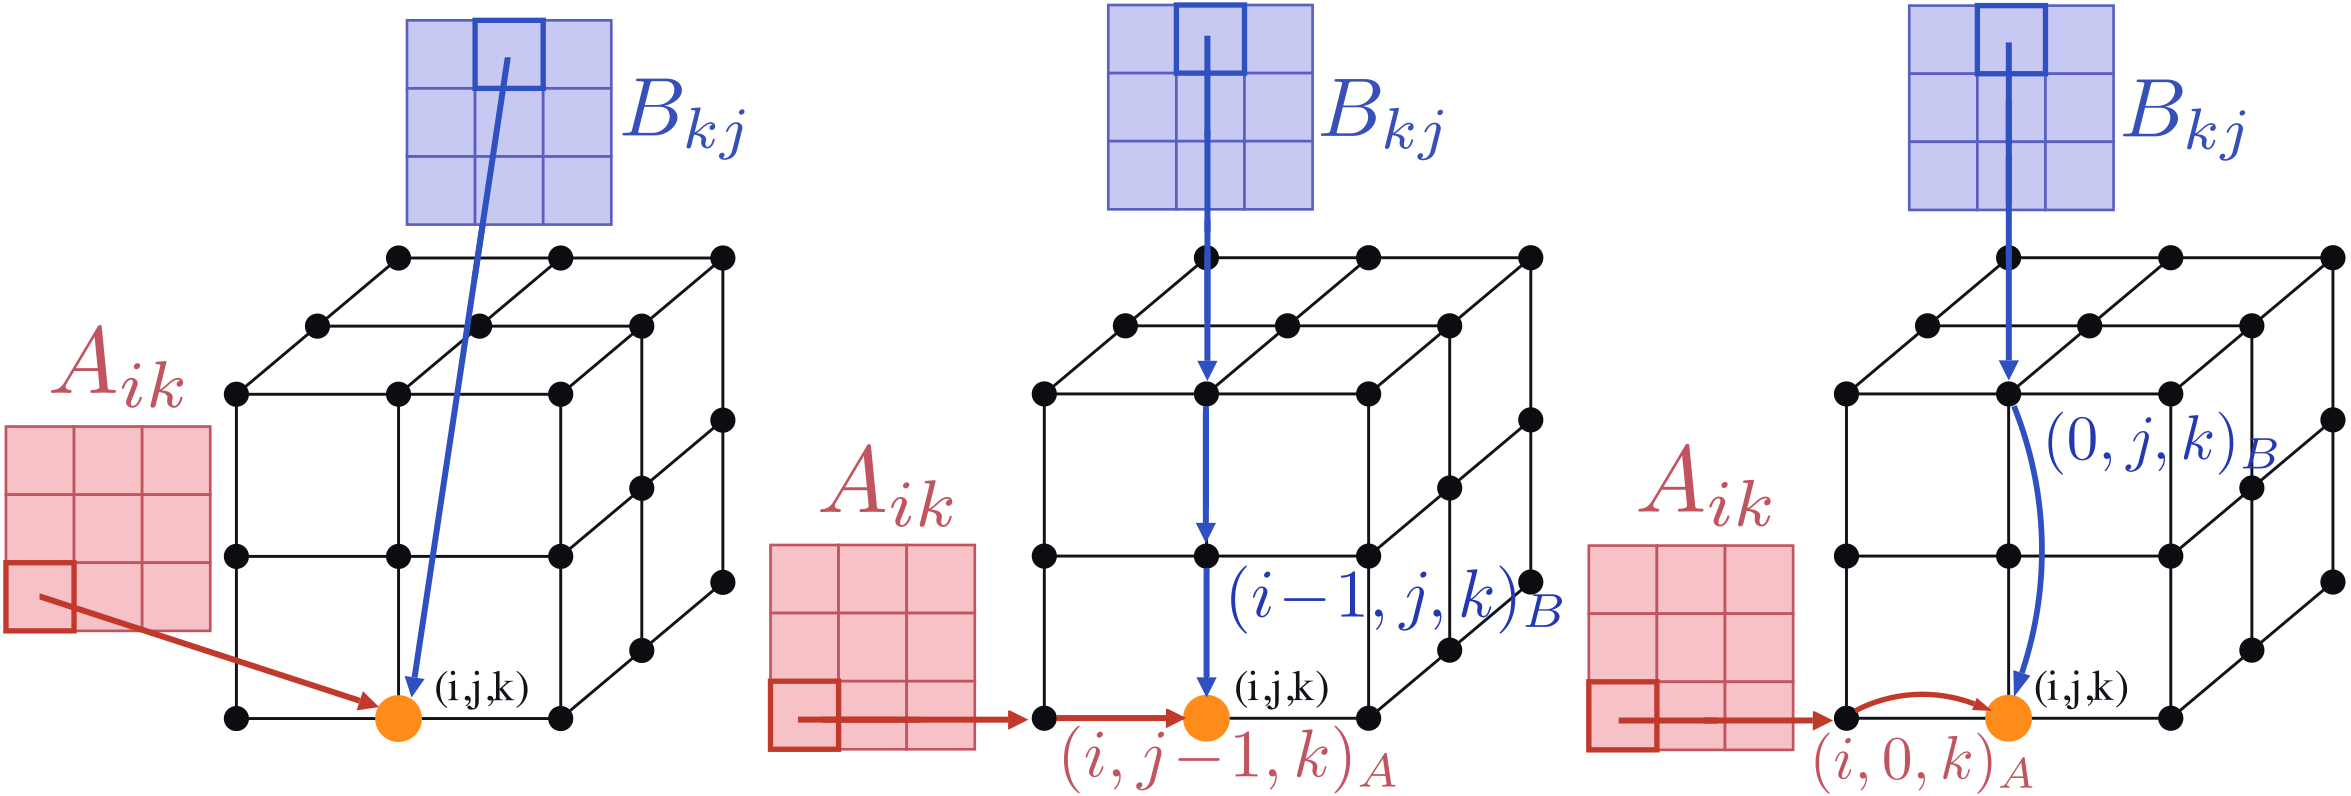
Shiv Sundram 等(Stanford),论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。
实验在 Perlmutter 最多 16 个 CPU 节点及 16 张 A100 上,覆盖矩阵乘、TRSM、Cholesky 与融合,对照 ScaLAPACK、SLATE、cuSolverMp,报告预热后四轮的最佳时间。
SLATE 比较采用 host staging,cuSolverMp 采用 GPU direct,不能合并为同一倍率结论;策略随机器、分块和规模变化,也未证明自动找到任意机器的最优路线。当前按论文原型理解,不声称已交付可直接部署的公开编译器。
新稿首提交:2026-10-14(UTC)。来源 A 级:Cyclotron 新稿、通信语言与新评估、2025 年前身研究。
Helix|一套 FPGA 架构运行多种求解器
Helix 将 Krylov 求解器共享的向量运算、稀疏矩阵向量乘、标量运算及控制抽成可编程单元,DSL 编译器负责阶段调度、融合和 HBM 向量放置,在同一 FPGA 架构运行八种求解器,无需切换位流。其系统含义是,可编程加速可以围绕算法家族共享的数据流组织,而不必为每个求解器更换硬件设计。
研究使用 Xilinx Alveo U55C 实机,在 SuiteSparse 的 29 个 SPD 矩阵上统一采用 Jacobi 预条件,对照同板 XcgSolver、Callipepla 及 CUDA 12.8/cuSPARSE/cuBLAS 的 RTX PRO 6000 实现。
Helix 的矩阵为 FP32、向量与算术为 FP64,GPU 矩阵为 FP64,因此这里不引用加速比;未收敛样例只比较每迭代 kernel 时间,不能当成完整求解成功的耗时。统一 SPD 数据集也未覆盖全部非对称、不定矩阵,低切换成本仍依赖负载数据复用、指令常驻或传输重叠;论文原型不等于已验收的生产科学工作流。
论文首提交:2026-10-15(UTC)。来源 A 级:Helix 原论文与提交记录、完整实现与实验说明。