AI INFRA DAILY 系统 · 工程 · 研究
KV 迁移、科研算子与可追溯 Agent
日报 ·
- 推理调度
- 科研算子
- 可追溯 Agent
推理与训练|按真实依赖安排执行
EdgeFlow|在传 KV 与传激活之间分工
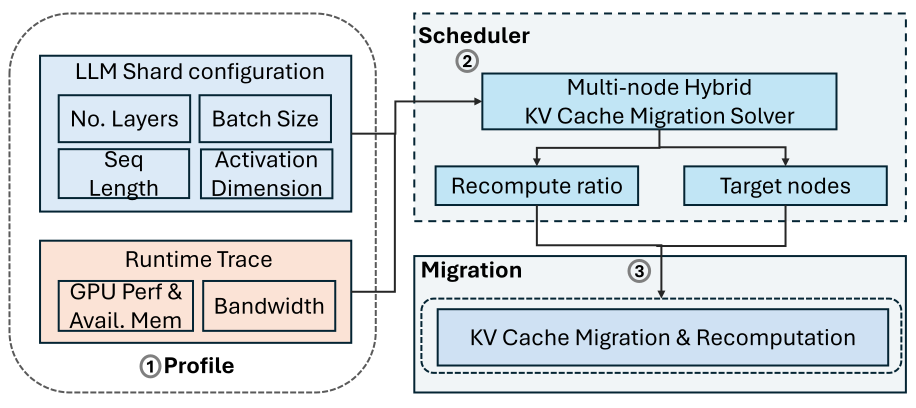
近期补充:10 月 15 日提交的 EdgeFlow 面向异构边缘节点,在直接传输 KV cache 与传输激活、由目标节点重算 KV 之间选择混合方案。调度器收集算力、可用显存和带宽,联合决定迁移目标与各层采用的路径,并重叠通信和计算。它把过载或计划退出时的状态迁移变成可优化的执行计划。
Mingjin Zhang 等,EdgeFlow 论文图 3 · CC0 1.0,原图未修改。点击图片查看大图。
实测使用 RTX 2080Ti、3060、3090、4090 等异构卡,运行 FP16 的 Qwen2.5-32B 与 Llama3.1-70B,以 WikiText-2 为输入;初始分别为 6、10 个节点,平均链路带宽 500Mbps,并加入 30% 波动。对照直接传 KV、全部激活重算和贪心目标选择,主要指标是迁移耗时。
这些结果不能直接代表端到端服务 SLO,更大规模部分仍依赖模拟。KV 与激活的大小关系取决于模型布局,不能把特定配置的传输比例推广到所有注意力结构;基础平台可用也不等于 EdgeFlow 的完整实现已经公开。
来源:2026-10-15,A 级|论文与提交记录 · 机制、图 3 与实验条件。
TP 与 PP|把首字延迟和逐字延迟分开
近期补充:10 月 14 日的《Scaling LLM Inference via Parallelism》把 TTFT 与 ITL 分别建模,再按工作负载和 SLO 寻找可行配置与 Pareto 前沿。研究采用 Qwen2.5-14B-Instruct BF16、8 张 H200 141GB 和 vLLM 0.15.0,对比 TP8、TP4PP2、TP2PP4 与 PP8。
前沿实验固定并发 128、输入输出合计 1200 token、显存利用率 0.8,并开启 chunked prefill;SLO 实验另用输入 1200、输出 2800 token 与并发 256。论文 goodput 以吞吐乘 TTFT 达标比例计算,并未同时约束 ITL 或端到端尾延迟。选择并行度时仍要回到实际请求分布,不能据此断言 PP 总比 TP 适合长上下文。
来源:2026-10-14,A 级|论文与提交记录 · 测量方法和 SLO 定义。
StageBreaker|提前执行不依赖奖励的反向部分
近期补充:10 月 12 日的 StageBreaker 针对视频强化学习,将不依赖奖励的反向计算提前执行,合并重复的轨迹重放,并把 VAE 解码及部分训练任务安排到 reward GPU。实现建立在 verl-omni 上,试图消除按阶段整齐排队造成的空闲。
默认实验为 6 张 RTX PRO 5000 Blackwell 72GB,经 PCIe 5.0×16 连接;DanceGRPO/Wan2.1-1.3B 与 KVPO/LongLive-1.3B 均采用 LoRA,对照全卡顺序执行及 2 卡 reward、4 卡 actor 的异步方案。精确算术下的算法等价不代表 GPU 逐位一致;500 步保真检查用的是 Stable Diffusion 1.4 与 HPS-v2.1,不能代替所有自回归视频模型的长期收敛验证。
来源:2026-10-12,A 级|论文与提交记录 · 调度、硬件与保真检查。
平台工程|让 Agent 的输入输出可核对
Gemini Enterprise|自定义 MCP 工具返回可点击出处
Google 在 10 月 16 日将自定义 MCP 数据源的 citation mappings 推为 GA。管理员可按工具配置 JSON Pointer,从结构化响应提取条目与 URI、标题、摘要、ID,让回答附上指向原始对象的引用。这给企业工具提供了明确的来源接口,便于从回答回查执行结果。
当前配置使用 v1 REST API,控制台尚不支持;普通文本或未结构化 Markdown 不能直接套用 JSON Pointer。更新会替换整份映射,且只作用于新会话;没有关联工具调用便不会生成相应引用。引用可点击只能说明链路可追溯,内容真实性和回答是否得到完整支持仍需另行核验。
来源:2026-10-16,A 级|正式发布记录;B 级|映射结构、更新范围与限制。
Cloudflare CLI|把在线文档搜索接入终端
Cloudflare 在 10 月 16 日介绍 cf docs search:无需登录即可查询公开文档,最多返回五个带标题、描述和 URL 的排序结果,再获取页面 Markdown 阅读全文。对平台 Agent 而言,这提供了从问题到当前官方文档的工具链;搜索结果仍应继续打开原文核实。
CLI 的变更记录将搜索功能记在 beta.15,发布介绍采用的 beta.16 已包含该能力,不能把介绍日期写成首次加入版本。beta.16 还将 42 个命令名改为 kebab-case,固定脚本需要核对版本;文档搜索与本地命令搜索也应区分。查询会发送给在线服务,适合使用通用问题,避免夹带账号、域名或 token 等私有上下文。
来源:2026-10-16,A 级|官方发布介绍 · 原仓版本记录;B 级|Agent 使用文档。
科研计算|重排算子,也保留不确定性
LunaTP|围绕目标节点聚合张量积消息
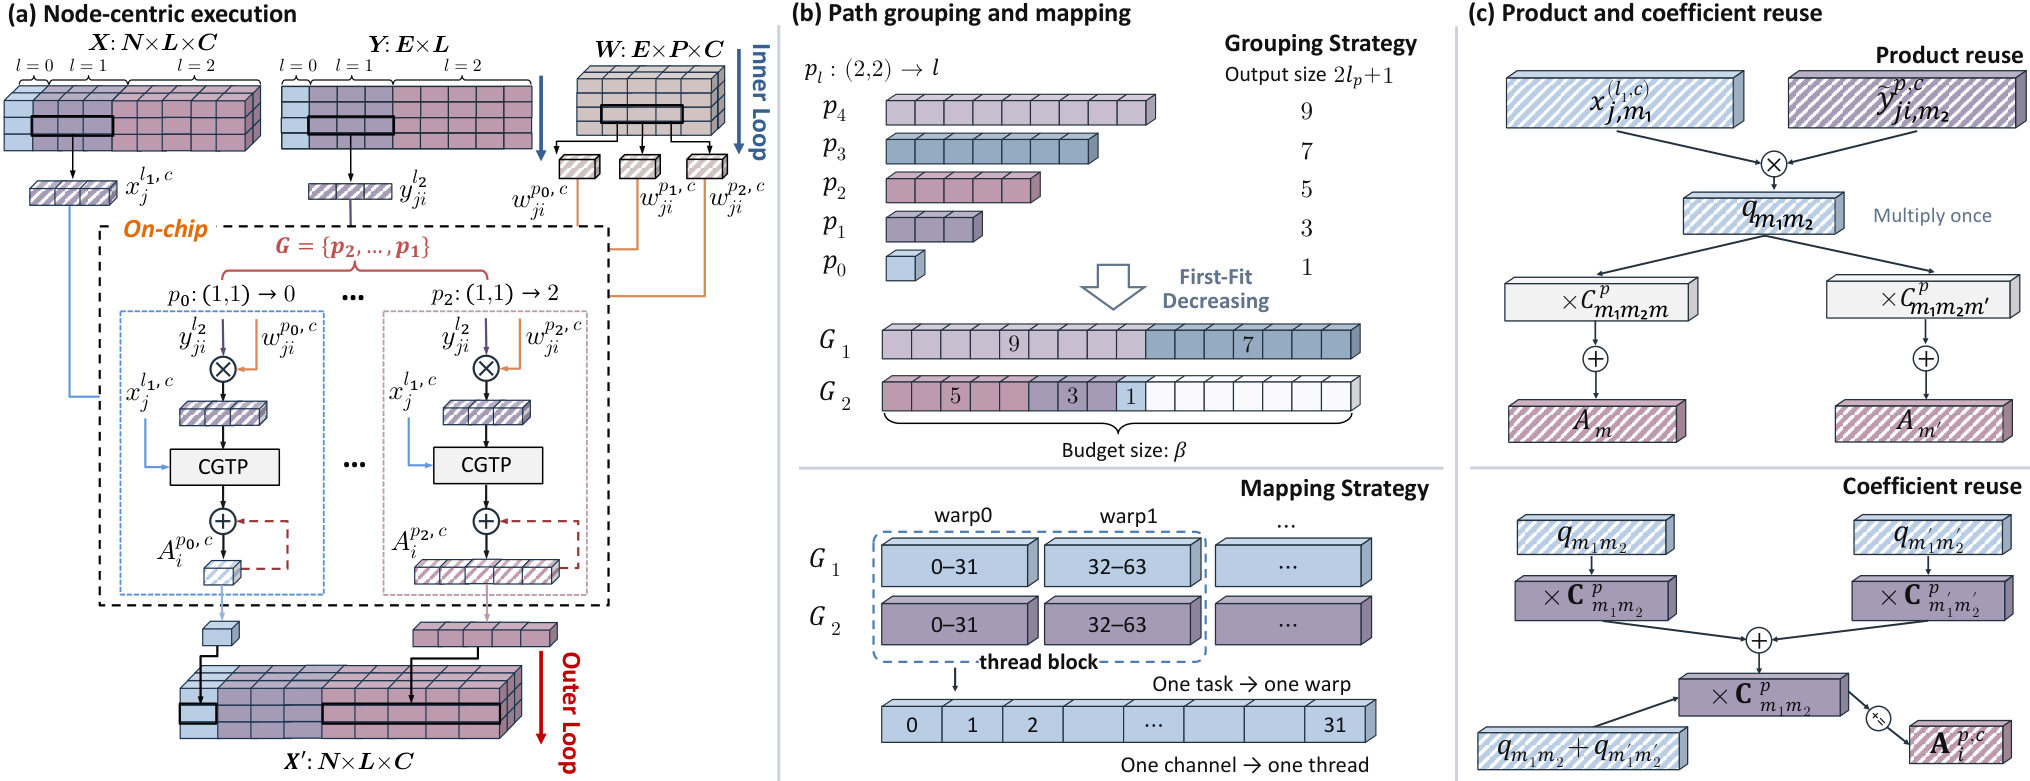
近期补充:10 月 13 日的 LunaTP 保留完整 Clebsch–Gordan 张量积公式,围绕目标节点在片上累积边消息,再按输出分量预算分组计算路径,复用中间乘积与系数。它同时覆盖一至三阶反向,将力与更高阶导数所需的执行开销纳入算子设计。
Yuanchang Zhou 等,LunaTP 论文图 3 · CC BY 4.0,原图未修改。点击图片查看大图。
主微基准在 H100 80GB、FP32 下测试十种 irrep 配置,主要负载含 768 个原子与 37,304 条边,对比 e3nn、FlashTP、OpenEquivariance、cuEquivariance。计时排除初始 JIT、建图及主机到设备传输,不能把 kernel 收益直接等同于完整科研工作流收益;累积顺序改变也不保证逐位相同。
配套公开仓库已可访问,但论文复现声明仍有将公开完整源码的表述,不宜声称整套复现实验都已交付。评估端到端训练时,还应区分相同批量与各实现最大批量两种比较口径。
来源:2026-10-13,A 级|论文与提交记录 · 原文、图 3 与实验范围 · 作者仓库。
Stochastic Latent Twins|直接预测未来状态的分布
近期补充:10 月 15 日的 Stochastic Latent Twins 将确定性编解码与概率形式的潜空间演化分离,学习源时间到目标时间的条件分布,并用构造约束保留已知物理结构。它关注多个可能未来及其不确定性,为科研代理模型提供比单一预测轨迹更丰富的接口。
二维随机 Burgers 实验以 64×64 周期网格生成 10,000 条训练轨迹,比较标准及质量约束版本与调整后的 Latent NSF;评估使用 32 个留出初值,每时间点各 256 个预测和参考样本。训练与参考来自同一离散求解器,不能当作连续方程真解;基线调参、长期一致性仍有限制,代码计划录用后公开,尚不足以声称端到端 HPC 提速。
来源:2026-10-15,A 级|论文与提交记录 · 实验、附录与代码声明。
跨领域 Agent|把视觉输入与物理状态接入闭环
VERID|让实验室执行具有持久状态
Google Research 在 10 月 16 日介绍的 VERID,为自动化实验室建立持久的语义数字孪生,跟踪工作站实体、试剂体积、器件状态与几何关系。系统建立在 PyLabRobot 上,在物理指令派发前复制当前状态做离散检查,并将状态、摄像机画面和执行日志用于诊断及恢复。
原报告给出三组染料与去离子水的概念验证,展示人类参与诊断、监督下重新规划和自博弈等不同闭环。它们验证的是光学与流体操作基础,不能视为已完成生物发现或临床验证。离散状态核算也不是完整流体模拟;未建模偏差仍要依靠真实执行反馈和人工审查发现。
来源:2026-10-16,A 级|Google 原始研究发布 · VERID 原始报告。
Nemotron 3.5 Super VL|开放权重接上多模态部署配方
近期补充:NVIDIA 于 10 月 15 日发布 Nemotron 3.5 Super VL。官方模型卡给出 120B 总参数、12B 激活参数的混合 MoE,结合 C-RADIO 视觉编码器,接收文本、图像与视频并输出文本;NVFP4 权重通过量化感知蒸馏降低存储需求,按 OpenMDW-1.1 条款提供。
模型卡同时给出 vLLM、SGLang 等部署配置。对团队而言,可下载权重与明确配方使专业文档、视觉工具调用等任务有了可自行验证的起点;1M token 是模型支持上限,实际上下文、视频输入和并发仍受具体设备与服务配置约束。厂商基准不能直接换算为业务成本,开放权重也不代表所有训练数据与评测脚手架均已公开。
来源:2026-10-15,A 级|官方模型卡、权重与部署条件;B 级|NVIDIA 工程发布。