AI INFRA DAILY 系统 · 工程 · 研究
MoE 显存、按需授权与机器人接口
日报 ·
- MoE 显存
- 执行权限
- 机器人接口
训练与推理|让执行计划适应资源压力
DIFFLET|固定组件编译,动态决策留在主机
近期补充:10 月 16 日提交的 DIFFLET 面向 Trainium2 上的扩散推理,将固定形状组件提前编译,同时在主机保留管线编排、有效提示长度与逐步缓存决策。设备探针只返回变化分数;常驻进程跨请求保留程序和权重,每次请求则清空采样及缓存状态。
实验使用单个 trn2.3xlarge、一颗 Trainium2 和 96 GiB HBM,默认 BF16、TP4,覆盖 FLUX.1-dev、Qwen-Image、Wan2.1 等模型。注意力比较在同一管线内替换 PyTorch/XLA SDPA;常驻执行则另与每次重载权重的 warm standalone 比较,两类基线不能混用。
部分视频模型缩小了输出,LTX-2 仅运行第一阶段且未采用官方 CFG。Wan 常驻版本因主机解码反而更慢,缓存也可能损失质量。因此,编译与常驻机制应按具体模型和完整管线验收,不能概括成统一、无损的生成加速。
来源:2026-10-16,A 级|论文与首提记录 · 组件设计、硬件和实验边界。
BaGuaLu-2|逐算子选择激活内存策略
近期补充:10 月 16 日提交的 BaGuaLu-2 论文关注 MoE 路由波动引起的激活峰值。系统用运行时成本模型,在重计算、CPU 卸载与低精度存储之间逐算子选择,再交错相邻 micro-batch,将部分额外开销放进流水线空隙。这里的资源配置随实际压力调整,而不是只靠训练前一次性留足显存。
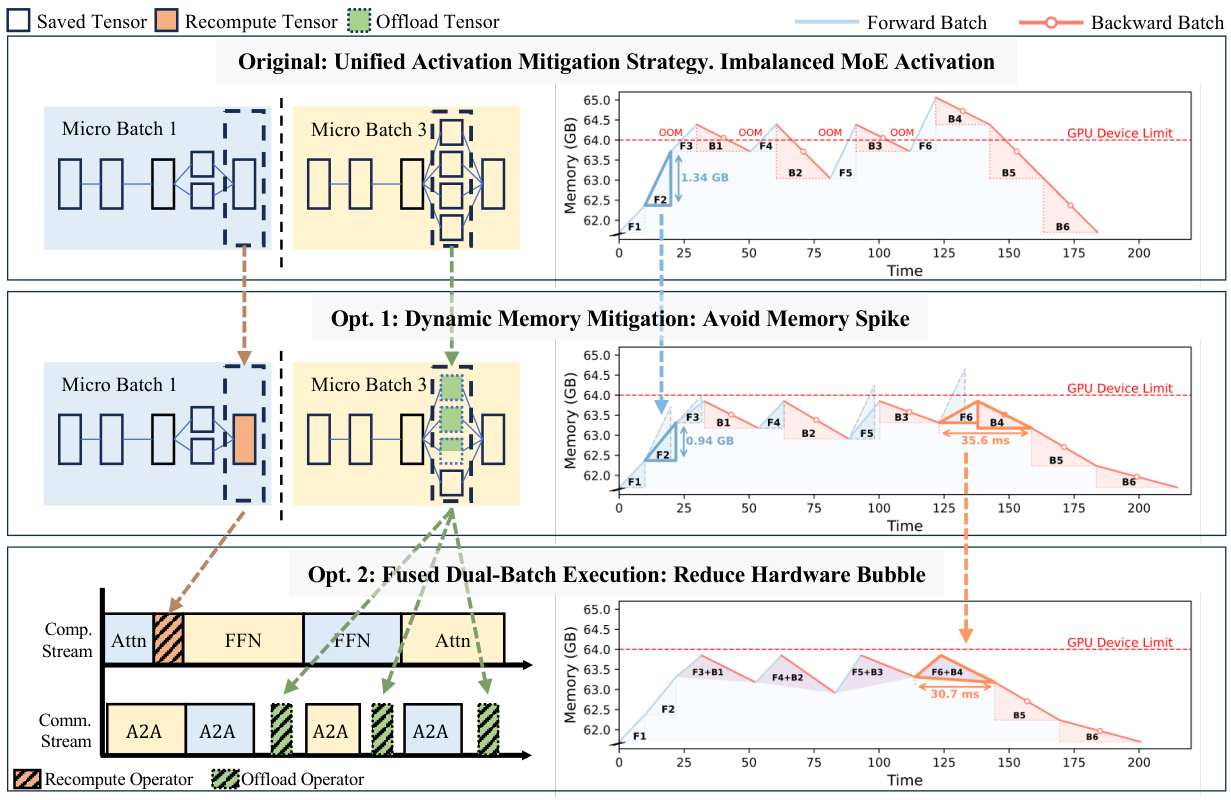
Mingshu Zhai 等,BaGuaLu-2 论文图 7 · CC BY 4.0,原图未修改。点击图片查看大图。
评估采用 128 至 12,288 张未披露型号的供应商 GPU,单卡 64 GB HBM,运行适配硬件的 32 层 GLM 派生 MoE。Megatron-Kuai 基线补充了 MoE 内存建模,AdaPipe 仅使用重计算部分;总体吞吐计入机器重启,但排除人工诊断时间,比较口径需要一起保留。
双批次方案要求流水线并行度大于 2,实验使用至少 4 个阶段;低精度激活存储也不能称为无损。论文提供的是该系统的新预印本证据,不代表原版商业 GLM 已在上述配置完成训练,也不意味着完整代码已公开交付。
来源:2026-10-16,A 级|论文与首提记录 · 运行时流程、基线及适用条件。
Accelerated Dataflow|从流处理管线调度推理
近期补充:10 月 15 日 UTC 提交的 Accelerated Dataflow,把前缀感知分组、基于完成速率的扩缩容,以及 CPU/GPU 独立工作池结合到 RunInference。优化对象是包含推理的流式 ETL:预处理、分组和 GPU 执行会共同决定吞吐,不能只检查模型内部的算子速度。
前缀实验使用 Qwen2.5-7B-Instruct-AWQ、vLLM、OpenOrca 与 Dolly,在 8 个各带一张 A100 的 worker 上与同一 Dataflow 管线比较。扩缩容实验另用 T4、最多 100 worker,输入不超过 512、输出 64 token,在两小时正弦负载下观察响应,不能拼接两套硬件的数据。
分组在低负载下可能增加等待,CPU 工作很轻时拆分工作池也未必有利,键分布还要足够均衡。它为流处理的整条执行路径提供了优化依据,尚不能视为对任意在线 LLM 服务引擎的替代。
来源:2026-10-15(UTC),A 级|论文与首提记录 · 前缀实验与扩缩容条件。
平台工程|授予权限和检查请求各守一层
Cloudflare MCP|缺少权限时再请求扩权
Cloudflare 在 10 月 19 日为 API MCP server 加入 step-up authorization。连接时可以先授予最小权限;工具调用缺少 scope 时,服务器返回 insufficient_scope challenge,再由兼容客户端请求用户批准所需范围。这把宽泛的初始授权转成随任务逐步补充的授权流程。
该流程要求客户端支持相应协议行为,不能认为所有 MCP 客户端都已兼容。原有 scope 会保留,新范围合并进去,也不等于每次操作都会重新审批。权限足够仅表示调用获准进入执行层,参数、目的与实际副作用仍需单独判断。
来源:2026-10-19,A 级|Cloudflare 原始发布 · MCP 授权协议。
Cloud Workload Security|在云 API 前检查请求参数
同日进入 Beta 的 Cloud Workload Security,将云 API 请求交给用户运行的代理检查,再发送给云提供商。workload 决定适用范围,filter 选择操作,Rego 规则验证参数或请求体,policy set 与 deployment 连接这些配置。它补充的是请求执行层,可以约束应用或 CI/CD 发出的具体云操作。
创建 deployment 不会自动接管流量,客户端必须显式经过代理并信任其 CA,原云提供商的 IAM 检查仍然适用。Enforce 关闭时,检查失败只记录而不阻断;未匹配策略按 Default mode 处理,规则错误则另按 On error action。Beta 需要 Zero Trust 订阅,Free 计划满足该前提,但仍须实际部署和配置才能生效。
来源:2026-10-19,A 级|Beta 原始发布;B 级|部署与流量条件 · 请求验证语义。
科研计算|按实际通信和预测路径验收
MailRail|把发送信用改成节点共享池
近期补充:10 月 16 日的 MailRail,将接收缓冲对应的发送信用从每个 MPI rank 独占,改为节点内共享,减少空闲 rank 占有额度、活跃发送者却无法前进的情况。非阻塞发送、缓冲池和协作轮询共同推进通信,目标是缓解多个发送者同时涌向接收端的 incast 拥塞。
实验在 LLNL Dane 运行,使用双路 Xeon Platinum 8480+、Omni-Path/PSM2 与 OpenMPI 4.1.2,覆盖合成 incast、均匀直方图及 8 至 128 节点的 YGM 排序和三角计数通信回放,比较无流控与 rank 流控。回放不执行原应用计算,不能据此声称真实 MoE 或 GNN 训练获得同等端到端收益;应用也必须配合轮询,不能当作替换 MPI 后自动生效的优化。
来源:2026-10-16,A 级|论文与首提记录 · 用户态流控、平台与回放边界。
气候模拟器|分开评估预测器和物理纠正器
近期补充:10 月 16 日的研究将三条路径分开测量:纠正后的预测、纠正轨迹上的网络原始输出,以及完全关闭纠正的递归预测。再交叉训练和推理是否启用纠正、加入非物理对照,避免把最终准确度全部归因于神经网络本身。
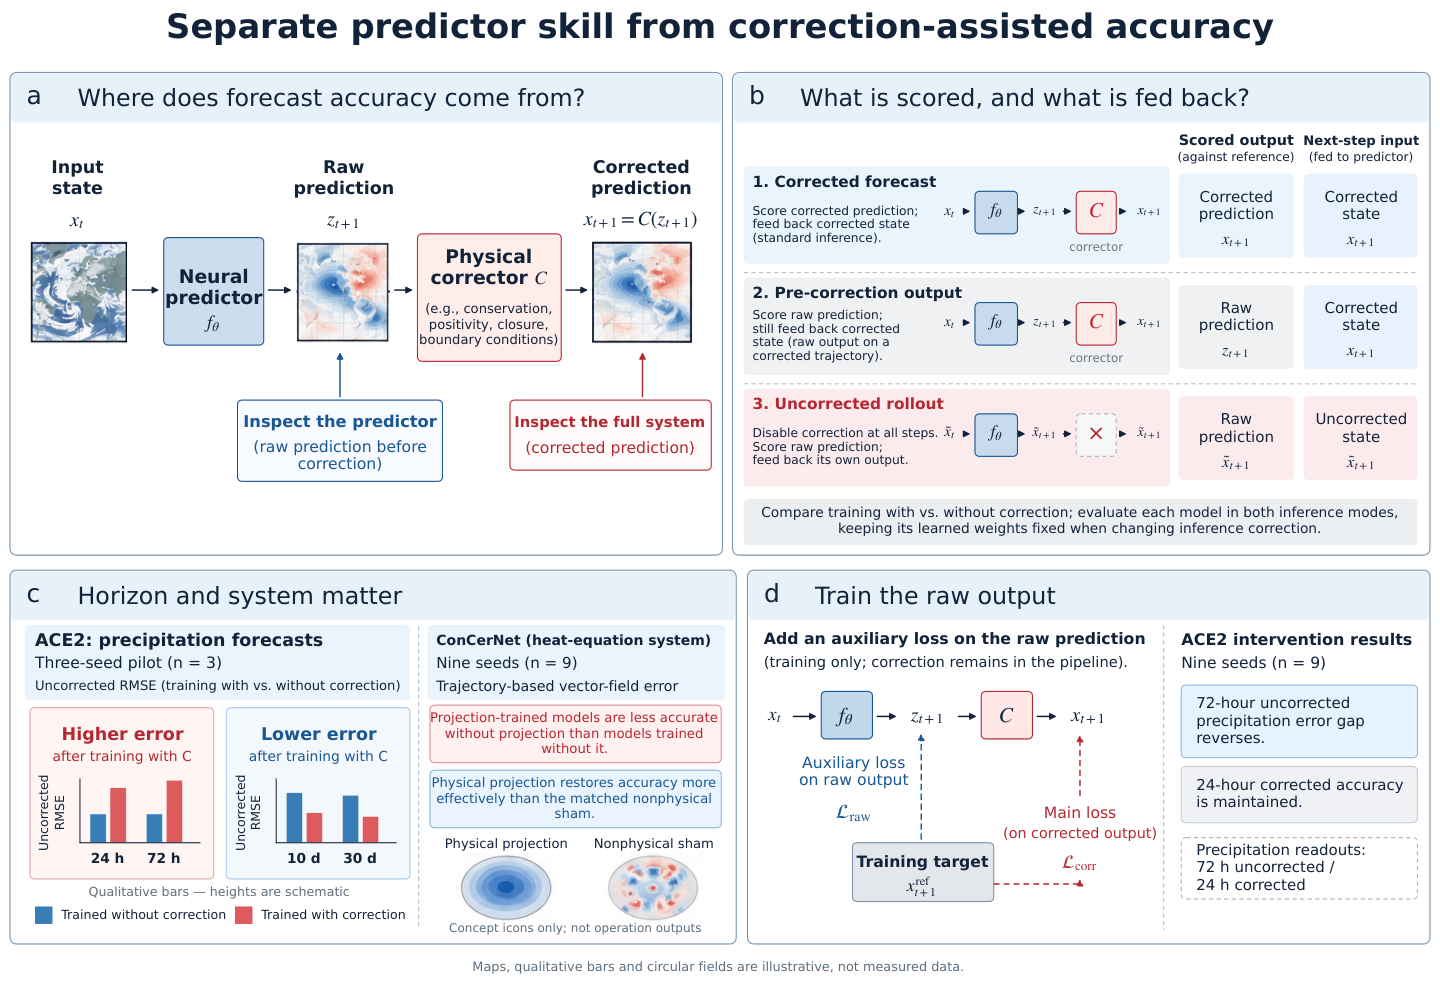
Tianyu Zhang 等,论文图 1 · CC BY 4.0,原图未修改。点击图片查看大图。
ACE2 的三种子试验中,在推理均关闭纠正的条件下,与适应阶段不使用纠正器的模型相比,使用纠正器适应的模型在 24、72 小时的降水误差较大,在 10 天和 30 天却较小。另一组九种子试验显示,直接监督原始输出可以改善短期缺口。因此,结果不能概括成物理约束损害模型,而应检查约束、训练和递归反馈如何相互作用。
评估月份仍处于原 checkpoint 的预训练时期,跨时期泛化没有得到验证,部分长期结果也只有三个种子。研究提供的是贡献归因与依赖评估方法,没有给出可直接采用的 HPC 加速结论。
来源:2026-10-16,A 级|论文与首提记录 · 三条评估路径、干预与限制。
跨领域交付|共享接口仍需明确执行条件
DeepSeek 1017|模型更新同时明确提示编码契约
DeepSeek 在 10 月 17 日发布 V4.1-Flash-1017 检查点,官方模型卡报告推理、编码、Agent 与视觉任务的改善,仓库和权重按 MIT 许可提供。这是明确的新版本交付;其评测依赖指定 harness,不能仅凭结果表推导业务壁钟时间或部署成本。
该版本不附 Jinja chat template,而提供带测试的 Python 提示编码参考;配套协议工具把不同 API 格式转换成模型会话,并解析思考、工具调用和图像内容。推理目录则明确定位为可读参考实现,采用普通自回归采样。集成时需要核对完整提示格式、输出解析与运行时能力,不能把协议转换工具或最小推理示例当作完整生产服务。
来源:2026-10-17,A 级|官方模型卡与权重 · 正式发布提交记录 · 固定发布版本的推理说明。
Dream-1|用末端位姿连接未见过的双臂机器人
Dream Labs 在 10 月 19 日发布 Dream-1 并开放公共 API。公司研究页介绍了联合预测视频与动作的 World Action Model,并用双臂末端位姿和夹爪开合构成共享动作接口,再由每个机器人的逆运动学求解器转换成关节指令。开发者获得的是可调用的机器人策略服务,跨本体能力仍是需要按具体设备检验的研究主张。
公司公布了未见本体的模拟评估和真实机器人演示;演示片段与模拟统计并不代表所有任务的稳定成功率。末端接口也不能决定机械臂到达目标的完整路径,效果依赖 IK、工作空间和动力学差异。当前是研究 Beta,尚未验证安全关键用途;采用自身数据的 FaaS 微调结果也不能混作零样本能力。
来源:2026-10-19,A 级|Dream Labs 原始研究发布 · 官方发布公告。