AI INFRA DAILY 系统 · 工程 · 研究
缓存命中核验、沙箱恢复与远程动作缓冲
日报 ·
- KV 缓存
- Agent 执行
- 机器人控制
缓存与推理|读回上下文前,先确认可用与可读
KVGuard|为缓存块记录请求权限和初始化状态
KVGuard 为分页注意力的物理 KV 块维护影子元数据,记录哪些请求可访问该块,以及具体位置是否已经写入。检查覆盖 CPU 上的分配、块表构造与转换,也进入 GPU 上的块表查找与读写。这样可以在页已映射但权限或初始化状态错误时发现问题。论文回放了 29 个历史缺陷,并报告发现 8 个新缺陷。
作者用单张 H100 80 GB 跑 Qwen 2.5 14B 和 ShareGPT V3,开启五类检查及出错即终止模式。相对关闭插件,vLLM 0.32.0 和 SGLang 0.5.22 的每输出 token 时间分别增加 3.0% 和 7.4%(几何均值)。Llama 3.2 1B 的逐步计算更短,检查开销占比明显更高。该原型适合纳入回归与调试,检测范围限于 KV 访问,前缀哈希碰撞仍需其他检查。
来源:2026-11-04(UTC 首提),A 级|原论文记录 · 影子状态、缺陷回放及测试条件。
Supermicro 联合方案|用共享闪存持久化长前缀
Supermicro、IBM 与 NVIDIA 发布共享 KV 缓存方案,将 Petascale 全闪存服务器、IBM Storage Scale ECE、Dynamo 和 Spectrum-X 接到同一推理路径。Dynamo 可从共享层读回已计算的 KV,经主机内存分块送入 GPU。存储容量因此可以独立于推理节点扩充,读回仍要经过网络和主机传输。
IBM 的单请求试验使用八节点存储、一张 RTX PRO 6000 Blackwell 运行 MXFP4 的 GPT-OSS 120B,KV 采用 FP16。测试关闭 Dynamo 的 GPU 与主机缓存层,以隔离外部存储。130K token 提示暖命中时首 token 约 0.57 秒,无缓存重算为 32.14 秒。收益取决于前缀复用及传输条件,横向比较其他缓存架构时还需纳入本地命中与冷启动。
来源:2026-11-05,A 级|Supermicro 原始发布。B 级|IBM 技术报告及完整试验设置。
异构编译|在图上选执行位置,在产物里交付模型
HELIX|按算子切分混合模型的执行图
HELIX 在 vLLM 初始化时从 TorchDynamo 捕获图,再按后端算子支持、显存、计算代价与跨设备传输代价搜索放置。编译器将结果切成后端可执行的片段,运行时安排异步传输。对 Bamba 这类混合模型,mixer 和注意力周边矩阵运算也能进入放置搜索。
论文以 H100 与模拟的 3DCIM 等后端比较算子级方案和固定模块卸载。性能证据混用了实测、性能数据库和模拟,互联也按指定 NVLink 条件建模。当前在初始化阶段决定放置,线上负载切换时的自适应仍待验证。
来源:2026-11-04(UTC 首提),A 级|原论文记录 · 图切分、评测平台与假设。
XLA Serving Engine|将 JAX 模型交给 C++ 服务运行
Google 公布 Apache 2.0 的 XLA Serving Engine。JAX 导出的 StableHLO 函数与 Orbax 权重进入 XLA SavedModel,再由 C++ 服务通过 PJRT 调度设备。当前示例和基准面向一次调用完成的模型前向,长上下文自回归仍适合专门的生成引擎。
DLRM-DCNv2 基准在单芯片 Cloud TPU v6e-1 上固定模型、权重与 gRPC 协议,服务端各用 8 个主机 CPU 核。p99 不超过 20 ms 时,每请求 1、16、128 个样本的吞吐约为优化 Python 多进程方案的 5.0、2.0、1.14 倍。数据取三次 30 秒同机回环试验的中位数,C++ 查表及不同批处理实现也参与了差异。
来源:2026-11-05,A 级|Google 原始发布 · XLA Serving 原仓库。B 级|DLRM 基准口径。
Agent 工程|把执行状态、提前调用和最终验收分开
Agent Substrate|Actor 快照独立于预热 Worker
Google 宣布捐赠已获 CNCF Sandbox 接纳的 Agent Substrate、gVisor 和 OpenRL。Agent Substrate 达到 1.0,GKE 版本正式可用。Actor 持有会话状态与身份。应用挂起 Actor 后,系统保存内存和文件,归还 Worker,下次请求可在池内另一 Worker 恢复。Gateway 依据 Actor 身份执行访问策略。
符合条件的客户可在自己的 GKE Standard 集群部署,控制平面和节点池均需 1.37 及以上。应用需要在恢复后重连数据库或 MCP 等外部服务。Actor 目前无法直通 GPU,gVisor 也无法快照活跃 CUDA 上下文。评估节省的常驻资源时,需要同时计入预热池、快照存储和恢复路径。
来源:2026-11-05,A 级|Google Cloud 原始公告。B 级|GKE 运行机制及限制。
Teel|提前发起可缓存的 I/O 调用
AI21 公开 Teel 原型。它在 CPython 3.12.13 上扫描标记函数的字节码,遇到参数已经确定的可缓存 I/O 就交给线程池提前执行。真正的 Python 线程仍决定分支,按函数与序列化参数合并在途调用并复用成功结果。v0.2.2 已提供 PyPI 源码包。
可缓存函数须有可序列化的入参、同输入同输出且无外部副作用。已经等待同一调用的执行者可能收到异常,后续遇到失败项可重新执行。提前调用可能落到最终没走的分支,消耗额外 I/O 或付费模型 token。依赖时钟、隐式状态或数据库写入的函数需要留在正常执行路径。
来源:2026-11-05,A 级|AI21 原始发布 · Teel v0.2.2 实现 · v0.2.2 源码包。
ServerBench|开发回放之后,重建部署做独立终验
ServerBench 给编码 Agent 一组保留多轮依赖的会话,让它们在 8 小时内调整服务实现和并发。提交后评测方在全新部署上用不同随机种子回放 1,800 秒,检查完整请求、流式输出、自然停止与检查点保真。33 次运行中有 22 次交付通过验证,其中 13 次超过最强基线。
在单张 L40 的 Gemma-4-E4B-it 任务,Claude Sonnet 5.5 方案以会话并发 32 得到 2.97,vLLM 0.28 对照以会话并发 8 得到 0.61。指标用同时满足首 token 和逐 token 延迟门槛的 token 价值除以 GPU 成本,采用冻结计价,开发 API 费另计。会话由原负载重建并保留结构,结果适用于该负载与计价设定。
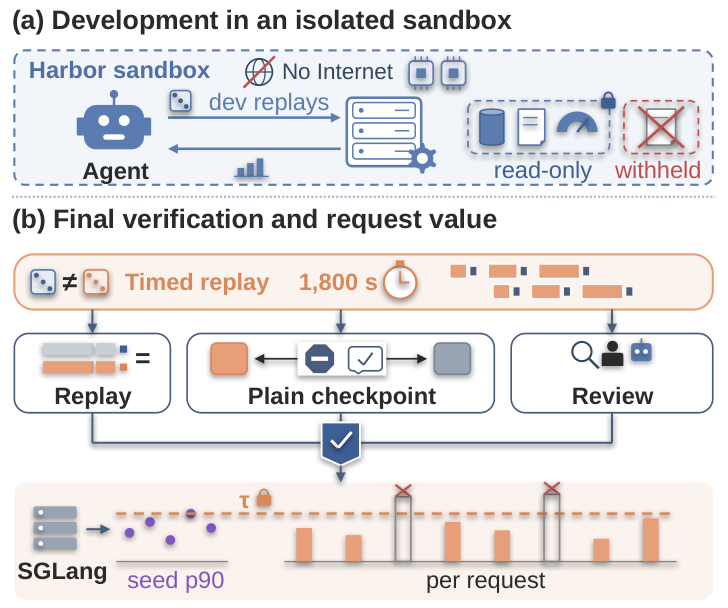
来源:2026-11-04(UTC 首提),A 级|原论文记录 · 回放方法与计分条件 · 公开任务与评测仓库。
机器人与科研|把新输入接到可验收的输出
LeRobot v0.7|机器人端缓冲动作,GPU 服务端续算
LeRobot v0.7.0 提供 Zenoh 策略服务,远端接收观察与指令并返回动作块。相机、电机、遥操作与记录仍由机器人端处理。客户端执行现有队列时,服务端可继续推理。新块到达后,客户端剔除过期动作并混合重叠目标,兼容检查点可用实时分块机制让新动作接上剩余轨迹。
这种分工将网络和推理等待藏进动作缓冲。缓冲能否覆盖实际延迟,仍要结合控制周期、网络抖动和模型耗时测量。该版本还引入 FSDP2 与分布式检查点。旧 FSDP1 检查点可加载模型权重,训练状态无法直接续接。
来源:2026-11-05,A 级|v0.7.0 发布记录 · PyPI 安装包。B 级|维护者交付与迁移说明。
Molecular Prior Networks|把已有亲和力测量放进一次前向
这项研究在 4,938 个 FS-Mol pIC50 任务上做元训练。进入新任务后,已测分子的指纹和亲和力标签与待排序分子一起送入 Transformer,一次前向即可给出预测,省去针对每个任务重新拟合的步骤。
在 16 个支持分子的 FS-Mol 回归评估中,Kendall τ 约为 0.299,ADKF-IFT 对照约为 0.298。支持集从 32 增至 256 个时,对照方法领先。256 个支持分子的结果覆盖 111 个测试任务中的 43 个。这个结果为少量测量时的候选排序提供证据,实际分子仍需实验验证。论文所列仓库目前无法读取,代码与权重的可用性待核验。
来源:2026-11-03(UTC 首提),A 级|原论文记录 · 训练数据、支持集和排序结果。