AI INFRA DAILY 系统 · 工程 · 研究
长上下文按需补精度,技能包按修订扫描
日报 ·
- 训练通信
- 长上下文推理
- 技能治理
训练与推理|按数据就绪状态安排工作
KOSMOS|让 GPU 工作组在通信和计算之间切换
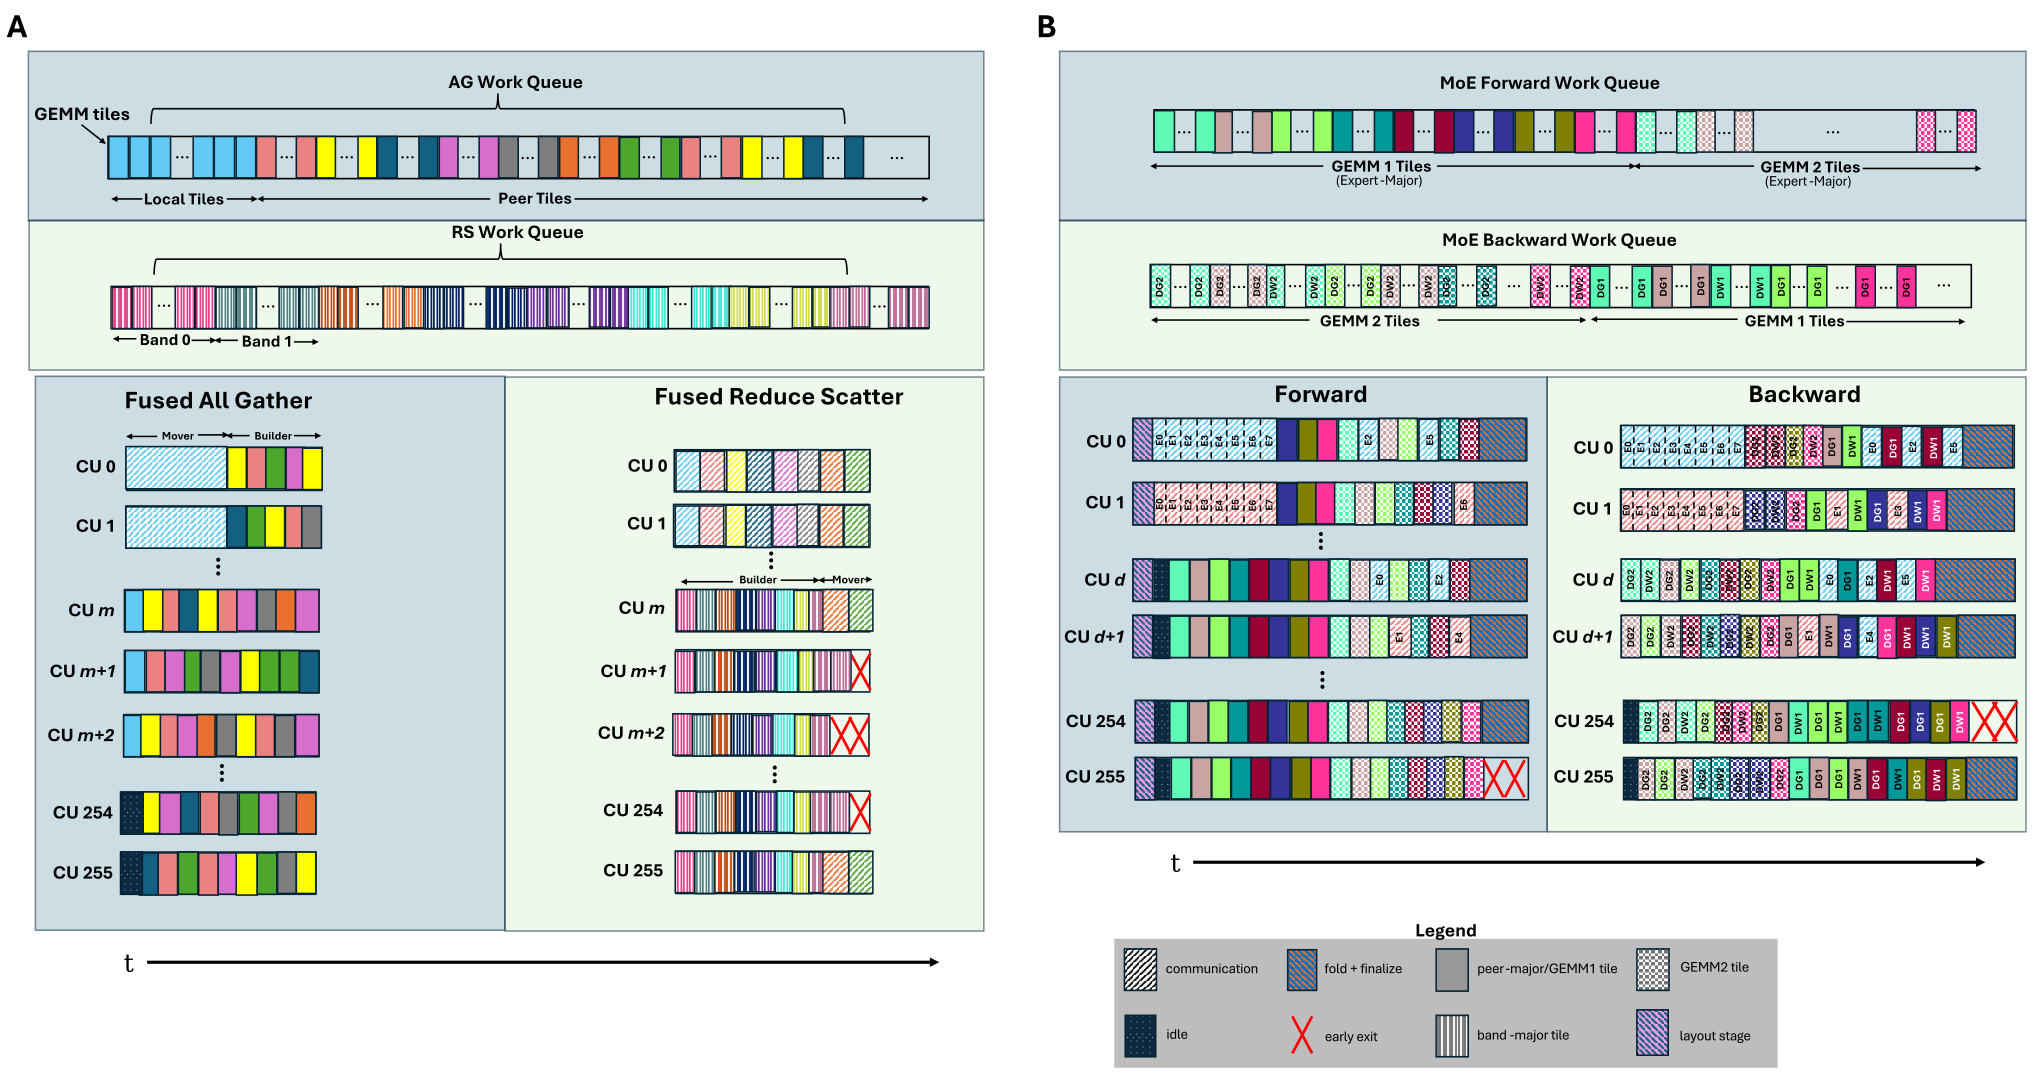
KOSMOS 让常驻 GPU 工作组根据数据块的就绪计数,在搬运和矩阵乘法之间切换。任务队列按消费者需要的顺序组织数据块。张量并行的 all-gather 和 reduce-scatter 可利用较规则的进度单向切换,MoE 合并则允许工作组来回切换,应对更不规则的数据到达。
论文表 3 中,作者用单节点 8 张 MI355X(XGMI 互联)训练 Llama 3 8B,使用 BF16、TP8、8192 序列长度和全局批量 64。按相同微批量对照,Megatron-LM 中的训练迭代速度是 ROCm Transformer Engine 基线的 1.24–1.28 倍。这是单节点训练步的结果,尚不能说明多节点缩放或训练收敛用时。
来源:2026-11-05(UTC 首提),A 级|KOSMOS 原论文与训练对照。
StrataFlux|把精度残差留在 GPU 外
StrataFlux 将低位权重和 KV 缓存留在 GPU,把精度残差放在主机内存或 SSD,需要时异步取回并复用。未补精度的 KV 仍以低位形式参与完整前缀的注意力计算。系统用额外的数据传输换取显存空间,实际收益取决于残差能否复用,以及传输能否与解码重叠。
论文表 A33 使用单张 RTX 5090、Llama-3.1-8B-Instruct 和 128K 上下文。YAQA 3 位权重加 KVarN 2/2 KV 的补精度配置达到 102.0 token/s,vLLM 的 AWQ4 加 FP8 KV 基线是 106.8 token/s;两组的权重与 KV 存储占用分别为 7.3 GB 和 14.3 GB。数字只计算权重和 KV,不能当作进程峰值显存;单卡解码结果也未覆盖线上并发或其他互联条件。
来源:2026-11-05(UTC 首提),A 级|StrataFlux 原论文 · 表 A33 与测试配置。
基础设施与科研编译|从存储节点到模式接口
Z4M|把高密度本地盘接入训练集群的数据路径
Google Compute Engine 在部分区域开放 Z4M 虚拟机和裸金属实例。最大规格带 168,000 GiB 本地 Titanium SSD,内网出站带宽规格最高 400 Gbps,并支持 Cloud RDMA。训练检查点、并行文件系统和分布式 KV 缓存可以部署在这类存储节点,再通过网络服务加速器集群。
Z4M 本身不支持挂载 GPU。配不超过 42,000 GiB 本地盘的虚拟机才支持实时迁移,更大规格和裸金属实例在计划维护时需停机重启,文档注明计划维护后会保留本地盘数据。选型时要把读写路径和维护窗口一起算进集群设计。
来源:2026-11-06,A 级|Google Cloud 正式发布。B 级|机型规格与维护限制。
xDSL-CCPP|把气象物理接口变成可转换的中间表示
xDSL-CCPP 用 xDSL 和 MLIR 的中间表示重做大气物理参数化的耦合代码生成。它保留旧 XML 与 Fortran 元数据入口,新增 Python 描述方式,能生成 Fortran 封装或 LLVM IR。这样,变量的输入输出和物理方案的调用顺序可以先作为结构化数据处理,再交给不同后端。
论文在 Cirrus 的 AMD Zen 5 Turin CPU 上,以 GCC 14.2 测了四套 NCAR 单柱模拟,生成的 Fortran 路径运行时间与旧生成器相近。代价在生成阶段:三个小样例由约 0.27–0.29 秒变为 0.79–0.86 秒。源码可查;这些对照尚未覆盖完整气象模式或 GPU 后端。
来源:2026-11-05(UTC 首提),A 级|xDSL-CCPP 原论文 · 项目源码。
Agent 工程|让技能包和执行结果分别接受检查
Agent Registry|把扫描结论绑定到技能修订
Google Cloud 将独立 Skill、不可变 SkillRevision 与发布者信息的登记和版本治理转为正式可用。10 月 30 日的更新解决的是跨项目发现与管理范围,本次交付将检查落到具体技能包。默认阻断策略异步扫描新修订。存在发现的修订不能下载,存在发现或等待扫描的修订不能提升为默认版本。
组织可用自定义约束限制 Skill 创建和更新时的扫描模式,也可保留非阻断审计。策略变更只影响之后创建的修订,历史包要创建新修订才能补扫。扫描完成与没有 Finding 是两个状态,超出解压大小限制或不支持的格式也需要单独处理。
来源:2026-11-06,A 级|Agent Registry 当日发布记录。B 级|修订扫描、组织策略与限制。
DiagDBench|运行修复脚本后再测数据库
DiagDBench 将手册引导的故障合成与事故记录引导的复现放进数据库容器,提供 6,940 个合成训练样本和 454 个专家标注的留出测试。任务涵盖 PostgreSQL、MySQL、三种硬件资源配置和三种 schema。Agent 可交付诊断、修复脚本及可选的改写查询。
评测实际执行修复并比较故障注入前与修复后的负载延迟,预热一次后取五次计时的中位数。报告质量和改写查询的语义等价仍依赖模型裁判。这个组合可以揭示诊断文字与可执行修复之间的差别,得分还受容器环境、样本构造和裁判设定影响。
来源:2026-11-05(UTC 首提),A 级|论文与实验口径 · 任务、容器及评分脚本。
模型交付与应用|视频、基因组和机器人
Gemini Omni 1.2 Flash|把生成、条件编辑和超分分开
Gemini Omni 1.2 Flash 在 Gemini API 和 Gemini Enterprise Agent Platform 正式可用。生成与编辑可输出 3–15 秒的带音频视频,按首尾帧生成的片段和延展时新增的片段为 3–10 秒。超分也可以独立调用,已有片段不必重新生成。
对制作流程而言,片段生成、条件编辑和超分可以作为不同操作分别调用。不同操作的时长上限仍需分别处理;发布演示也没有提供同分辨率、同负载下的质量或延迟对照。
来源:2026-11-05,A 级|Google 原始发布。B 级|模型能力与输入输出限制。
AlphaGenome|按端点类型流式返回基因组张量
Gemini Enterprise Agent Platform 的 alphagenome-004 将七种 DNA 分析方法和 11 种基因组输出模态纳入统一服务。共享端点经 HTTP/2 gRPC 返回张量分块,专用端点经分块 HTTP 返回 protobuf 数据。SDK 支持指定单个或全部模型折叠权重,并发执行计算机模拟的饱和突变评分。
流式接口改变的是客户端如何接收和处理大型输出。发布材料未量化同负载下的延迟变化,也没有证明预测质量提升。官方文档还注明 Python SDK wheel 需另行获准访问,接入前应核对端点和 SDK 权限。
来源:2026-11-04,A 级|Agent Platform 版本记录。B 级|AlphaGenome 端点及 SDK 文档。
SLA|用冻结的 3D 教师补视觉动作预训练
SLA 在继续预训练 π0.5 时,用门控汇聚视觉中间层,再与冻结的 3D 教师对齐,同时随机丢弃部分机器人状态输入。辅助头只用于训练。作者同时开放了实现、检查点与真机示范数据。
论文表 11 在双臂 Piper、单臂 Franka 和 RealSense D435 的八种真机条件下,按每种条件 50 个计分对象实例计算,八项平均成功率为 83.8%,对照 π0.5 为 59.8%、Spatial Forcing 为 68.0%。结果依赖指定后训练数据和场景;RoboDojo-Real 的部分任务另有历史图像输入,不能用辅助头的训练期限制概括整套推理流程。
来源:2026-11-05(UTC 首提),A 级|SLA 原论文和真机对照 · 作者代码及工件入口。