AI INFRA DAILY 系统 · 工程 · 研究
TPU 状态跨层搬运,训练数据按就绪期限分派
日报 ·
- TPU 集群
- 训练调度
- Agent 沙箱
推理传输与交付
TPU Sync|保持张量布局跨主机搬运 KV
Google 开源了 TPU Sync。它以异步 DMA 在 TPU HBM 与锁页主机内存之间传输张量,保留 TPU 的物理分块布局。预填充与解码分离时,KV 先从预填充设备卸载到主机内存,经数据中心网络传到解码主机,再写入解码设备。主机内存也可扩展前缀缓存,本地 SSD 和共享存储是实验性的下一层。
在 Google 的内部测试中,2×2×1 Ironwood(TPU v7x)以每芯片 PCIe Gen5 x16、每主机一至两张 200 Gbps 网卡运行。与未使用 TPU Sync 的受控低并发分离部署相比,Qwen3 235B 的平均首 token 延迟降低约 60%。生产效果取决于前缀复用率、网络带宽和并发。用于 RL 权重同步的传输和重分片能力仍属实验模块。
来源(2026-11-09,A 级)Google Cloud 发布及测试配置 · TPU Sync 原仓库。
vLLM|CUDA wheel 采用稳定 LibTorch ABI
vLLM v0.33.0 的 CUDA wheel 转向 LibTorch Stable ABI。维护团队把 C++ 扩展迁到稳定的 C 接口及包装层,并迁移 FlashMLA、DeepGEMM 等编译依赖。持续集成检查二进制引用的 PyTorch 符号及其最低支持版本,让兼容的 PyTorch 升级可以复用同一个 vLLM wheel。
11 月 6 日的工程说明用开发版 wheel 演示了在 PyTorch 2.15.0+cu132 下导入和生成。部署仍需核对 Python API、CUDA 和第三方依赖。CPU、ROCm 构建的迁移在该文中列为后续工作。
来源(近期补充,2026-11-02,A 级)v0.33.0 发布记录。来源(2026-11-06,B 级)维护团队迁移说明。
训练运行时
DataHelix|给下一批数据设就绪期限
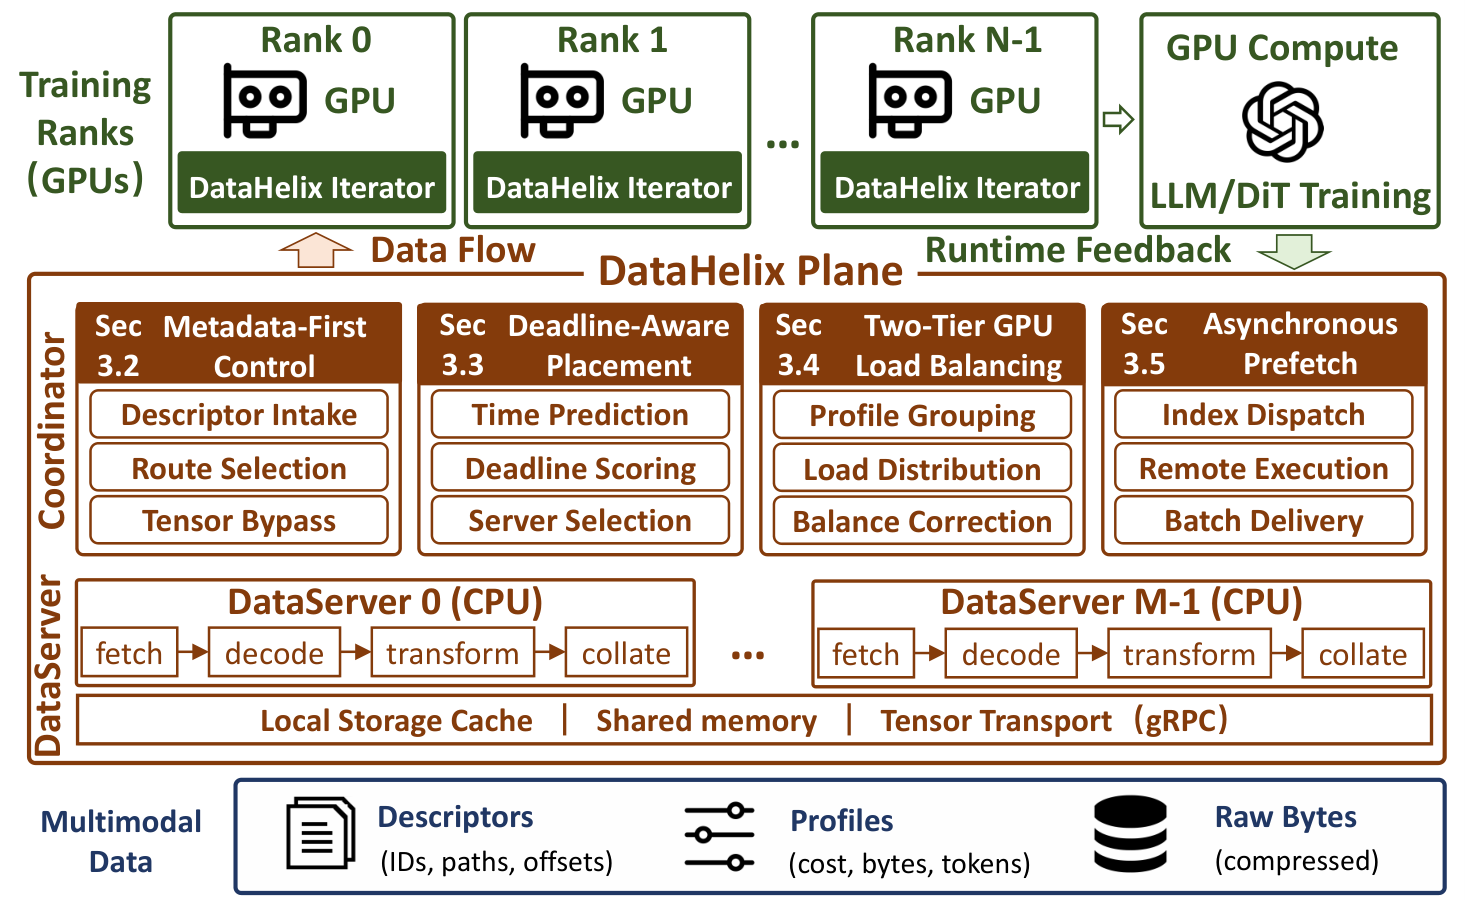
同步训练中,各训练进程完成当前批次的时间不同,给下一批预处理留下的窗口也不同。DataHelix 按这个窗口设定就绪期限,在样本还是轻量描述符时分派 CPU 解码任务。解码后的大张量绕过协调器,只有预期减少的等待足以抵消传输代价时,系统才重新分配数据。
论文表 2 在单机 8 张 Ascend 910B 上测试 11 项视频与视觉语言负载。吞吐的几何平均值分别是各训练进程独立运行 PyTorch DataLoader 的 2.72 倍,以及同为 96 个 CPU 核的 Ray actor 池的 1.82 倍。相对 Ray,DataHelix 的输入等待 P95 按负载取算术平均仍更高。部署时要分别测总吞吐和尾部等待,尤其要计入跨节点搬运。
来源(2026-11-06 首提,11-09 公告,A 级)DataHelix 原论文与表 2。
Cloud Pathways|单个 JAX 客户端编排多个 TPU 切片
Cloud Pathways 已在 GKE 正式可用。一个 JAX 客户端经 IFRT 代理编排多个切片,统一协调图执行和异步下发。与 TPU 工作进程同节点的 Python sidecar 可执行数据加载与检查点写入。配置弹性训练与主机快照后,切片中断时可把训练状态重新分片到剩余切片。
GKE 的正式可用范围覆盖支持 TPU v5e、v5p、v6e 和 v7x 的区域,需使用对应的 JAX 和容器镜像。Cluster Director 上的 Slurm 接入仍为预览。恢复能力需要作业配置和资源条件配合。
来源(2026-11-09,A 级)Cloud Pathways 正式发布 · Google Cloud 版本记录。
芯片与云资源
TPU 8tx 与 8i Max|同代芯片组成两种系统
Google 公布两套第八代 TPU 系统。8tx 沿用 8t 芯片,搭配第五代 AMD EPYC 主机与 Boardfly 互联,面向机密推理和小规模训练。8i Max 把两颗 8i 芯片放在同一封装,厂商给出的算力、SRAM 容量和 HBM 带宽均为 8i 的两倍。
这些是系统配置和规格。长上下文服务的实际吞吐仍取决于模型分片、内存容量和互联,机密部署则需要逐项核对信任边界。原公告尚未给出这两套系统的正式可用日期和区域。
来源(2026-11-09,A 级)Google 原始公告。
EKS DRA|按设备属性与拓扑申请 GPU
AWS 为 EKS Auto Mode 与 Karpenter 增加动态资源分配(DRA)支持。Pod 可以用 ResourceClaim 按设备属性申请 GPU 或 EFA,也能约束两者共享 PCIe 根。已有节点不满足条件时,扩容器可依据支持机型的设备信息选择新节点。
EKS Auto Mode 需要 Kubernetes 1.36 或更新版本,并要求建立 DeviceClass。同一节点的同类设备应只由 DRA 或传统设备插件的一方管理。自管 Karpenter 的 DRA 扩容仍为 Alpha,需要开启功能开关并配置驱动。AWS 此次公告的区域范围排除了 GovCloud 和中国区。
来源(2026-11-09,A 级)AWS 发布公告。(B 级)EKS 加速设备说明 · Karpenter DRA 说明。
平台与 Agent 隔离
Nitro Sandboxes|把虚拟机边界下沉到 Pod 和 Task
AWS 为选用 Nitro Sandboxes 的 EKS Pod 和 ECS Task 提供独立的轻量虚拟机。EKS 的隔离模式仍信任父实例。机密模式将父实例排除在信任边界之外,外部验证器可依据运行证明决定是否放行密钥,例如由 KMS 检查度量值。
该功能已在支持的 AWS 商业区域开放,依赖兼容 Nitro Enclaves 的实例类型。EKS Auto Mode 自带 RuntimeClass,标准节点需使用启用沙箱的 AMI。对运行外部工具的 Agent,沙箱隔离和工具本身的授权仍要分别配置。
来源(2026-11-09,A 级)AWS 发布公告。(B 级)EKS 隔离与机密模式。
Red Hat EnMaaS|在统一网关管理模型与配额
Red Hat 公布内部试点 EnMaaS 的实现。Praxis 网关用统一凭据接入外部商业模型和内部部署的开放权重模型,并按用户、团队和模型计量用量。后端由 llm-d 和 vLLM 调度内部推理,网关可以在商业配额耗尽时按规则把后续请求转到自托管模型。
这让平台团队能够在同一入口配置可用模型和额度。自动回退需要在目标任务上检查替代模型的工具调用、输出质量和延迟。公告描述的是 Red Hat 内部试点与开源组件组合,成本和流量比例也来自该内部部署。
来源(2026-11-09,A 级)Red Hat 原始试点说明。
实时交互与机器人
MOSS-Live|实时对话与长任务分别运行
OpenMOSS 发布 MOSS-Live 的在线体验和实时 API。前台模型负责持续收音、判断轮次和发声,也可接收相机或屏幕帧。接入方可以配接后台模型与执行工具,让推理或长任务继续运行,前台通过共享上下文和任务状态向用户反馈。
实时接口要求客户端回报实际播放进度,收到停止事件后清理对应回复的待播音频。后台任务的运行、进度和取消仍由接入方负责。当前公开仓库提供文档、评测资料与演示素材。
来源(2026-11-07,A 级)OpenMOSS 原始发布 · 项目原仓库。(B 级)实时 API 接入说明。
GR00T 2|同时预测未来视频与动作块
NVIDIA 在 CoRL 公布 GR00T 2。模型使用扩散 Transformer 联合去噪未来视频和动作块,再由针对不同机器人的动作头映射为执行指令。视频预测与动作预测共享训练目标,研究团队据此检验人类视频和其他机器人示范能否帮助目标机器人完成新任务。
在双 Sharpa 手平台的 50 项任务中,目标机器人没有对应演示时,研究团队报告平均每次试验的成功率为 40%。按每项任务加入五次示范,再在单张 RTX 5090 上各做 30 分钟 LoRA,平均成功率为 95%。这些结果适用于该任务集与设备。官方项目页将代码发布安排在 12 月。
来源(2026-11-09,A 级)NVIDIA CoRL 公告 · GR00T 2 项目及实验。