AI INFRA DAILY 系统 · 工程 · 研究
推理副本从快照恢复,端侧模型移植用实机验收
日报 ·
- 推理部署
- Agent 工程
- 多模态生成
推理服务与训练调度
NVIDIA Snapshot|从已初始化状态恢复推理副本
NVIDIA 开放了 Kubernetes 上的 GPU 工作负载快照工具。它把已初始化进程的 CPU 与 GPU 状态存入共享存储,在兼容的节点上启动引用该快照的新 Pod。推理引擎可直接恢复权重、编译产物和已捕获的 CUDA Graph,减少副本接流量前的初始化等待。
NVIDIA 在 B200 和 VAST NFS 上测试 vLLM 运行 Qwen3-14B、张量并行度为 2 时,常规冷启动用时 139.63 秒,快照恢复用时 6.19 秒。制作 48.29 GB 快照另用 38.37 秒。恢复要求匹配的 GPU 和驱动,当前仅支持单节点工作负载。扩容还要计入节点供给、镜像拉取和存储争用,项目 API 仍可能变更。
来源(2026-11-10,B 级)NVIDIA 工程说明及测试 ·(A 级)Snapshot 原仓库。
TKNP|跨机分层放权重,注意力留在请求节点
Decode Token Parallelism 将一份模型权重按层块分布到多台机器。当前层的持有节点在本机 NVLink 域内执行投影与 MLP,各节点用本地 KV 为自己的请求计算注意力。网络搬运的是当前 token 的激活,注意力结果无需跨节点归并。
在 32 张 H100 上,vLLM 原型以 Llama 3.1 405B 为每个请求生成 1,024 个 token。长上下文和高并发条件下,完成吞吐最高为同卡数数据并行的 2.06 倍。低并发时数据并行领先,部署时应根据排队和 KV 容量压力选择布局。
来源(2026-11-11,arXiv 新刊,A 级)TKNP 论文。
Modelplane 0.7|为满载 GPU 池调整更新顺序
Modelplane 可以自动建立 CoreWeave Kubernetes 集群、网络和节点池,并安装推理栈,原有模型部署规格可沿用。满载的 GPU 池可能没有空位启动替代 Pod,新版会先停一个旧副本再启动替代副本,避免滚动更新一直等空位。
新版还为每个副本配置两个用于选择服务端点的组件,有空位时跨节点摆放,排空时逐个驱逐。单副本引擎替换期间仍会中断,单 Pod 网关代理也仍可能受节点排空影响。
来源(2026-11-10,上海时间,A 级)Modelplane 0.7.0 发布记录。
训练检查点|用可延后推理平滑功率下降
同步保存训练检查点会使 GPU 集群的功率短时下落。研究团队先预测功率缺口并规划可延后推理任务的启动时刻,再在运行中调整新任务的批大小。恢复训练负载时,推理任务分批退出,减少两侧负载同时变化。
研究用 H100 上 GPT-OSS-20B 的推理功率采样构造负载曲线,再在 PSCAD/EMTDC 中模拟独立数据中心微电网。相对不调度推理的基线,模拟中的频率偏差下降。实际能否调平取决于能提前启动多少推理、空闲 GPU 数量和微电网响应,论文尚无整站现场验证。
来源(2026-11-10,上海时间提交,A 级)检查点感知功率调度论文。
芯片与科研基础设施
AMD EPYC 9006 SP7|合作伙伴服务器开始出货
AMD 宣布,采用首批 EPYC 9006 SP7 处理器的合作伙伴服务器开始出货。这次新增的是服务器的交付状态。面向云、企业和 HPC 的其他型号、平台仍各有时间表。
AMD 同文提到,面向 AI 训练数据处理及 HPC 的 Azure HDv2 仍处于预览。采购或迁移时,整机出货、特定 SKU 可下单和云实例可用是三个需要分别核对的条件。
来源(2026-11-10,A 级)AMD 出货公告。
Lenovo HPC|计算节点、存储和互连一并更新
Lenovo 发布面向 HPC 的 ThinkSystem SC755 液冷计算节点,并更新 SR755 服务器和 DE6800、DE6500 块存储。SC755 支持在单路和双路之间重分区,方便按计算负载调整节点。Lenovo 同时宣布验证 Cornelis CN5000 互连。
对科研集群而言,计算节点上新后仍需分别看 MPI 通信、并行文件访问和检查点写入。公告列出了设备与互连组合,各机构的实际应用吞吐和交付时间还需按配置核验。
来源(2026-11-10,A 级)Lenovo HPC 基础设施公告。
Agent 工程
EngineAgent|把实机回归纳入模型移植验收
EngineAgent 先为端侧引擎建立覆盖导出、运行图与算子后端的层级索引,再用已支持的模型跑通目标设备上的构建、部署和排错流程。接入新模型时,实现、排错和审核三个角色复用这套流程,检查跨层改动并在目标设备上回归。
论文用相同的 GPT-5.6 Sol 在 MNN–CPU、llama.cpp–Vulkan、MLC-LLM–OpenCL 和 ExecuTorch–QNN 四组环境测试 12 项模型移植任务。以通过编译、在设备上运行且 logits 与参考实现吻合为成功条件,EngineAgent 通过 9 项,Codex 基线通过 4 项。样本覆盖三个模型,结果受已验证的引擎与设备组合限制。
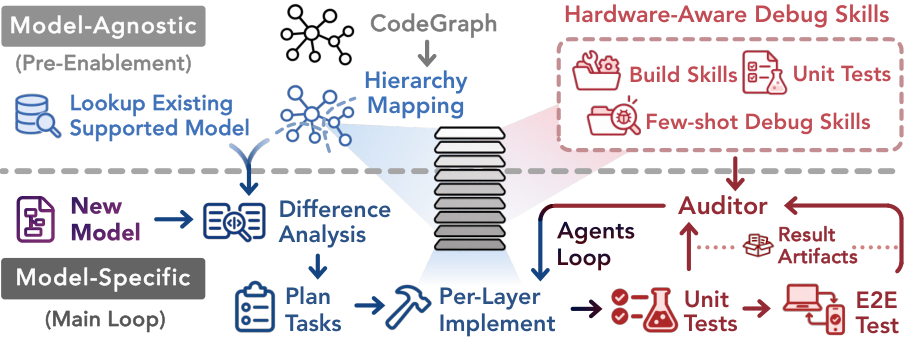
来源(2026-11-11,arXiv 新刊,A 级)EngineAgent 论文及图 4。
AgentCore|网页检索开放独立 API
AWS 为 Bedrock AgentCore 增加了可直接调用的网页检索 API。应用可以在自定义 Agent 循环或流水线内提交查询与域名、日期过滤条件,获取 Amazon 搜索索引返回的排序片段和来源 URL,再自行做证据筛选和答案综合。
接口支持 IAM 授权,也可配置 PrivateLink 和 CloudTrail 数据事件。权限与审计覆盖 API 调用,应用仍需按任务核对来源质量与网页更新时间。可用区域以 AWS 公告为准。
来源(2026-11-10,A 级)AWS 发布公告。
多模态生成
PAN 2|把意图转成带时序的视频描述
IFM 发布 PAN 2 权重,以及预训练、监督微调与推理代码。预训练语言模型先把用户意图转成带时间点、对象状态和镜头动作的描述,29.2B 参数的潜空间扩散模型据此生成视频,可另给定首帧。单个生成窗口最长 20 秒。
团队在不同任务的评估中换用了不同的前端语言模型,因此物理一致性和指令遵循结果都应结合具体前端理解。原仓公开了预训练和微调实现,最终权重还用到了仓库未提供的奖励学习和模型融合过程。
来源(2026-11-10,A 级)IFM 公告 · PAN 2 原仓库。
MiniMax H3-Image|同一模型处理生成和编辑
MiniMax 发布 H3-Image,开放 33.1B 参数的扩散 Transformer 权重,并提供 API 与海螺 AI 产品入口。同一模型支持文生图、参考图生成与编辑。官方模型卡说明公开权重已蒸馏为六步采样,可直接生成约 16 MP 的图像。
自托管还需单独下载约 66.7 GB 的 H3 文本编码器。高像素输出需要按实际运行时和硬件验证显存与延迟。权重采用社区许可,对使用地区及面向第三方提供托管服务均有限制。
来源(2026-11-11,A 级)MiniMax 发布公告 · 模型权重、部署说明与许可。