AI INFRA DAILY 系统 · 工程 · 研究
模型切换前预热 KV,集群发布拆开基础设施与应用
日报 ·
- 推理调度
- 集群交付
- 机器人控制
推理运行时
SHADOWPREFILL|为候选模型预热自己的 KV
Agent 的逐步路由会根据当前任务阶段切换模型。SHADOWPREFILL 利用候选模型可用的推理时隙,以低优先级提前计算当前会话的前缀。切换时复用候选模型自己生成的 KV,接着补算新增内容。预热来不及时,系统走常规冷切换路径。
作者在 16 张 H100 上用 vLLM 回放 FusionBench 和 SWE-bench Verified 的四组模型配对,固定请求与路由,比较开关预热。以 Azure 请求长度分布构造背景流量、到达率为实例容量的 0.3 时,切换调用的首 token 延迟平均降低 61.9%,每任务的 LLM 调用时间平均降低 7.0%。切换占比低、解码时间占主导时,任务层面的收益很小。
来源(2026-11-11,arXiv 新刊,A 级)SHADOWPREFILL 原论文。
NVLinkOneSided|缩短 MoE 小批量的专家通信
MoE 推理会把 token 发给不同 GPU 上的专家,再收回并合并结果。NVLinkOneSided 让发送方直接把 token 写入目标 GPU 上按来源排列的缓冲区,专家计算可从该布局直接读取。两种同步协议分别面向低延迟和高吞吐。
在同一 NVLink 域的 8 张 B300 上,DeepSeek-V4.1-Flash 专家层的通信微基准以每个 rank 一个 token 运行。Sentinel 协议的分发与回收合计 17.4 微秒,DeepEP 基线为 47.9 微秒。这组数字只度量通信,无法据此推算跨 NVLink 域的开销或整模型响应时间。
来源(2026-11-11,arXiv 新刊,A 级)NVLinkOneSided 原论文与附录数据。
AITER 0.1.29|为 gfx1250 增加稀疏预填充路径
ROCm 的 AITER 版本新增 gfx1250 上 MLA v4.1 的 A8W8 稀疏预填充内核,并在这条路径中利用工作组集群合并 split-K 的部分结果。面向 gfx1250 的专用 wheel 构建也纳入了更多该架构的内核。
内核启用取决于设备架构、量化布局和输入形状。升级时应分别检查常用模型是否走到新路径、输出与参考实现是否一致,以及收益是否能覆盖整批请求。发布说明未提供可用于所有模型的端到端对照。
来源(2026-11-09,A 级)AITER v0.1.29 发布记录。
MoE 专家压缩|生成任务要复验输出格式
Hostinger Research 在相同校准数据下比较 REAP 专家剪枝与 REAM 专家合并。两种方法都减少要驻留的专家参数。团队把分类、抽取与生成分开验收,并检查邮件模板的 JSON、移动端布局和重复生成等失败。
在单张 RTX PRO 6000 Blackwell 96 GB 上,团队用 vLLM 0.32 以 BF16 运行模型。Qwen3-30B-A3B 移除 25% 专家时,REAP 保留了原模型 93.6% 的生成任务评分,REAM 为 62.5%。评分来自域名描述与邮件模板两项离线验证,每项 2,000 条,不能据此推算线上流量的结果或推理加速幅度。
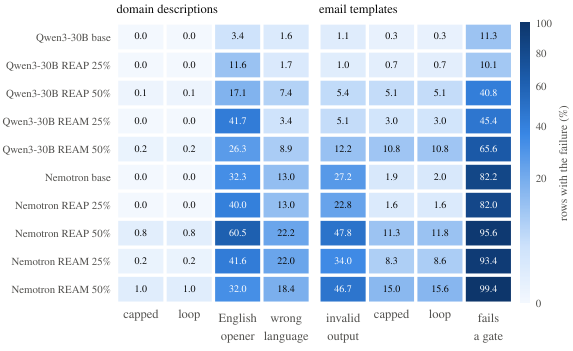
来源(2026-11-10,arXiv 新刊,A 级)MoE 专家压缩论文与图 4。
平台与科研工作流
Meta GitOps|应用晋级从基础设施变更中拆出
Meta 的 Cloud Foundation 团队为 AI 研究与推理维护约 100 个跨云 Kubernetes 集群。新流程继续用 Terraform 管理底层资源,用 Argo CD 同步应用,Kargo 按环境推进版本。Kargo 会把每个应用在目标集群的完整期望状态写回 Git,供审计与恢复。
案例称,常规应用更新过去需要经过统一的 Terraform 流程,从四个多小时缩短到数分钟内完成健康验证。该对照只涉及 Meta 的常规应用发布。集中式 Argo CD 服务仍在建设,推广后的隔离、恢复和漂移修复也在继续验证。
来源(2026-11-11,B 级)CNCF 与 Meta 工程团队案例。
PegasusAI Studio|科研 Agent 沿用用户的调度身份
PegasusAI Studio 在 Pegasus 和 HTCondor 上组织科研工作流,可作为 JupyterHub 网关或 Open OnDemand 应用运行。系统把站点说明、作业状态和调度日志提供给 Agent。提交与修复仍使用用户自己的调度凭证,并遵守用户设置的审批规则。
在事件视界望远镜 M87 图像重建案例中,团队在 SDSC Expanse 上两次遇到输入准备失败。Agent 根据作业日志发现缺失的容器镜像,经用户批准修复构建并重提,最后一次运行没有失败作业。案例展示了日志、授权与重提如何串联,未量化相对人工操作节省的时间。
来源(2026-11-11,arXiv 新刊,A 级)PegasusAI Studio 原论文。
超算与算力设施
Frontier|默认编译与 GPU 运行环境换代
橡树岭领导级计算设施将 Frontier 的默认 HPE/Cray 编程环境切到 26.03,默认 CCE 升为 21.0.4、ROCm 升为 7.0.2,Slurm 更新到 26.05.5。登录环境也把 AMD 代码对象缓存默认指向临时目录,以减轻 RCCL 与 MIOpen 作业并行时共享缓存损坏的问题。
依赖旧默认模块编译的软件需要按迁移说明重建,或显式载入旧的编程环境。新版本支持也要按组件核对。OLCF 已列出 ROCm 7.0.2 可能影响 LAMMPS、NAMD 用户的已知问题。
来源(2026-11-10,A 级)OLCF 默认编程环境变更 · Frontier 系统更新。
Torus Foundry|把推理机房组件做成预制单元
Torus 发布 Foundry,将供电、储能、冷却、网络和算力设备整合成预制单元。厂商计划利用既有商业或工业站点的电网接入条件,借助飞轮与电池承担短时用电峰值,并提供带 GPU 和仅含供电外壳等交付方式。
现有接入点能否承载持续推理负载,仍取决于供电额度、峰值持续时间、散热和网络。厂商公告提供了部署设计与首批客户信息,尚无公开的跨站点负载对照可用来推算吞吐或交付周期。
来源(2026-11-11,A 级)Torus Foundry 发布公告。
机器人与语音产品
Runway Praxis-1|公开机器人动作模型权重
Runway 将 9 月宣布的 Praxis-1 开放下载,发布 Apache 2.0 权重及推理、微调代码。模型把视频预训练用于控制,联合预测后续画面和机器人动作。公开版本包含单臂 DROID、双臂 YAM 检查点,以及用于新设备微调的基础权重。
单臂和双臂版本对应不同的相机、状态输入与动作表示。基础权重未带动作头,换机型仍需要匹配设备配置并重新验证控制效果。公开权重让开发者能在自己的设备上做这些验证。
来源(2026-11-11,A 级)Runway 开放公告 · Praxis-1 原仓库。
DeepL Aure|实时语音翻译随原声更新表达
DeepL 将 Aure 接入在线会议、面对面对话和 Voice API。此前系统用对话开头的语音样本保留说话者音色。新版持续分析源语音,并结合译文调整语速、重音和语气,让表达随对话进程变化。
DeepL 表示符合条件的产品入口会自动启用,首批覆盖英语、德语、日语等八种语言,其他语言沿用既有模型。公告没有公开不同噪声、重叠说话和网络条件下的延迟或准确率对照。
来源(2026-11-11,A 级)DeepL Aure 发布公告。