AI INFRA DAILY 系统 · 工程 · 研究
推测解码按请求分配预算,超算训练让通信缓冲复用显存
日报 ·
- 推测解码
- 分布式训练
- 气象同化
推理调度与后端
ForeSpark|按请求分配草稿与验证预算
推测解码用小模型提出草稿,再让目标模型验证。ForeSpark 在生成草稿前先估计各请求能接受多少 token,联合决定每条请求的草稿长度和全批验证预算。生成草稿后,再按实际置信度决定优先验证哪些位置。
作者用 8 张 H100、vLLM 0.30.0 和 BF16 Qwen3-14B 测试。匹配单用户生成速率时,ShareGPT 纯解码回放的总输出吞吐最高为 DSpark 的 1.77 倍,包含预填充时为 1.53 倍。收益随批大小和预填充占比变化。纯解码实验负载最重时,自回归基线吞吐仍最高。
来源(2026-11-11,arXiv 新刊,A 级)ForeSpark 论文与实验。
tpu-inference 0.33|TPU 推理可切换注意力后端
vLLM 的 TPU 运行时发布 0.33.0。FlyWheel 成为可插拔接口上的首个注意力后端,为常规注意力和 GDN 线性注意力接入 TPU 内核,并支持 FP8 KV 缓存。同一版本也让 Qwen3-Next 和 Qwen3.5 的混合 GDN 模型支持多步继续解码。
FlyWheel 目前限于 torchax,选用 Flax NNX 会在启动时被拒绝。新版 tokamax 专家并行内核也需显式启用。部署时应分开核对模型实现、注意力后端和缓存精度,发布说明里的个别模型回归修复不代表其他配置也会提速。
来源(2026-11-11,A 级)tpu-inference v0.33.0 发布记录。
SGLang on Spyre|复用 PyTorch 硬件实现接入推理
IBM 和 RadixArk 工程团队把 SGLang 接到 IBM Spyre。插件复用 torch-spyre 和既有 vLLM 后端里的算子实现,再通过 SGLang 的设备注册、注意力、KV 池和算子分派接口接入。前缀共享在调度器内完成,原有 RadixCache 逻辑可直接沿用。
团队报告,两名工程师在编码 Agent 辅助下不到一周完成初版。这个案例已有编译器、可运行的后端和参考代码。动态形状支持仍在推进,Triton 支持也在路线图上,移植周期依赖同样的前置条件。
来源(2026-11-12,B 级)IBM 与 RadixArk 工程说明。
训练与平台工程
JUPITER|让 FSDP 缓冲复用计算流显存
EUROPA 团队在 JUPITER 上试跑总参数约 9520 亿的 MoE,每个数据并行副本使用 96 个节点、384 个 GH200。专家并行留在节点内的 NVLink 域,FSDP 跨节点分片。团队将层间激活移到 Grace 内存,缓解长序列训练的显存压力。
FSDP 的通信缓冲原先在侧流分配,空闲块难以供计算流重用。团队提前释放梯度,并在计算流为 all-gather 准备阶段和梯度接收分配缓冲。合并这些改动后,峰值预留显存从 88.1 降到 74.6 GiB,每 GPU 吞吐从每秒 996 升到 1,210 token。这组结果对应 JUPITER 的互连与内存布局。
来源(2026-11-12,B 级)EUROPA 团队在 PyTorch 的技术复盘。
SageMaker HyperPod|从训练循环发现静默错误
AWS 给出 PyTorch DDP 训练中的静默数据错误排查流程。先检查各 rank 和归约后梯度中的非有限值,再用跨节点的环式重算比对结果,最后用权重指纹找出不一致的副本。HyperPod 可将可疑 rank 对应到节点,替换后从可疑窗口之前的检查点恢复。
工程说明以 32 张 H100 运行合成任务,用软件注入错误验证流程。重算有额外开销,抽查间隔也会影响发现时间。对无法归因的告警,团队建议先做节点级健康检查,避免将一次分歧直接判成硬件故障。
来源(2026-11-11,B 级)AWS 检测与恢复说明。
Agent Gateway|跨云预览把策略执行放到集群内
Google Cloud 开放跨云 Agent Gateway 的有限预览。管理面保留注册、身份与策略配置,集群内的 Envoy 代理和身份边车负责执行。EKS、AKS、OpenShift 和裸机等符合 CNCF 规范的集群,可把 Agent 的 LLM、MCP 和 A2A 出站请求交给本地代理。
接入方仍负责转发流量、配置工作负载身份联邦并保持到 Google Cloud API 的连接。验证时需要确认实际请求经过代理,再检查策略结果与日志。有限预览需要申请。
来源(2026-11-11,B 级)Google Cloud 跨云网关架构。
超算与网络
MI430X|公开原生 FP64 与四卡互连设计
AMD 披露 MI430X 的 CDNA 5 节点设计,包括原生 FP64、432 GB HBM4,以及四卡两两直连的 Infinity Fabric 拓扑。目标是让同一节点支持高精度数值模拟与低精度 AI 计算。公告中的性能值来自工程估算,硬件交付仍按各系统的时间表推进。
AMD 的披露援引了在现有硬件上的对照。MI355X 执行 4,096 阶方阵乘时,使用 16 模数的 INT8 Ozaki II 模拟约为同卡原生 FP64 的 1.01 倍,并额外占用 848 MB 工作区。这个结果对应条件数 1,000 的独立矩阵乘,矩阵形状和规模变化后,显存与吞吐的权衡也会变。
来源(2026-11-12,B 级)AMD 节点设计与估算 ·(2026-11-11,arXiv 新刊,A 级)Ozaki II 原论文与表 III。
Uniti 与 Nokia|用一对光纤交付 800GbE 客户接口
Uniti 与 Nokia 在芝加哥至列克星敦之间完成 800GbE 试验,使用 Nokia 1830 GX 和 800GBASE-LR4。试验验证的是客户端交接处可用一对光纤提供完整的 800GbE 接口,有助于简化站点接入布线。
Uniti 预计 2027 年第一季度向客户提供服务。公告没有公布全链路光纤拓扑、实际延迟或跨站训练结果,客户端接口速率只说明接入能力。
来源(2026-11-12,美东日期,A 级)Uniti 投资者公告。
模型接口与科研应用
Gemini Decisions API|同一份多模态输入批量判定
Google 发布 Gemini Decision 1 和 Decisions API。调用方可为同一份文本、图像、音频、视频或 PDF 提出最多 1,000 个彼此独立的封闭式问题,混合是非、选择和量表打分。模型在一次前向中返回候选概率或置信度,适合先做路由和筛选。
接口已通过 Google AI Studio 的 Gemini API 提供,Google Cloud 支持仍在后续。批量能力面向共享输入的独立问题,依赖前一步结果的任务仍需分次处理。置信度阈值也应按自己的业务样本校准。
来源(2026-11-11,A 级)Google 产品公告。
Simons|把已知未来变量纳入分位数预测
Abel AI Lab 开放四个尺寸的 Simons 时间序列模型、训练代码、合成数据生成器和公开训练数据。模型可同时读取历史序列和预测时已经可知的协变量,比如节假日和天气预报。分位数头给出九个分位数,长范围预测分块推进。
GIFT-Eval 和 fev-bench 曾用于模型选择,TIME 没有参与该选择,解读评测时应区分两种证据。权重与代码采用不同许可,公开数据各自保留许可。遇到未来协变量不可得或预测分布漂移时,还要在目标时间序列上检查预测区间覆盖率。
来源(2026-11-11,A 级)Abel AI Lab 发布公告 · Simons 原仓库。
GraphCast 与 MPAS|用学习模型推进集合扰动
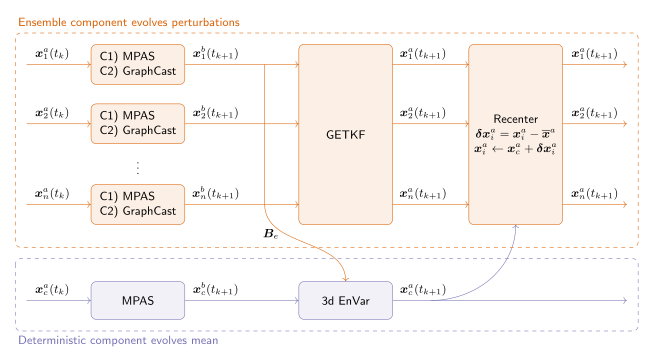
研究团队在气象同化循环中,把 20 个集合成员的预报交给 1° GraphCast,物理模型 MPAS 继续推进确定性预报。MPAS-JEDI 每六小时同化真实观测,包括微波辐射。集合支路估计背景误差协方差,确定性分析则用于将集合重新居中。
在 2018 年春季连续一个月的回放中,对照两路都用 MPAS 的配置,混合方案的集合离散与协方差相近,多数较低层的六小时背景误差下降。模式顶附近误差增大,作者讨论了外推、动力学差异和虚假相关的影响。单月、约 120 公里网格的试验仍属概念验证。
来源(2026-11-10,arXiv 新刊,A 级,近期补充)混合气象同化论文与图 1。